ImIR: 面向全能图像复原的图像指令微调
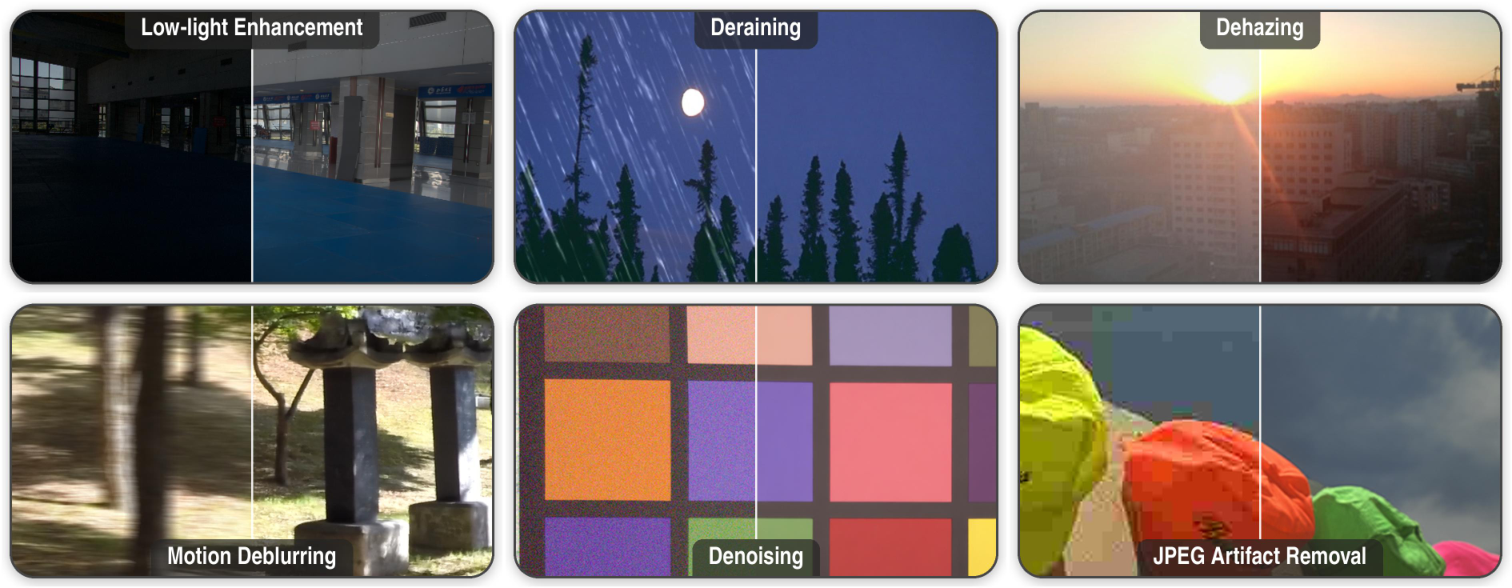
图像退化 类型多样,实际复原系统需要用 单一模型 应对多种退化。近期一个有效方案是:借助小型 低秩适配器 与文本提示,把大型预训练 图像编辑模型 适配到复原任务上。 我们则用 由退化图像自身导出的指令 取代文本提示。图像通过两条路径进入编辑器: - 结构信息 来自模型的 VAE; - 语义指令 来自一个轻量 token mapper,它把退化图像的视觉-语言嵌入向干净图像应有的嵌入方向偏移。 由于该指令是 连续向量,对其缩放即可得到一族有效复原结果,适用于目标不唯一的任务,例如 低光增强。 实验中,我们仅用单个适配器、单张 GPU 约 3 小时 的训练,就把同一个 Qwen-Image-Edit 模型适配到 六项任务。在匹配比较下,图像指令优于文本条件,且无需 退化标签 即可实现任务无关复原——这一点文本版本无法做到。
论文精读
TL;DR ImIR 用从退化图像自身派生的连续指令替代文本提示,微调 Qwen-Image-Edit 单一适配器即可处理六种退化;该指令比文本条件更优,并支持无退化标签的任务无关恢复,单 GPU 训练约三小时。
问题
问题背景
图像恢复领域正从针对单一退化类型(去噪、去模糊、超分等)的专用模型,转向 All-in-One 恢复,即用一个模型处理多种未知退化。这符合实际部署中图像退化类型不可预测的需求。
现有方法局限
近期一种有效方案是将大型 预训练图像编辑模型(如 Qwen-Image-Edit)适配到恢复任务:通过低秩适配器 (LoRA) 和文本提示来指定退化类型(如“去雨”“增强低光”)。但该方法存在明显限制:
- 依赖退化标签或人工文本描述:模型需要知道具体任务才能生成正确的文本条件,无法处理退化类型未知或混合退化的场景。
- 文本条件是离散且粗粒度的:难以对恢复强度进行连续控制,例如低光增强的目标亮度因人而异,文本提示无法提供平滑调节。
- 文本嵌入与图像内容的语义对齐有限:文本描述往往抽象,难以精确捕捉当前图像的具体退化特征,导致恢复效果不理想或产生伪影。
技术挑战与重要性
图像恢复本质是病态逆问题,退化算子 A 未知且不可逆,需要强先验或外部知识来约束解空间。单模型处理多任务要求模型既能理解图像结构,又能辨别退化类型并执行相应恢复,同时避免任务间干扰。此外,实际系统希望免于人工指定任务类型,实现自动、任务无关的恢复。这不仅是学术问题,也直接影响手机摄影、监控、医疗影像、自动驾驶等场景中的图像质量提升,业界对通用、轻量、可控的恢复模型有切实需求。
行业类比
这类似于通用图像编辑中的指令跟随:与其要求用户输入“提高亮度”文本,不如让模型直接从图像自身感知需要何种增强,就像 CLIP 图像嵌入可以驱动生成过程,而无需文本中介。
核心洞察
- 图像指令替代文本提示,使恢复模型无需退化类型标签即可实现任务无关恢复。现有基于文本提示的恢复方法需要明确指定退化类型(如“去雾”或“增强低光”),而 ImIR 直接从退化图像本身提取连续指令向量。该向量由轻量 token mapper 将退化图像的视觉-语言嵌入向干净图像嵌入方向调整,隐式编码了退化信息,因此训练和推理阶段均不需要显式标签,支持单一模型处理多种未知退化,扩展了实际应用范围。
- 连续指令向量的缩放性提供了一种新颖的恢复强度控制机制,这是离散文本提示难以实现的。由于指令是连续向量,对其施加缩放系数可以产生一组有效的恢复结果,适应像低光增强这样目标不唯一的任务。文本提示只能通过更换描述词来离散调整效果,而 ImIR 的连续参数化允许平滑调节增强强度,为交互式应用和用户偏好调整提供了更细粒度的控制接口,这是该方法区别于文本条件恢复模型的重要工程优势。
方法
输入为单张退化图像 y,无需知道退化类型或额外文本提示。
处理流程 分两条并行路径:
- 结构路径:退化图像经 Qwen-Image-Edit 自带的 VAE 编码器 提取视觉结构 token,保留图像布局与细节。
- 指令路径:一个轻量 token mapper 接收退化图像的 vision-language embedding,将其映射为图像指令向量,该向量在嵌入空间中被拉向干净图像对应的 embedding。
两条路径的输出拼接后送入 Qwen-Image-Edit 模型,仅训练一个 LoRA 适配器 完成恢复。训练时在六个退化任务上联合优化,单个 GPU 约三小时完成,损失函数以恢复图像与干净图像差异为监督目标。
由于指令是连续向量,可通过缩放系数控制恢复强度,例如对低光增强任务调节提亮程度。模型同时支持 任务无关恢复:即使不提供退化标签,也能根据图像内容自适应选择恢复行为。
与同类方法的差异点:文本条件恢复需要显式指定退化类型(如“去噪”),而图像指令直接从图像自身推导条件,无需退化标签即可泛化到未知任务。
实验
实验设计
- 基于 Qwen-Image-Edit 骨干,使用 LoRA 进行参数高效适配,并添加轻量 token mapper 将退化图像的视觉-语言嵌入映射到干净图像对应的嵌入。
- 在六种退化类型上训练单一 adapter,训练成本约为单 GPU 3 小时。
- 对比图像派生的连续指令与文本提示两种条件化方式,并在低光增强等目标不唯一的任务上验证连续指令缩放的可控性。
关键发现
- 图像指令优于文本条件化:在 matched comparison 中,图像指令取得更好的恢复效果。
- 支持任务无关恢复:图像指令不需要退化标签即可工作,而文本变体依赖标签,无法泛化。
- 连续指令缩放提供可控性:放大 instruction 向量可产生一族有效恢复结果,适应低光增强等非唯一映射任务。
- 训练成本极低:单 GPU 约 3 小时,工程落地友好。
与基线对比解读
- 文本提示需要显式描述退化类型,因此在 all-in-one 场景中受限;图像指令从输入自身提取语义,天然匹配未知退化。
- 匹配比较表明,即使给文本提示提供正确的退化描述,图像指令仍然更优,说明连续嵌入比离散文本承载更丰富的任务信息。
- 该设计将图像编辑大模型的先验与轻量适配结合,避免了大规模重训练,为多任务恢复提供了高效路径。
行业影响
落地场景
ImIR 将 图像编辑大模型 适配为 All-in-One 图像恢复,单个轻量 adapter 即可覆盖低光增强、去噪、去模糊、去雨等多种退化,无需退化标签或文本 prompt。适合大批量、多类型图像增强的产品线:电商商品图自动美化、内容平台 UGC 图片提质、视频会议实时画质修复、医疗影像预处理等。
商业价值
- 训推成本:单 GPU 约 3 小时训练,LoRA adapter 参数量小,显著降低多模型维护与推理成本。
- 体验提升:连续指令向量支持
scaling强度控制,例如低光增强可调亮度档位,满足不同用户偏好。 - 收入驱动:电商平台更清晰商品图可提升转化;内容平台画质提升可增加用户留存与广告曝光质量。
与现有工作流接口
模型基于 Qwen-Image-Edit 与 VAE,输出可直接接入标准图像处理 pipeline;通过 scaling 参数控制恢复强度。可部署为独立图像增强微服务,接收图像和可选控制强度,无需文本 prompt,支持离线批处理和在线推理,集成成本低。
具体落地 use case
- 电商商品图像预处理:卖家上传的低光、带噪、轻微模糊拍摄图,ImIR 后台自动增强,无需用户选择退化类型,输出质量稳定的商品主图,减少人工修图成本。
- 短视频/直播内容平台:UGC 视频帧常存在低光、运动模糊等混合退化,ImIR 对关键帧批量恢复,改善观看体验,并可调节增强强度避免过度锐化。
局限
- **依赖特定预训练图像编辑模型**:ImIR 完全建立在 Qwen-Image-Edit 之上,其恢复能力受限于该编辑模型对各类降质的理解与生成先验。若底层模型对某些极端退化(如重度运动模糊、复杂混合噪声)缺乏足够表征,图像指令可能无法有效引导恢复;且该模型规模较大(约 8B 参数),推理成本高于轻量判别式恢复网络,限制了在资源受限环境下的部署。
- **图像指令的鲁棒性未充分验证**:论文仅使用常规合成降质(如高斯噪声、模糊、低光)评估,对于真实世界降质或更严重的退化程度(如极低照度、强噪声),从降质图像提取的 vision-language embedding 可能偏离干净图像的 embedding 太远,导致映射器修正困难。任务无关变体虽然不需要降质标签,但在未见降质类型上的泛化能力尚未系统测试,可能无法处理训练分布之外的退化。
- **生成式恢复可能引入伪影或改变语义**:与判别式方法相比,ImIR 依赖生成先验,可能产生与输入不符的纹理或细节,尤其在强退化区域。论文未报告感知指标(如 LPIPS、FID)或用户研究,仅用 PSNR/SSIM 可能不足以证明生成质量。此外,缩放图像指令实现可控性时,缩放因子过大可能导致过度增强或不自然结果,需更精细的控制机制。