LANTERN: 点亮语言模型中隐藏的数学知识
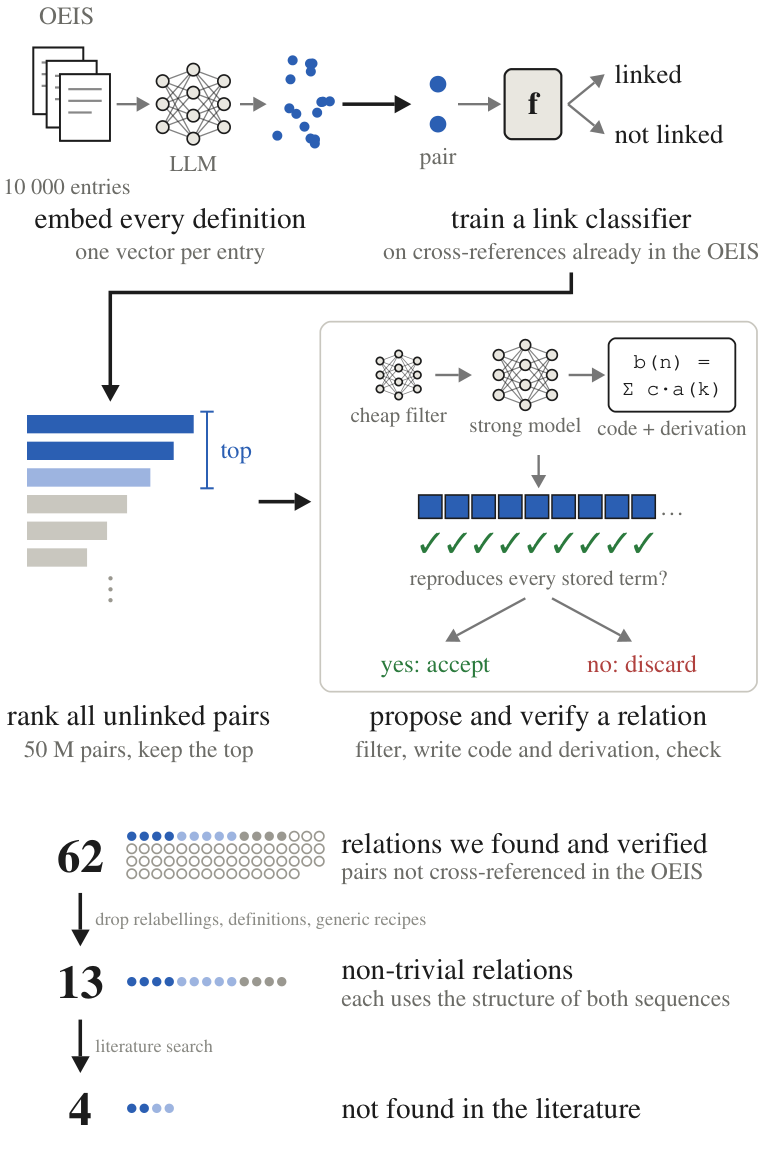
语言模型如今已经能够证明定理,但选择哪些问题值得研究仍由人类决定。我们追问:模型的内部表征能否帮助识别有前景的数学联系?为此我们开发了 LANTERN,一条快速且低成本的流水线:它用分类器作用于预训练模型的激活值,对候选关系进行排序,随后依次进行分阶段过滤、假设生成、可执行验证与分析性检查。 我们将 LANTERN 应用于 On-Line Encyclopedia of Integer Sequences (OEIS),在 10,000 个高频引用序列构成的 5000 万 个序列对中进行排序,最终在原本没有 OEIS 交叉引用的序列对之间得到 62 条 经核实的关系。 1. 内容筛查保留了 13 条 值得展示的关系; 2. 其中 9 条 具有信息量或洞察力; 3. 有 4 条 据我们所知完全新颖——它们既未出现在 OEIS 中,也未出现在我们针对性的文献检索中。 整个端到端流程——包括分类器训练、候选排序、过滤与验证——耗时不到 8 小时。
论文精读
TL;DR LANTERN 利用预训练模型激活分类器快速排序 OEIS 序列对,在 8 小时内从 5000 万对中产出 62 个未记录关系,其中 4 个为全新数学发现,展示了内部表征挖掘数学知识的高效低成本路径。
问题
问题背景
语言模型在数学推理与定理证明上已取得显著进展,但研究方向仍由人类主导。模型内部表示可能蕴含未被显式利用的数学知识,如何从中挖掘有价值的新联系成为前沿课题。
现有方法局限
- 人工驱动的数学发现:依赖专家阅读文献、手动比对序列或公式,效率低且难以覆盖大规模组合。
- 传统 AI 辅助方法(如符号回归、自动定理证明)通常针对特定问题设计,缺乏从预训练模型内部表示中提取通用关联的能力。
- 直接生成式猜想:让大语言模型直接生成新关系受限于训练数据中已存在的模式,难以发现真正新颖且可验证的数学联系。
为什么这个问题难/重要
- 技术挑战:模型激活是高维、噪声多的向量,需要设计分类器快速筛选数千万对候选;数学关系必须经过严格验证,避免错误关联;OEIS 数据库规模庞大,候选对数量达 5000 万。
- 重要性:数学发现是 AI 科学发现的标杆任务,成功挖掘隐藏知识可加速科研探索、降低试错成本,并验证模型内部表示的可解释性与知识存储能力。
行业类比
类似推荐系统从用户历史行为中隐式挖掘偏好,LANTERN 从模型激活中隐式挖掘数学关联,为科学发现提供了一种新的候选生成机制。
核心洞察
- 利用预训练语言模型的内部激活而非生成文本来发现隐含数学关系。与直接让模型生成猜想的做法不同,LANTERN 使用一个轻量分类器对候选序列对的激活表示打分,大幅降低了计算成本并允许并行处理,使 5000 万对的筛选在 8 小时内完成。这种将模型内部表征作为判别信号而非生成引擎的思路,为大规模知识发现任务提供了可扩展的工程范式。
- 将发现与验证解耦,并引入内容分层筛选来识别真正新颖的洞察。同类工作多聚焦于生成式猜想,但缺乏系统性的验证与新颖性分层,导致产出中包含大量平凡或已隐含的关系。LANTERN 先通过可执行验证保证每个输出的正确性,再用分级标准(从平凡到富有洞察力)过滤,最终从 62 个验证关系中仅保留 13 个,其中 9 个具有信息量。这一流程启示实际工程应重视后处理过滤与质量评估,而非单纯追求生成数量。
方法
输入与候选构造
以 On-Line Encyclopedia of Integer Sequences (OEIS) 中 10,000 个高频引用序列为输入,两两配对得到约 50 million 个候选关系对。每个序列条目包含文本定义、数值序列及已有交叉引用。
关键模块
- Embedding: 使用预训练语言模型处理序列条目的文本表示,提取每条序列的激活向量(activations)。
- Link classifier: 训练一个轻量分类器(线性探针或小型 MLP)在这些激活上区分“存在隐藏关系”和“无关”的序列对。利用已有交叉引用作为正例、随机负例进行监督训练,输出一个关系分数,用于对全部 50M 候选对排序。
- Staged filtering: 对排序后的候选对进行多阶段过滤,逐步缩小候选集,剔除明显不相关或低置信度的对。
- Hypothesis generation: 对通过过滤的候选对生成具体数学关系假设(例如序列间的递推、变换或组合恒等式)。
- Executable verification: 将假设转化为可执行代码,在序列的多个项上自动验证是否成立。
- Analytical checking: 对通过验证的关系进行解析检查与内容筛选,评估其数学意义和新颖性。
输出
最终产出 62 条通过验证的关系;再经 Content screen 人工筛选保留 13 条,其中 9 条被认为有信息量或洞察力,4 条为全新发现(未见于 OEIS 或文献检索)。
整条流水线从分类器训练、排序、过滤到验证,端到端耗时不到 8 小时。
与纯 LLM 自动定理证明或基于文本的检索不同,LANTERN 利用预训练模型内部激活作为排序信号,配合轻量分类器和下游形式化验证,实现低成本的超大规模候选关系筛查。
实验
实验设计
- LANTERN 在 OEIS 的 10,000 个高频引用序列上构造 50 million 对候选关系。
- 使用预训练模型激活训练分类器对候选对排序,随后进行假设生成、可执行验证与分析检查。
- 整个流程(含分类器训练、候选排序、过滤、验证)耗时 <8 小时。
关键发现
- 在无现有 OEIS 交叉引用的序列对中,验证 62 条关系;内容筛选保留 13 条值得呈现。
- 其中 9 条具有信息量或洞察力,4 条为全新,未出现在 OEIS 或文献检索中。
- 示例:从一维序列重建二维种群序列(差分平方桥接);一个连分数恒等式计数划分。
与基线对比
- 与人工引导发现及自提议猜想相比,LANTERN 利用模型内部表示而非纯文本或生成式输出,能以低成本挖掘潜在数学连接。
- 相比直接生成验证,分类器排序 + 可执行验证的管线有效降低幻觉,提升候选质量。
- 局限:依赖现有 OEIS 关系和内容筛选规则,可能漏掉部分连接;但 8 小时端到端速度远超传统文献检索或人工筛选。
行业影响
落地场景
数学知识库(如 OEIS)可利用 LANTERN 自动挖掘序列间隐藏关系,补全缺失交叉引用,并为用户推荐潜在研究方向。科研辅助工具可嵌入数学家的工作流,快速筛选海量候选,聚焦高价值猜想。该 pipeline 可泛化至其他序列数据:蛋白质功能域、基因调控序列、金融时间序列等,发现跨域关联。
商业价值
- 降本:人工审查 50M 对需数月,LANTERN 端到端 8 小时完成,显著降低人力与计算成本。
- 增收:学术数据库或科研平台可提供增值服务(如自动发现与验证的“关系推荐”),提升订阅价值。
- 体验提升:研究人员更快获得灵感,缩短从假设到验证的周期,增强产品粘性。
接口与集成
LANTERN 以 分类器 + 过滤 + 验证 的模块化设计,可封装为 API 或微服务。输入序列对或文本定义,输出关系分数与验证状态。可与现有科研搜索引擎(如 Semantic Scholar)集成,作为“关系发现”插件;也可作为 LLM 的外部验证器,过滤幻觉,提升数学推理可信度。
具体 use case:
- 生物信息学:对蛋白质功能域序列对进行关系挖掘,预测潜在相互作用,加速药物靶点发现。
- 企业研发知识管理:分析专利或技术文档中的数值序列,挖掘跨领域技术迁移机会,辅助研发决策。
局限
- 论文在局限性部分承认,内容筛选依赖人工判断,可能引入主观偏差;自动验证虽能确认关系成立,但判断其“新颖性”仍需要人工进行文献检索与评估,因此最终报告的“全新”关系存在一定的确认成本和误判风险。此外,该方法专门针对 OEIS 中整数序列之间的数值关系设计,其迁移到更广泛的数学对象(如群论、拓扑或连续函数)的有效性尚未得到验证,限制了其作为通用数学发现工具的适用范围。
- 从方法设计可推断,分类器的性能高度依赖于预训练模型对 OEIS 条目的覆盖程度。如果某些序列或其相关数学背景在训练数据中出现频率较低,模型激活可能无法提供区分性信号,导致漏检。同时,激活向量的高维特征使得分类器训练需要精心调节,虽然整体流程 8 小时内完成,但模型规模、超参数搜索和验证工具的选型都可能影响结果稳定性,且该方法目前仅在一个特定数据集上测试,泛化性存疑。
- 与 FunSearch 等结合大语言模型的生成式数学发现工作相比,LANTERN 本质上是一个排序与验证管道,它只能从现有序列中挖掘隐藏的等价或转换关系,不能自主提出新的数学猜想或构造新的对象。其发现的关系类型偏向代数恒等式、简单映射等,对于更复杂的结构或需要创造性构造的猜想可能无能为力。此外,验证环节依赖 SymPy 等符号计算工具,超出这些工具能力的猜想无法被自动确认,限制了发现的上限。