VākQA: 面向 Telugu 口语事实型问答的基准与评估研究
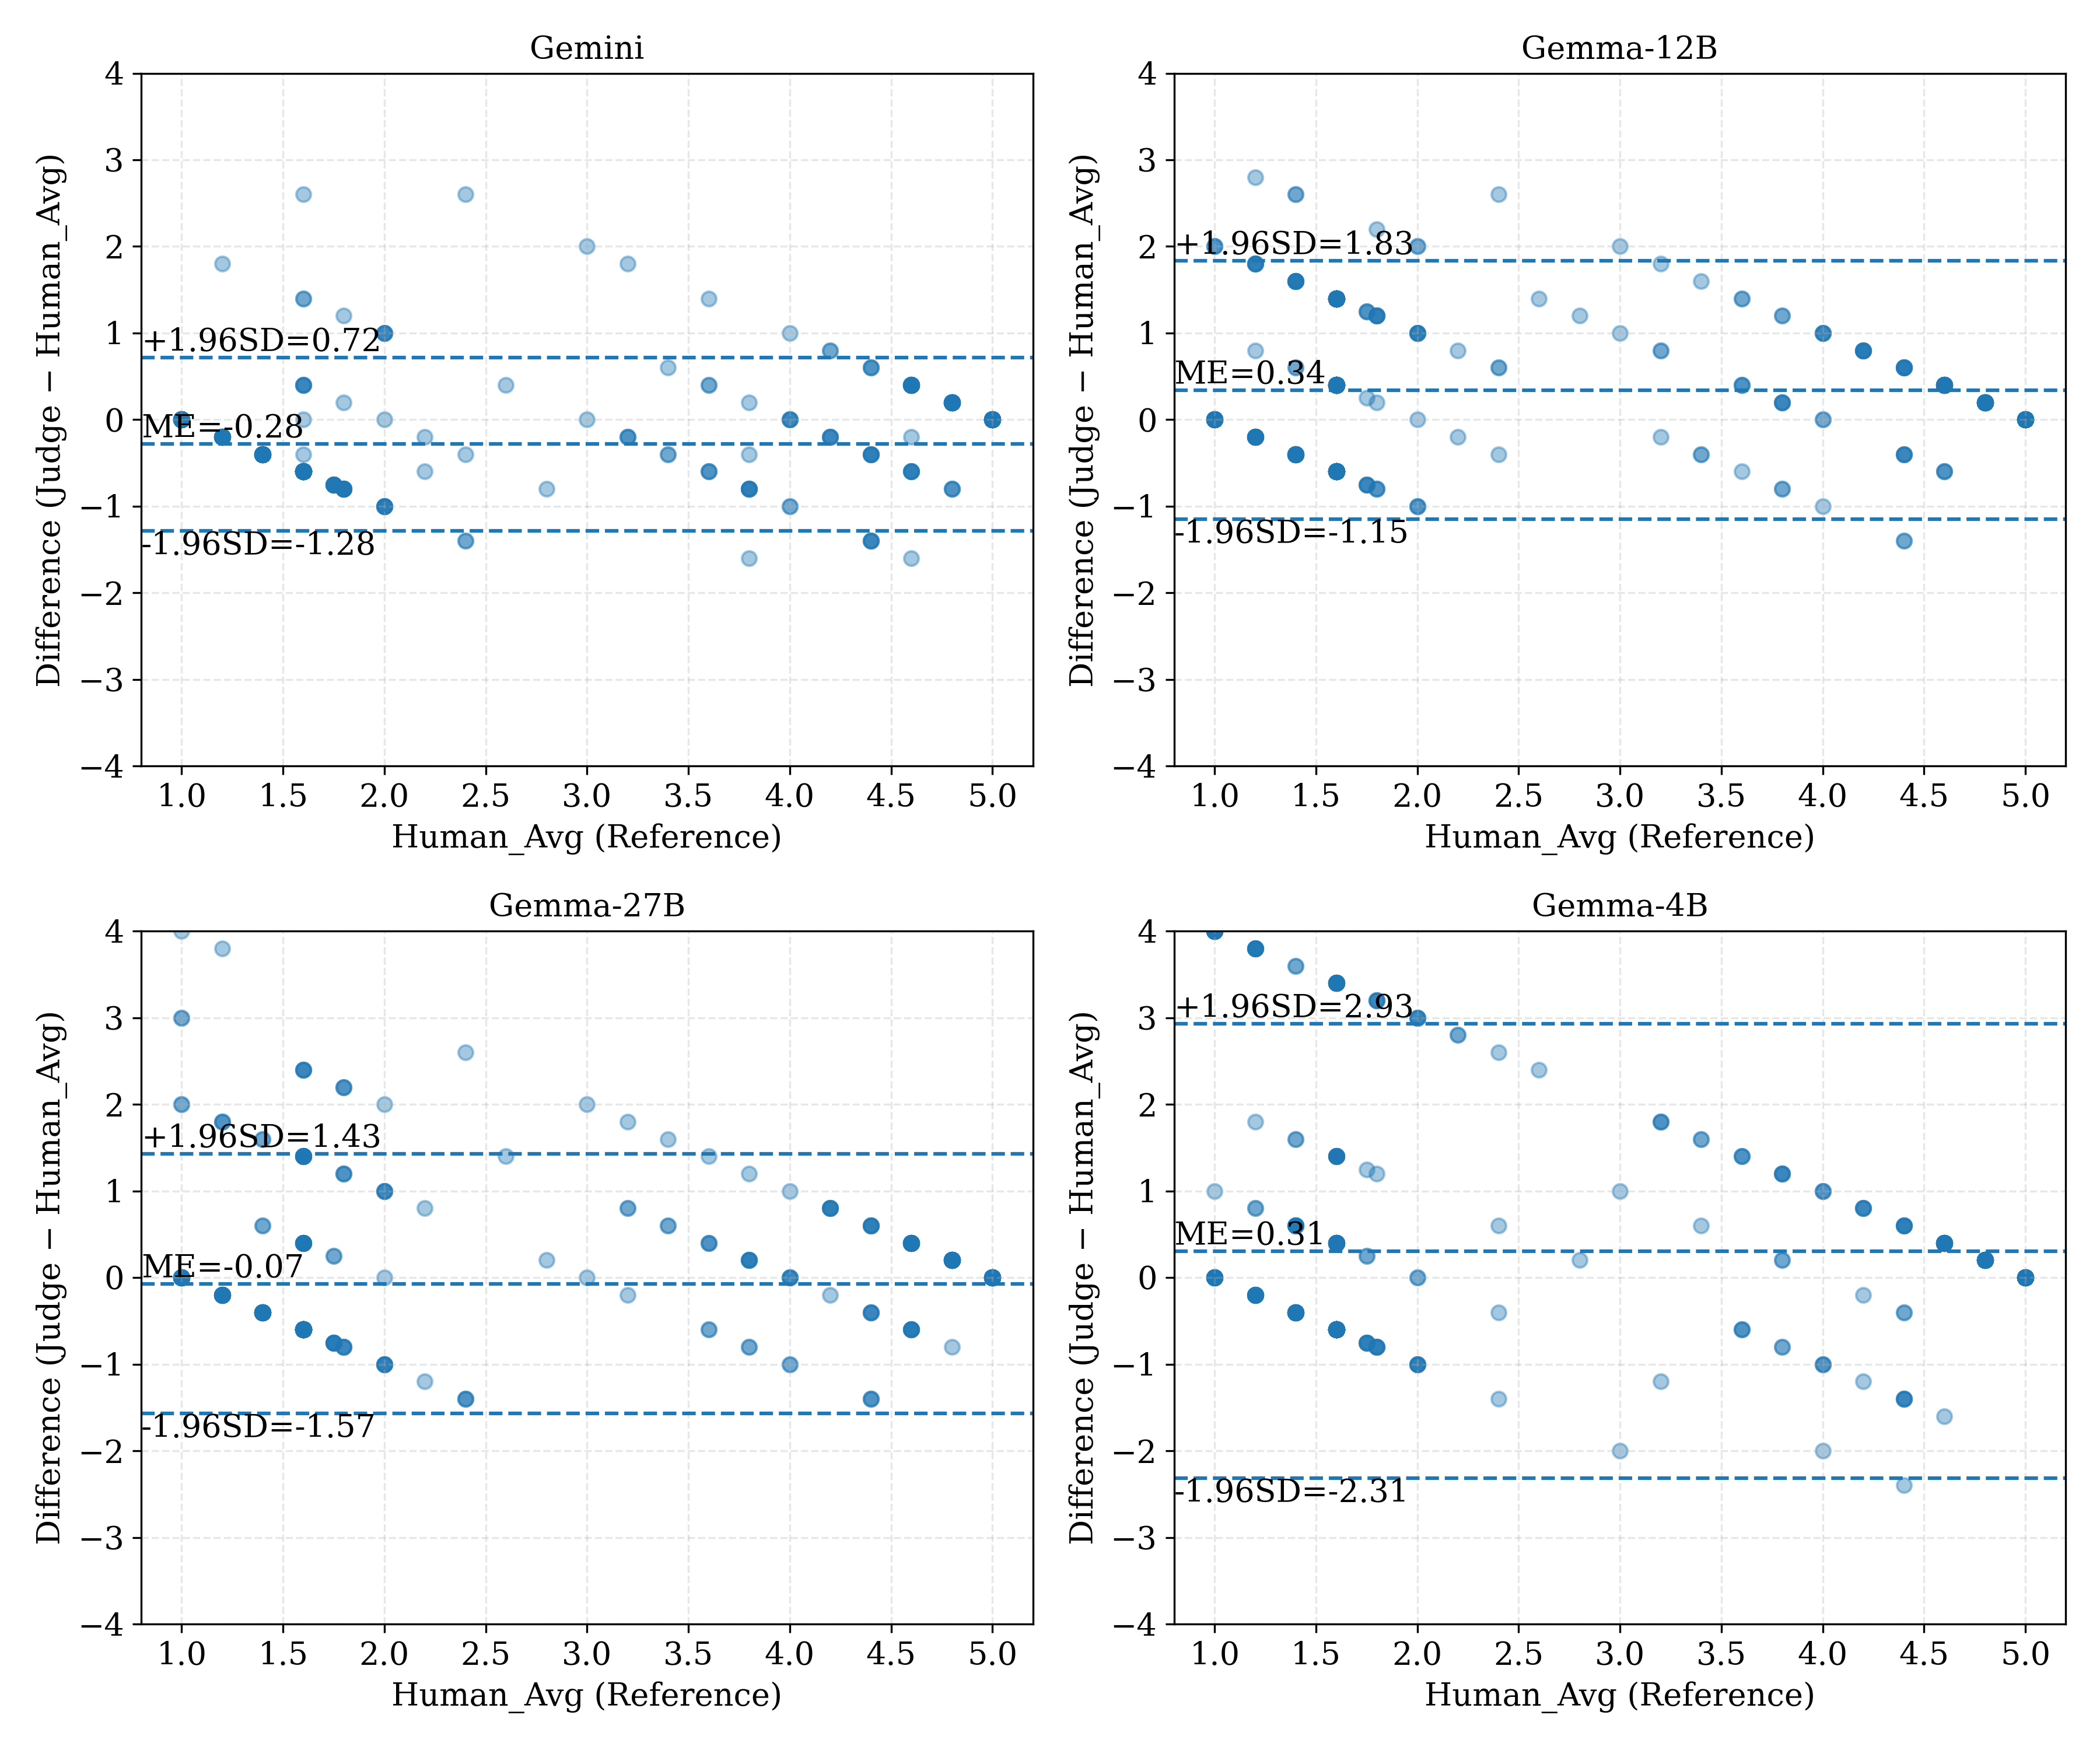
Telugu 口语问答(SQA)基准此前尚属空白,自动评估在该场景下的可靠性也未被量化。本文提出 VākQA,一个包含 2,001 条事实型问答对的 Telugu 口语问答基准,覆盖六个领域,含 2.53 小时语音音频、双语转写文本以及人工核验的参考答案。 研究首先用人工评判验证评估方法: - Gemini-as-a-judge 最接近人工评分,但严格程度不一致; - 开源权重评判模型会系统性地惩罚与参考答案表层形式不同的正确答案。 基于该验证过的评估设置,作者对闭源与开源权重模型在输入模态、语言和领域三个维度上进行了基准测试。主要观察包括:Telugu 表述保留了翻译中丢失的文化特异性;语音输入带来改变问题含义的语音混淆;级联 ASR-MT 误差会逐步累积。VākQA 已公开发布。
论文精读
TL;DR VākQA 是首个 Telugu 口语事实问答基准(2001 对/六领域/2.53 小时音频),用人工判定校准自动评估,并发现翻译损失文化特异性、语音音素混淆和 ASR-MT 级联错误。
问题
问题背景
语音问答(SQA)结合语音理解与事实型问答,大模型推动文本 QA 和语音 QA 快速发展,但基准与评估主要围绕高资源语言。低资源语言如 Telugu 的 spoken QA 仍无公开基准,自动评估可靠性也未量化。
现有方法局限
- 数据层面:现有多语言 QA 基准(如 XQuAD、MLQA、MKQA)多依赖英文源翻译,缺少母语者自然提问,Telugu 文化特定表述在翻译中丢失;
- 评估层面:传统基于表面匹配的指标(
F1、EM)无法处理形态丰富的低资源语言正确答案的多种表述;LLM-as-a-judge 虽被广泛使用,但未针对低资源语言验证。研究发现 Gemini-as-a-judge 与人类判断一致性最高,但严格度在样本间不稳定;开放权重 judge 会系统性地惩罚表面形式不同但语义正确的 Telugu 答案; - 系统级联:语音输入经 ASR 后易产生音近混淆,再经机器翻译或直接 QA 时,ASR→MT 错误会逐步累积,改变问题含义。
为什么这个问题难且重要
低资源语言缺乏大规模标注语音-文本对齐数据,构建人工验证的 SQA 基准成本高;语音信号引入声学变异、口音和同音词歧义,使下游推理鲁棒性更难保证。同时,自动评估不可靠会导致模型对比失真,工程上无法判断优化方向。VākQA 通过 2,001 个跨六领域的事实型问答对、2.53 小时语音和双语转写,首次提供 Telugu SQA 的可靠测试床,并量化了评估方法的偏置,这是多模态低资源 NLP 部署的关键缺失环节。
行业类比
类似多语言语音助手(语音搜索/智能客服)在低资源语言上线时,如果评估指标本身对答案形态敏感,团队可能会错误地压制正确但改写过的回答,导致用户体验下降。
核心洞察
- **低资源语言 SQA 评估** 不能照搬高资源语言的自动指标,需要专门校准 judge 模型。VākQA 验证发现开源评判器会系统性惩罚正确但表面形式不同的 Telugu 答案(如同义改写),而 Gemini-as-a-judge 虽最接近人工评分但严格度不均。因此工程上需用人工子集对评估器做温度或阈值调整,否则基准分数会误导模型选型。
- **语音问答的级联错误具有复合放大效应**:ASR 的音素混淆会改变问题意图,MT 步骤再引入翻译偏差,误差在 pipeline 中累积。与以往仅评估单个环节的方法不同,VākQA 在完整 SQA 链路上量化了这种累加。这提示低资源语言 SQA 应优先探索端到端语音模型,或至少让 ASR 输出携带不确定性供下游使用,避免独立模块的错误叠加。
- **依赖翻译构建多语言 QA 基准会丢失文化特异性**,VākQA 显示 Telugu 问题中的文化表达在英译后丧失语境,导致模型无法利用语言特有背景信息。这区别于 XQuAD、MKQA 等翻译式基准,后者难以暴露模型对源语言真实语义的掌握。工程上构建低资源语言基准应由母语者直接撰写问题,否则基准无法反映真实使用场景,也会低估或高估模型能力。
方法
输入与数据构建
输入为 VākQA 基准:2,001 条泰卢固语事实型问答对,覆盖 6 个领域,附带 2.53 小时语音音频、双语转录和人工校验的参考答案。数据流水线分三步:
- 音频抽取:从公开来源采集原始语音片段,切分为问答对应的短音频。
- 半自动 QA 对提取:先通过规则或模型生成候选问题-答案对,再经人工筛选与修正。
- 双语转录与验证:每段语音提供泰卢固语原文和英语翻译,参考答案由人工确认以保证事实正确性。
关键模块:评估方法验证
在基准模型前,先系统验证自动评估指标的可靠性:
- 对比 人工判断 与多种自动指标(文本相似度、LLM-as-a-judge)。
- 发现 Gemini-as-a-judge 与人工评分相关性最高,但存在非均匀严格性(对某些答案过度惩罚)。
- 开放权重 judge(如 Llama 系列)则系统性低估那些与参考答案表层形式不同但语义正确的泰卢固语答案。
基于此,选定 Gemini-as-a-judge 作为主评估指标,并报告其已知偏差。
输出与基准测试
用验证后的评估协议,对专有模型(Gemini、GPT 等)和开源模型(Llama、Qwen 等)进行跨设置测试:
- 输入模态:语音(经 ASR)vs 原文文本。
- 语言:泰卢固语 vs 英语翻译。
- 领域:六个不同主题。
- 级联错误:分析 ASR→MT 流水线中误差如何逐步累积。
观察结果包括:泰卢固语表达的文化特指性在翻译后丢失;语音输入引起音近混淆改变问题含义;级联错误逐级放大。
与同类方法差异:VākQA 首次为泰卢固语口语事实型问答建立基准,且显式量化了自动评估在该低资源场景下的可靠性,而非直接套用英文基准的评估协议。
实验
实验设计
VākQA 包含 2,001 个泰卢固语事实型问答对,覆盖 6 个领域,配有 2.53 小时 语音音频、双语转写和人工验证参考答案。实验分两阶段:
- 首先以人工判断为参照,验证 Gemini-as-a-judge 与多个开放权重 judge 模型的自动评估可靠性。
- 随后采用通过验证的评估设置,对 proprietary 和 open-weight QA 模型进行基准测试,考察三种输入变体:语音 vs. 文本、泰卢固语 vs. 英语翻译、不同领域。
关键发现
- 评估可靠性:Gemini-as-a-judge 最接近人工评分,但存在非均匀严格性;开放权重 judge 系统惩罚那些语义正确但表面形式与参考答案不同的泰卢固语答案。
- 语言特异性:泰卢固语原始表达保留文化特异性,经英语翻译后会丢失;语音输入引入音位混淆,可能改变问题含义。
- 级联误差:ASR → MT 的错误会逐级累积,导致下游 QA 性能显著下降。
与基线对比解读
与 TyDi QA 等原生多语言文本 QA 基准不同,VākQA 首次将泰卢固语事实型 QA 扩展到 语音模态,并显式量化自动评估在该场景下的可靠性。这一设计暴露了常见 judge 模型在非英语、表面形式变化下的系统性偏差,提示工程实践中不能直接沿用英语场景的自动评估,需引入人工校准或开发多语言感知的 judge。级联误差累积的发现进一步说明,生产系统应联合优化 ASR 与下游 QA,而非简单串接。
行业影响
落地场景
VākQA 面向低资源语言语音问答,可直接服务于:
- 语音客服 / IVR:Telugu 用户的订单查询、账户信息等事实型问答,减少转人工。
- 语音搜索:电商平台口语商品查询、内容平台语音点播。
- 教育科技:口语问答评测与练习系统。
商业价值
- 降低标注与评测成本:可靠自动评测(Gemini-as-judge)替代部分人工评估,加速模型迭代。
- 提升多语言用户体验:切入 Telugu 等低资源语言市场,扩大会话式 AI 覆盖。
- 降低上线风险:用 VākQA 做回归测试,提前发现 ASR 误识别、翻译偏差导致的错误。
与现有产品/工作流的接口
- 集成进 ASR → LLM 问答 pipeline,作为标准 benchmark 做选型与监控。
- 将 Gemini-as-judge 作为自动评分器,结合人工抽检形成半自动化评测闭环。
- 模型选型时对比 speech vs text、translation vs native 配置的 trade-off,参考论文中观察到的文化专有表达丢失和级联错误。
具体 use case
- 电商语音客服:用户用 Telugu 询问『我的包裹在哪里?』,系统将语音转写后回答状态。VākQA 可验证转写错误是否会改变事实答案的正确性。
- 智能音箱 / 语音助手:低资源语言场景下,用户语音查询事实信息(天气、新闻、商品),VākQA 用于评估端到端答案准确率,而非仅看 ASR 的 WER。
局限
- **数据规模与问题类型** 受限。VākQA 仅包含 2,001 条 factoid 问答对和 2.53 小时音频,覆盖六个领域,但所有问题均为可短答案直接匹配的 factoid 类,不含多跳、推理型或对话式问题。语音数据来自单一语言变体,未覆盖 Telugu 方言和噪声场景,这会限制基准的表征力和模型泛化结论。与 TyDi QA 等跨语言 QA 基准相比,缺乏跨语言对照和更大规模的说话人多样性。
- **评测自动化仍依赖闭源裁判**。Gemini-as-a-judge 虽最接近人类评判,但其严格度非均匀且不可复现;开源裁判模型对表面形式不同的正确答案系统性扣分,说明当前语义等价判断对低资源语言不可靠。因此模型分数可能被裁判偏差扭曲,且闭源 API 调用成本高、版本漂移,不利于长期基准维护和社区复现。
- **级联错误分析缺少直接缓解方案**。论文观测到语音输入引入的音位混淆及 ASR→MT 错误逐步累积,但主要停留在事后诊断,没有在基准中内置错误分类标注或提出端到端鲁棒训练方法。领域间性能差异虽被报告,但未与数据稀疏度、口语表达复杂度等可量化因素关联,对工程选型的指导强度有限。