DeepSeek-V4.1-Flash:突破 KV Cache 压缩的极限
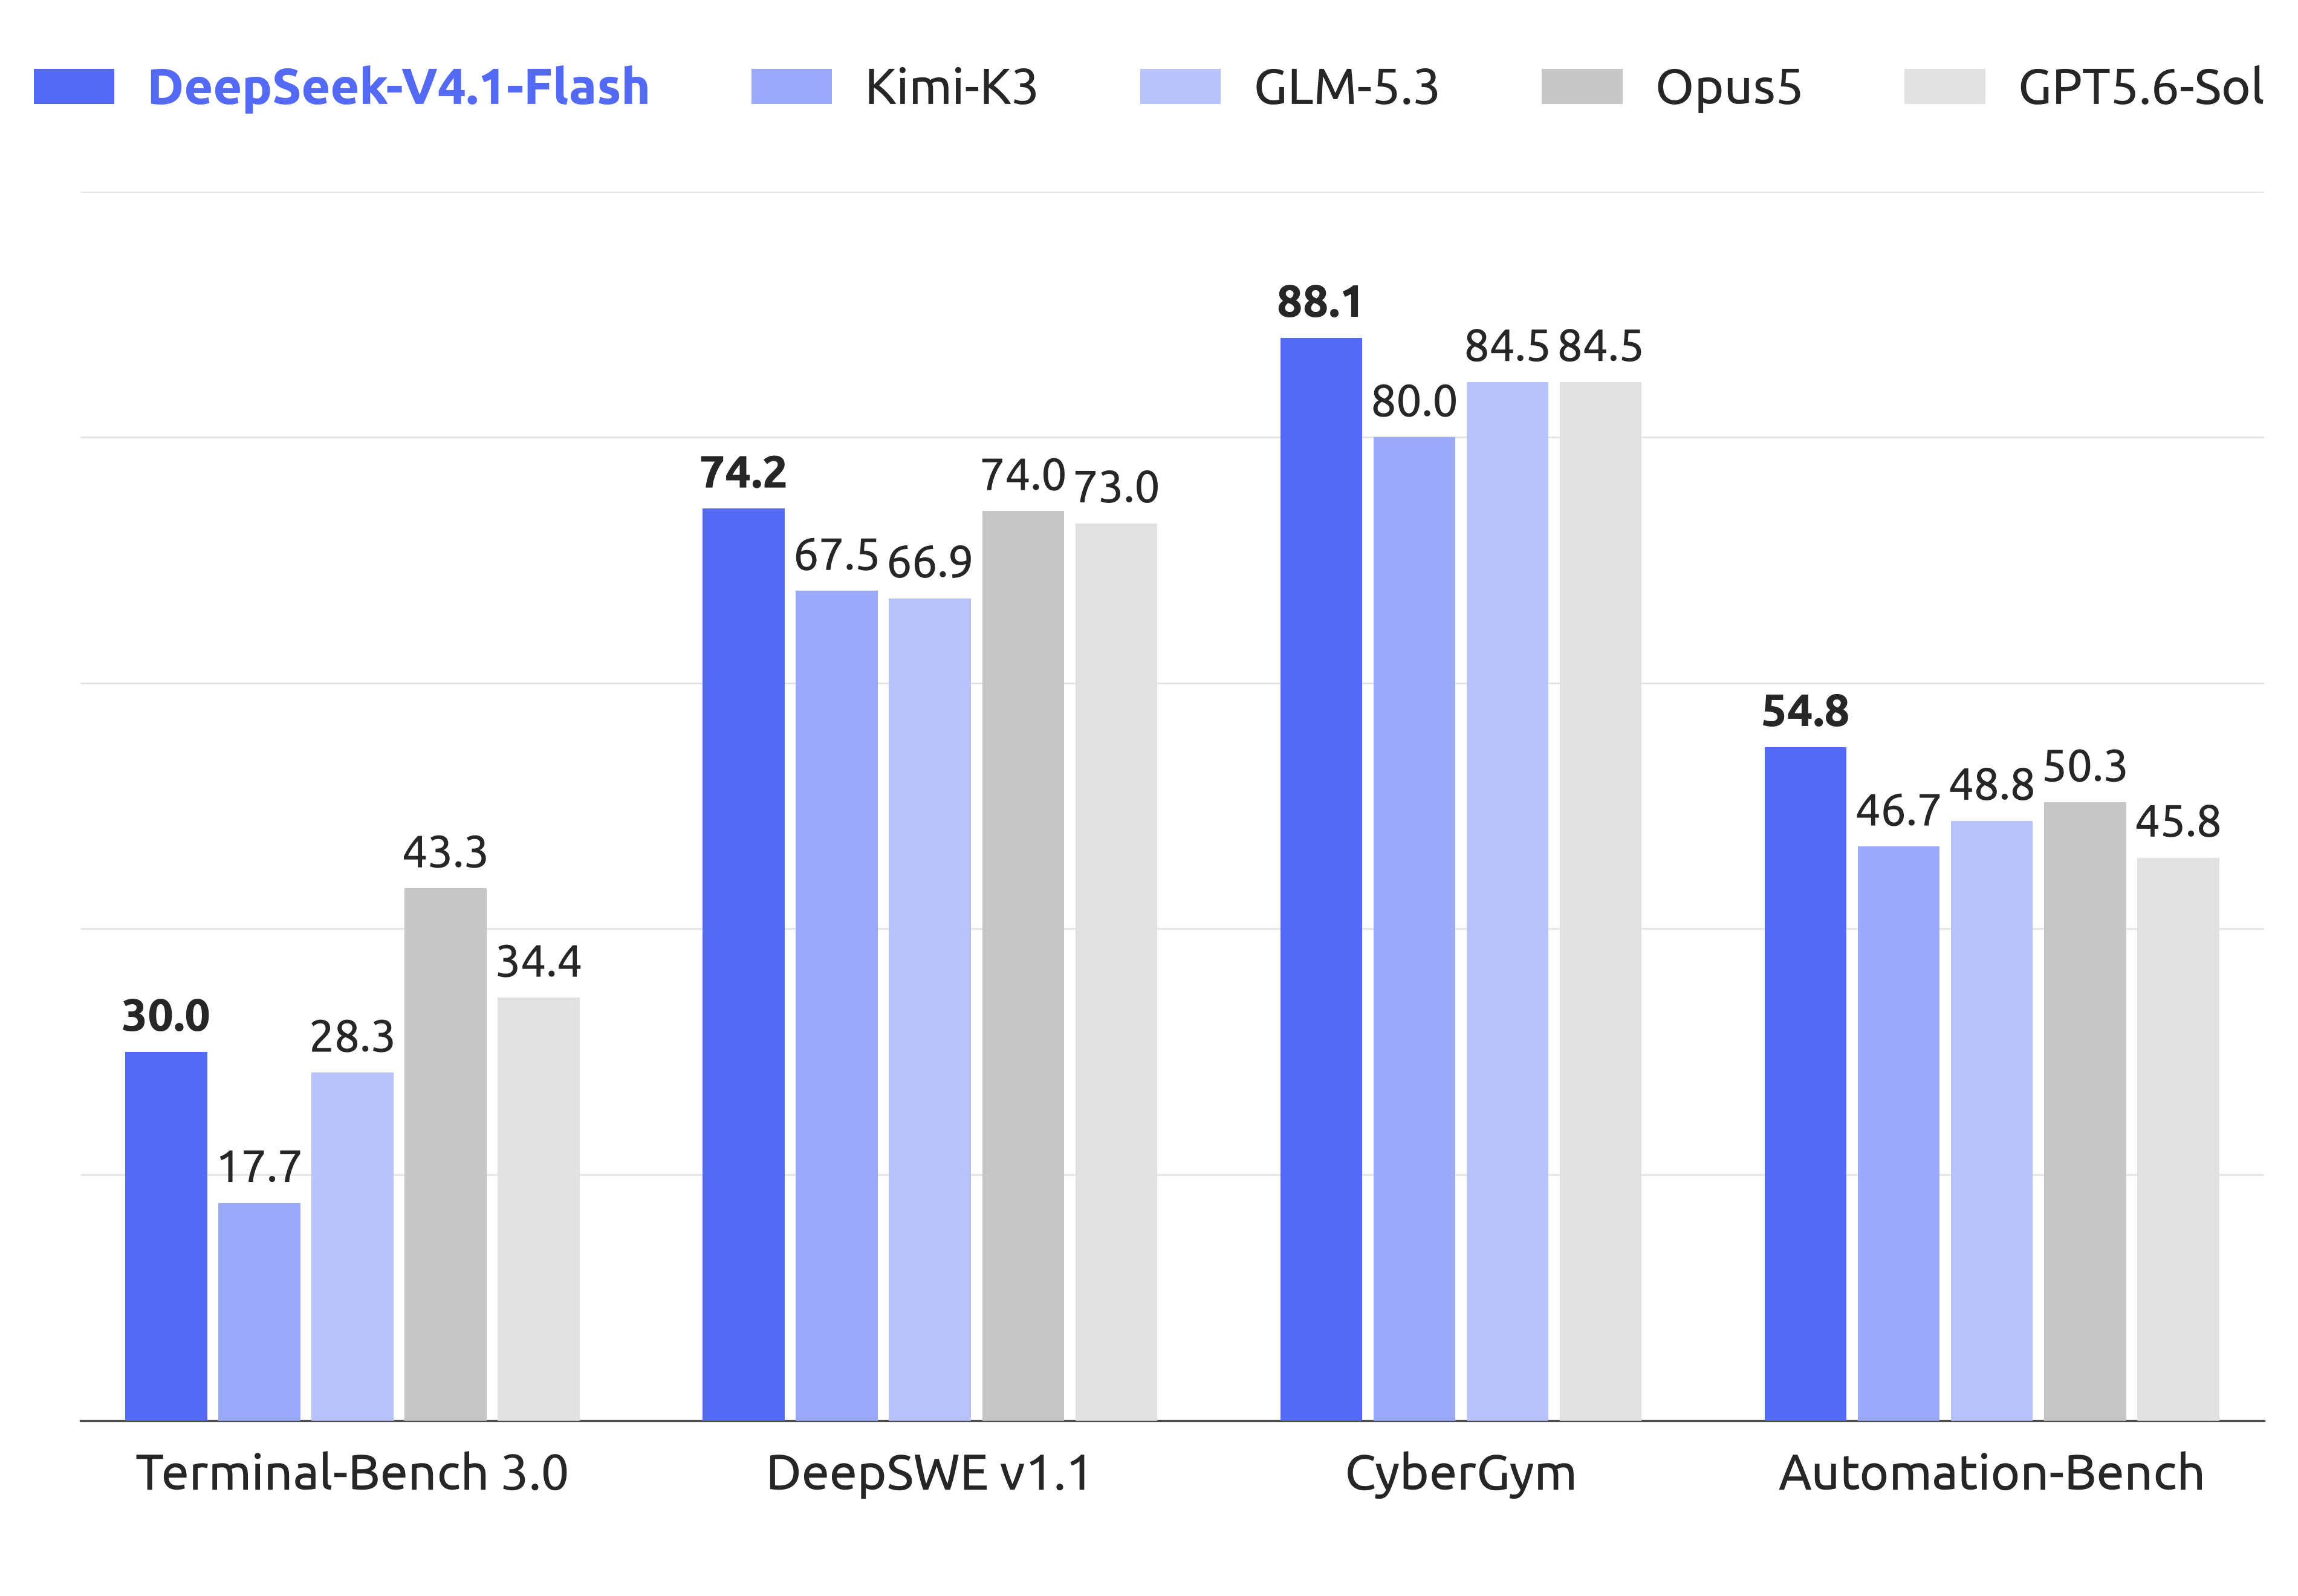
长程 agent 的广泛采用,使模型工作负载日益输入密集。尽管此前工作已大幅降低长上下文计算成本,prefill 的开销依然高昂,庞大的 KV cache 也持续挤占 HBM 与 SSD 容量及数据传输带宽。算力、存储与带宽这三重需求共同构成了进一步降低部署成本的主要瓶颈。 为此,我们提出 DeepSeek-V4.1-Flash,一个多模态 Mixture-of-Experts (MoE) 模型:主干参数 552B,支持最长 100 万 token 的上下文。借助 Causal Encoder-Decoder (CED) 架构,模型在 decode 阶段每 token 激活 16B 参数,而 prefill 阶段仅激活 8B,显著提升了 agentic 工作负载的成本效率。 为突破 KV cache 压缩的极限,该模型将 Compressed Sparse Attention 2 (CSA2) 中的跨层 KV cache 复用与 FP4 KV 缓存 相结合: - 全局 KV cache 占用(常驻 HBM)降至每 token 890 bytes,约为 DeepSeek-V4-Flash 的 1/4; - 借助名为 SWA Bounded Replay 的部署优化,持久化 KV cache 占用(常驻 SSD 或 host 内存)降至后者的约 1/8。 尽管 KV cache 占用大幅缩小,模型性能仍显著优于 baseline。我们还精简了 DeepSeek-V4 架构,并引入多项高效的架构扩展。DeepSeek-V4.1-Flash 在包含 45T tokens 的多模态语料上完成预训练,并经过充分的后训练,在多样化的纯文本与多模态 agentic 场景中均表现强劲。模型 checkpoint 见 https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash。
论文精读
TL;DR DeepSeek-V4.1-Flash 通过 Causal Encoder-Decoder 架构与 CSA2 交叉层 KV 复用 + FP4 量化,将 1M 上下文 MoE 模型的 KV 缓存压至每 token 890 字节,全局与持久足迹分别降至前代的 1/4 与 1/8,同时性能反超基线。
问题
问题背景
长上下文推理已成为 agent 工作负载的核心,模型需要处理超长输入序列,导致推理成本中 prefill 和 KV cache 内存占用成为主要瓶颈。
现有方法局限
- 传统 KV cache 压缩(如量化、稀疏化)主要减少存储量,但未解决 prefill 阶段的高计算开销。
- MoE 模型通常 prefill 和 decode 激活相同参数,对于输入密集的 agent 任务,prefill 计算浪费。
- 大 KV cache 即使压缩后仍占用大量 HBM/SSD 带宽,跨层注意力模式未被充分利用。
- 现有方法在压缩比和性能损失之间难以平衡,往往导致长上下文任务性能下降。
为什么这个问题难/重要
- 技术挑战:需要在架构设计(如 CED 减少 prefill 激活)、注意力机制(如跨层 KV 共享)、量化(FP4)和部署策略(SWA Bounded Replay)等多个层面协同优化,同时保持模型性能。
- 业界关注度:随着 1M 上下文模型进入实际部署,KV cache 容量和带宽成本成为决定服务可行性的关键因素,直接影响单位 token 经济性。
行业类比
类似于视频流媒体服务中,为了支持高并发长视频播放,必须同时优化解码计算和缓存分发,以降低单路流成本。
核心洞察
- DeepSeek-V4.1-Flash 的 Causal Encoder-Decoder (CED) 架构将 prefill 与 decode 的参数激活量分离,prefill 仅激活 8B 参数而 decode 激活 16B,针对输入密集的 agentic 负载显著降低 prefill 计算成本。传统 decoder-only MoE 在 prefill 和 decode 阶段激活相同参数,导致长上下文 prefill 成为部署瓶颈;而 V4.1-Flash 解耦后,prefill 算力需求减半,使模型在百万 token 上下文中更高效,尤其适合大量重复访问长上下文的 agent 应用。
- CSA2 的跨层 KV cache 重用结合 FP4 量化,将全局 KV cache 足迹压缩至 890 字节/ token,约为 V4-Flash 的 1/4,同时性能反超。与单纯采用 KV 量化(如 FP8/INT4)或稀疏注意力压缩不同,CSA2 通过跨层共享索引和值,从结构上消除冗余,再叠加 FP4 低精度,实现了 4 倍压缩率而无需牺牲长上下文检索质量,为 HBM 容量受限环境提供了新路径。
- SWA Bounded Replay 通过限制持久 KV cache 的滑动窗口重放,将 SSD 或主机内存上的持久缓存足迹降至约 1/8,解决了长上下文 agent 反复访问历史 token 导致的存储带宽瓶颈。相比现有方案依赖全量缓存或简单驱逐,该方法在保证可回溯性的同时大幅降低持久层 I/O 压力,使百万 token 上下文的批量部署在存储成本上变得可行。
方法
方法流程
输入:面向长程 agent 场景的多模态序列(文本与图像),最长上下文 1M tokens,工作负载呈输入密集特征。
关键模块:
- CED 架构:Causal Encoder-Decoder 将预填充与解码阶段解耦,预填充仅激活 8B 参数,解码激活 16B,显著降低输入处理成本。
- CSA2:Compressed Sparse Attention 2 引入跨层 KV 与索引复用,配合层级稀疏索引器压缩注意力状态,避免为每层独立存储完整 KV。
- FP4 KV 缓存:主 KV 缓存采用 4-bit 量化,配合跨层复用,将全局 KV(常驻 HBM)压缩至每 token 890 字节,约为 DeepSeek-V4-Flash 的 1/4。
- SWA Bounded Replay:部署优化将持久 KV(SSD 或主机内存)进一步压缩至基线 1/8,控制长上下文的存储与带宽。
- 高效扩展:Single-Pass mHC、Engram、DSpark 等模块简化架构,提升训练与推理效率。
输出:一个 552B 参数的 MoE 模型,在低缓存占用与低激活开销下支持长上下文多模态 agent 任务。
与同类方法相比,DeepSeek-V4.1-Flash 通过 CED 的预填充轻激活与 CSA2+FP4 的激进 KV 压缩组合,在 KV 缓存仅为基线 1/4 的条件下实现了更强的智能体性能。
实验
实验设计
摘要未给出具体 benchmark 名称,强调在多种文本与多模态 agent 场景下评估。模型采用 CED 架构,支持 1M token 上下文,预训练语料 45T tokens;评估可能涵盖长上下文推理、agent 工具调用、多模态任务。部署层面测试了 全局 KV 缓存(HBM 常驻)与 持久化 KV 缓存(SSD/宿主内存)的占用。
关键发现
- 通过 CSA2 的跨层 KV 复用与 FP4 KV 缓存,全局 KV 缓存降至 890 bytes/token,约为 baseline 的 1/4。
- 利用 SWA Bounded Replay 部署优化,持久化 KV 缓存降至 baseline 的约 1/8。
- 尽管缓存大幅减小,模型性能「substantially better than the baseline」(摘要原文)。
- 解码时每 token 激活 16B 参数、预填充时仅 8B,提高 agent 工作负载成本效率。
与基线对比解读
与 DeepSeek-V4-Flash 对比,KV 缓存缩减至 1/4(全局)和 1/8(持久化),同时未牺牲性能反而更好,说明缓存压缩技术是效率与效果兼得的工程路径。CED 架构将 prefill 与 decode 激活参数解耦,对输入重度、输出相对稀疏的 agent 负载尤其有利。但摘要未提供具体 benchmark 分数,无法量化性能提升幅度;后续需关注论文完整版中的详细对比。
行业影响
落地场景
DeepSeek-V4.1-Flash 面向输入密集型长智能体工作流,适合需要处理百万 token 上下文的场景:
- 企业知识库问答:分析 1M token 项目文档,回答跨文档技术问题。
- 电商客服:结合长对话历史与商品图片,提供个性化退货建议。
- 金融分析:解析长报告与图表,自动生成摘要与风险提示。
- 代码助手:阅读整个代码仓库,定位 bug 或解释架构。
商业价值
降本为主:decode 阶段每 token 激活 16B 参数,而 prefill 仅 8B,降低首 token 延迟与计算成本;KV cache 全局占用降至 890 bytes/token(约 1/4),SSD/主机内存持久占用降至 1/8,显著减少 HBM 与带宽压力,允许单卡服务更长上下文或更多并发请求。体验提升:百万 token 上下文避免截断,多模态输入扩展应用范围。
与现有工作流集成
- 权重已开源在 HuggingFace,可直接替换 DeepSeek-V4 系列。
- 推理框架需支持 CED 架构、CSA2 跨层 KV 共享与 FP4 KV cache,建议基于 vLLM/SGLang 定制;持久 KV 使用 SWA Bounded Replay 优化。
- 对现有多模态 MoE 服务,需扩展 KV cache 管理模块,但接口兼容 standard API。
具体 use case:
- 电商平台客服机器人:处理长对话历史+商品图片,模型在 1M token 上下文中准确定位之前提到过的尺码/材质,提供连贯咨询;由于 KV cache 压缩,单卡可承载更多客户会话,显著降低部署成本。
- 企业级代码审查工具:对百万 token 代码仓库做全库理解,快速回答架构问题或定位 bug,prefill 低成本适合频繁重新索引代码库。
局限
- **场景专一性较强**。模型针对长 horizon agent 工作负载做了深度优化,但论文未充分论证其在短上下文、非 agentic 任务上的竞争力;例如普通对话或代码生成中,CED 架构与 KV cache 压缩带来的收益可能被额外复杂度抵消,其性能优势需在更广泛基准上进一步验证。
- **FP4 KV cache 的量化风险**。虽然 FP4 将 KV 缓存压缩到约 890 字节/token,但量化精度损失在需要精确注意力得分的长程依赖任务上可能不可忽略;论文未给出 FP4 与 FP8/FP16 在关键任务上的对比消融,实际部署中可能需要动态混合精度策略。
- **训练与部署成本高昂**。45T tokens 的多模态预训练与大规模 RL 后训练需要海量算力,模型规模达 552B,对多数团队不可复现;此外,SWA Bounded Replay 等推理优化依赖定制系统,通用推理框架(如 vLLM)目前缺乏原生支持,限制了快速推广。