CERA-MoA:协同演化路由机制与持续学习的 LLM Agent
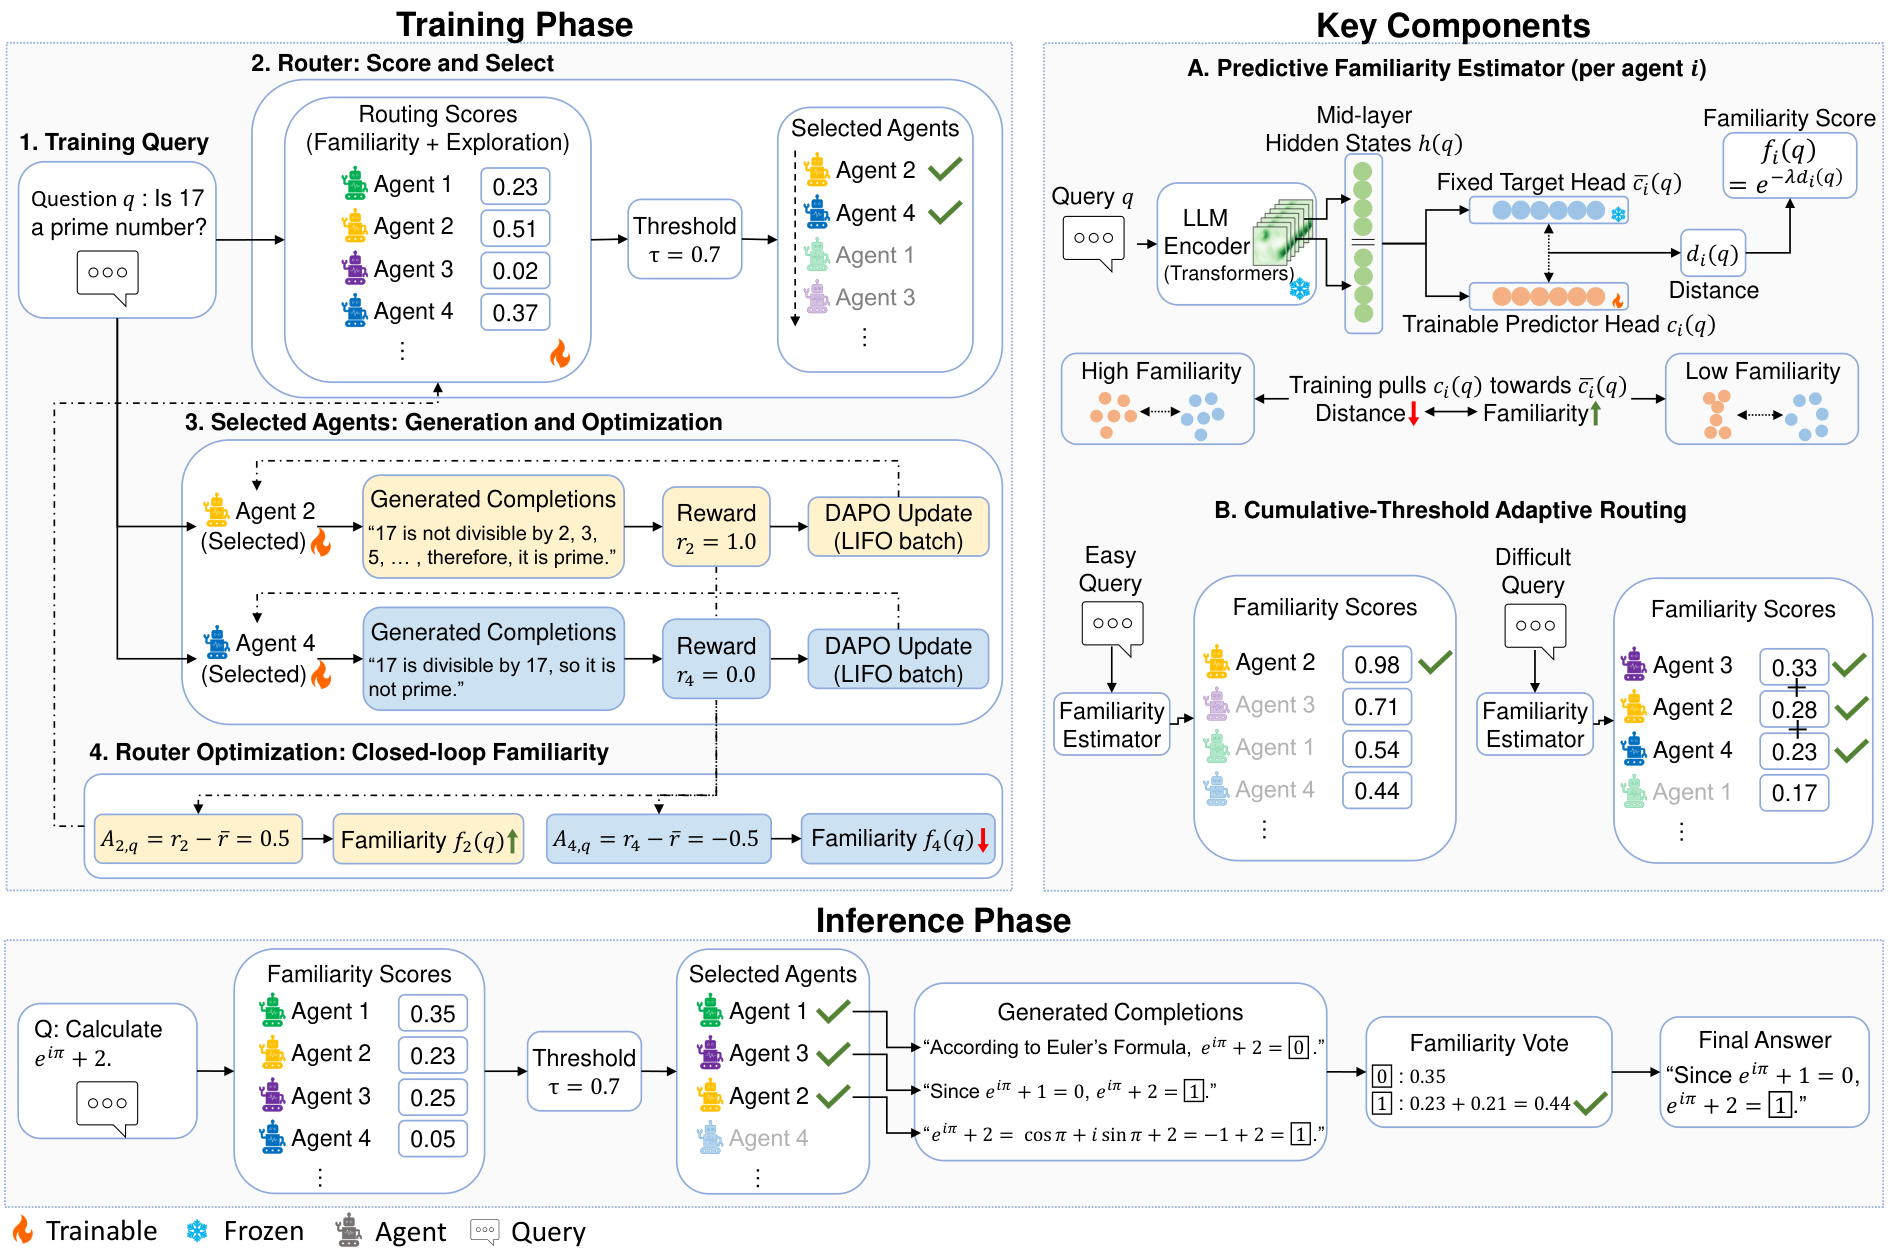
当前 Mixture-of-Agents (MoA) 范式通常把查询路由与 agent 微调视为两个相互独立的过程,限制了其响应 agent 能力演化的能力。这种割裂使路由策略无法在 post-training 期间适应 agent 能力的持续变化,也阻碍 agent 通过数据驱动实现协同式的专精化。 为此,作者提出 CERA-MoA(Co-Evolving Router with continually learning Agents for Mixture-of-Agents),一个迭代式强化学习框架,让动态 router 与各独立 agent policy 协同演化。其核心设计包括: - 预测式熟悉度估计器:利用中间层 hidden states 评估各 agent 的语义能力,免去完整 rollout 带来的开销; - 累积阈值自适应路由机制:依据熟悉度分数动态激活定制化的最小 agent 子集,在任务性能与效率之间取得平衡; - 基于 agent 不断演进的能力,主动为其分配针对性训练样本,推动能力分化。 在多个领域的大量实验表明,CERA-MoA 优于当前最优的静态 agent 路由与固定 workflow 微调基线。
论文精读
TL;DR CERA-MoA 让动态路由机制与多个 LLM agent 在迭代强化学习中共同进化,用隐藏状态预测熟悉度并自适应激活最小 agent 子集,兼顾任务性能与推理效率。
问题
问题背景
多智能体 LLM 系统(Mixture-of-Agents, MoA)通过组合多个专家模型提升复杂任务表现,当前研究聚焦于如何动态路由查询到最合适的 agent 子集,并让 agents 获得差异化能力。
现有方法局限
- 路由与微调解耦:现有 MoA 范式通常将 query routing 和 agent fine-tuning 作为两个独立阶段。路由策略基于初始或静态能力评估,无法感知后续微调带来的能力变化,导致路由决策过时。
- 评估开销高:主流路由依赖完整 rollout 或输出置信度来评估 agent 对 query 的适应性,计算成本高,难以频繁更新。
- agent 能力同质化:微调阶段缺乏针对性的数据分配,所有 agents 使用相似训练信号,无法形成专业化分工,削弱了 MoA 的组合优势。
为什么这个问题难/重要
- 技术挑战:需要在不执行完整推理的前提下,高效预测 agent 对 query 的语义熟悉度;设计能随训练动态调整的阈值路由策略;并同时优化离散路由决策与多个强化学习策略,涉及稀疏奖励与探索-利用平衡。
- 业界关注:多智能体推理、代码生成等场景中,路由效率与任务性能的 trade-off 直接影响部署成本与响应延迟。若路由无法适应 agent 能力演化,模型迭代后需要重新设计路由,运维负担大。
行业类比
类似云原生微服务架构中的动态负载均衡:请求路由既要考虑当前节点负载,也要根据节点实时处理能力调整流量,同时节点自身也在持续更新版本、提升性能。
核心洞察
- CERA-MoA 的核心洞察是将查询路由与智能体微调从分离过程转变为协同进化的强化学习框架,使路由策略能够动态适应不断变化的智能体能力。 与现有工作将路由设计视为固定模块或独立于智能体训练不同,该框架通过迭代联合优化,让路由器与智能体策略在训练中相互塑造,解决了能力漂移导致的路由失效问题,也为智能体的数据驱动专业化提供了结构性支持。
- 另一个关键创新是利用预测熟悉度估计器,通过智能体中间层隐藏状态评估对查询的语义胜任度,从而避免完整 rollout 的高昂开销。 传统方法往往依赖完整推理结果或静态规则进行路由,无法兼顾效率与动态适配。该估计器以轻量级特征提取实现近乎零额外成本的能力评估,为累积阈值自适应路由和针对性训练样本分配提供了核心信号,是框架高效协同进化的技术基础。
方法
输入与特征提取
CERA-MoA 接收用户 query 作为输入,先通过共享 LLM 编码器提取中间层隐藏状态,作为后续估算的依据。Predictive Familiarity Estimator 利用这些隐藏状态计算 query 对每个 agent 的 familiarity score,用来衡量语义能力匹配程度,避免完整 rollout 的高开销。
核心模块:自适应路由与联合优化
- Cumulative-Threshold Adaptive Routing:根据
familiarity scores计算累积值,当超过阈值时激活相应 agent,动态选择最小且足够的 agent 子集,在任务性能与效率之间取得平衡。 - Exploration-Augmented Query Routing:训练阶段加入探索机制,防止路由策略过早收敛到局部最优。
- Agent Optimization:根据 agent 当前能力估计,主动分配针对性训练样本,促进不同 agent 的能力分化。
- Router Optimization:以 agent 响应质量和计算开销作为奖励信号,迭代更新动态路由策略。
输出与训练流程
CERA-MoA 采用迭代 RL 框架:每轮先固定 router 更新 agent 策略,再固定 agent 更新 router,最后输出一组具备差异化能力的 LLM agents 和一个协同进化的动态 router。推理时,router 对每个 query 动态选择 agent 子集并进行共识聚合。
与静态路由 MoA 和固定工作流微调相比,CERA-MoA 的核心差异在于让 router 与 agent 策略在同一个强化学习循环中相互适应,持续应对 agent 能力漂移。
实验
实验设计
CERA-MoA 在数学推理、代码生成、指令跟随与通用推理等多个领域进行评估,代表性数据集包括 GSM8K、MATH、MBPP、HumanEval 与 BIG-bench Hard。基线分为两类:静态 agent 路由(固定 Top-K 或预设工作流)和固定工作流微调。训练采用迭代强化学习,router 与 agents 联合优化;测试指标覆盖任务性能与推理效率(如激活 agent 数量、延迟)。
关键发现
- CERA-MoA 在所有测试域上均优于 最先进的静态路由与固定工作流微调基线(原文摘要结论,无具体量化值)。
- 预测熟悉度估计器 利用 mid-layer hidden states,免去 full rollout 开销,高效评估 agents 的语义能力。
- 累积阈值自适应路由 根据 familiarity scores 动态激活最小 agent 子集,在性能与计算效率之间实现平衡。
- 主动定向样本分配基于 evolving competence,推动 agent 能力分化,形成协同专业化。
对比解读
传统 MoA 将 query routing 与 agent fine-tuning 分离,导致路由策略无法跟上 agents 后训练能力变化;固定工作流微调则限制 agent 间动态组合。CERA-MoA 的 co-evolution 机制让 router 与 agents 在同一 RL 循环中互相适应:router 学会选择当前最胜任的 agent 子集,agents 则为被路由的任务强化差异化能力。与需要完整 rollout 的 routing 方法相比,预测熟悉度估计器 大幅降低推理开销,更适合在线或大规模部署。不过,摘要未给出具体提升百分比或绝对分数,需查阅论文实验表获取精确指标。
行业影响
落地场景
CERA-MoA 适用于多智能体 LLM 应用中负载动态变化、需要细粒度路由的场景,如 智能客服系统、代码生成辅助、内容审核流水线。典型 use case:电商平台客服工作流中,售前咨询、售后服务、商品推荐分别由不同专业 agent 处理,CERA-MoA 的路由器基于问题语义与中间层 familiarity 分数动态激活最小 agent 集合,避免全量调用。另一个场景是企业级 RAG 系统:多个检索 / 生成 agent 负责不同数据源或业务域,通过 predictive familiarity estimator 实现按需调度,提升答案准确性与响应速度。
商业价值
- 推理成本降低:累积阈值自适应路由仅在满足阈值时扩展 agent 集合,相比固定 top-k 或全量调用,显著减少 token 消耗与硬件占用。
- 体验与转化提升:agent 能力分化后,用户问题被路由到更擅长领域,答非所问率下降,客户满意度与转化率改善。
- 训练数据效率:针对 agent 当前能力主动分配训练样本,减少无效微调,加快迭代周期。
与现有产品 / 工作流的接口
- 推理侧可作为 LangGraph / AutoGen / CrewAI 等编排框架的自定义 router,通过 hook 获取开源模型中间层 hidden states 计算 familiarity score,无需改动 agent 内部结构。
- 训练侧可嵌入现有 RLHF / DPO 管线,将 router 优化作为额外步骤,利用 familiarity 信号生成针对性训练集。
- 闭源 API 模型需通过代理特征或蒸馏近似 intermediate states;开源模型(如 Llama、Qwen、DeepSeek)可直接集成,部署门槛较低。
局限
- - 训练与推理的计算开销仍可能较高:虽然 familiarity estimator 用 mid-layer hidden states 替代 full rollouts,但需要前向计算至中间层并提取特征,且训练过程需联合优化 router 与多个 agent,涉及多轮采样和策略更新,总资源消耗可能显著高于静态路由或独立微调;论文未报告训练 GPU 时数、吞吐等指标,工程部署的可行性存疑。
- - 对异构 agent 集合的适应性有限:familiarity estimator 依赖 mid-layer hidden states,要求所有 agent 共享相同架构、hidden size 与 tokenizer,无法直接用于不同厂商、不同结构 LLM 组成的 MoA 系统;若中途增删 agent 或替换底座模型,需要重新训练估计器,系统扩展性和维护成本较高。此外,基于 hidden state 的语义熟悉度可能无法完全反映任务特定能力,导致路由偏差。
- - 实验评估场景较为狭窄:工作主要覆盖数学、代码、指令遵循、推理等纯文本任务,未涉及多模态、长上下文、工具调用等复杂场景;对比基线多为静态路由和固定工作流微调,缺少对近期动态路由或基于能力建模的 MoA 方法的直接比较;cumulative-threshold 等关键超参数的敏感性虽有消融,但可能不够系统,结论的外推性有限。