ActionPiece:重新思考自回归视觉-语言-动作模型的动作 token 化
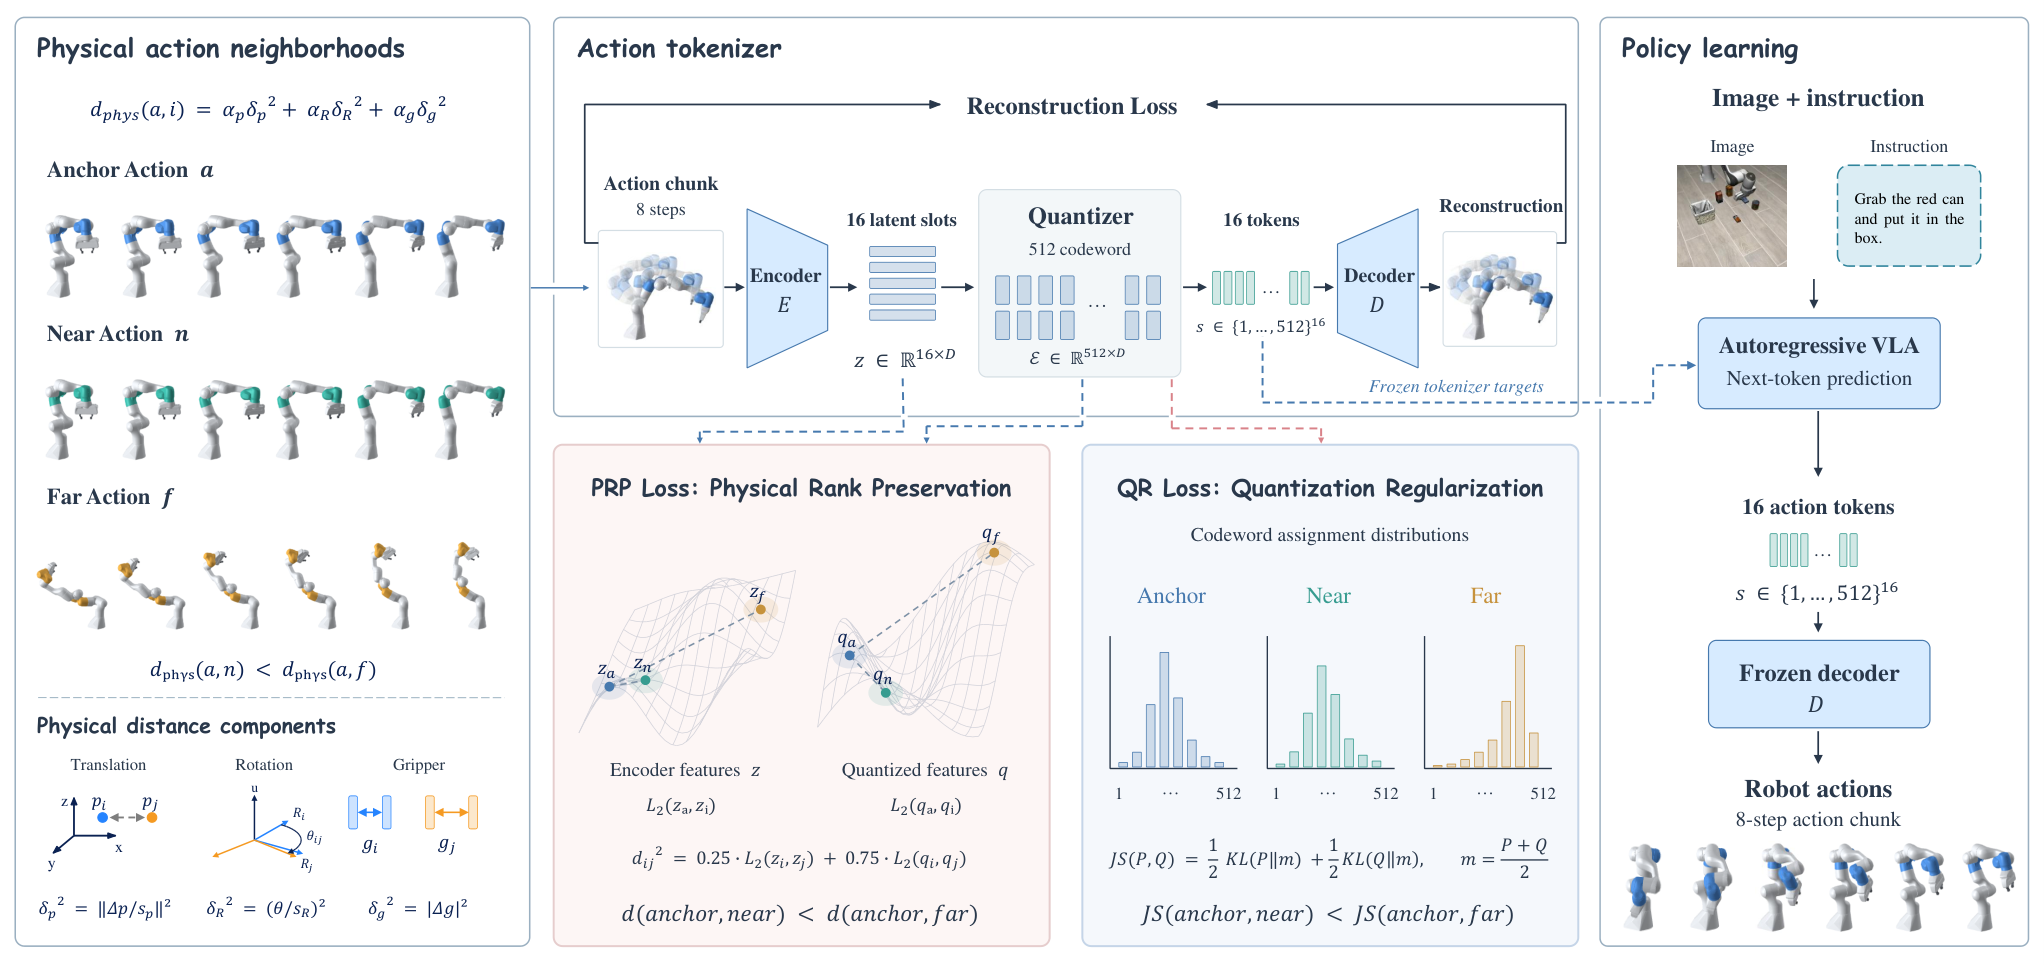
动作 tokenizer 在自回归 vision-language-action (VLA) 模型中处于核心地位,既决定策略训练的目标,也决定从预测 token 中恢复的可执行指令。其保真度常用 MSE 等逐点重建指标衡量,但微小的单点误差无法刻画跨示范的动作调整是否被忠实保留:压缩后相似动作仍可能聚集在某个代表性运动附近,而不同上下文所需的调整却被削弱、扭曲甚至反转。 作者提出 physical rank consistency (PRC),衡量 tokenization 在重建后能多好地保留局部物理距离排序。在解码动作上评估,可为不同 token 词表与解码器结构提供统一参照,在逐点精度之外补充关系保真度。 基于此提出 ActionPiece,通过表示学习与量化的联合监督保留物理动作关系:物理排序保持约束 encoder 与量化特征距离中的远近顺序,量化正则化则将同样排序施加到 codeword 分配分布上。二者与重建目标共同作用,产出供标准自回归策略学习、并由冻结解码器执行的离散动作 token。 在相同的 Qwen3-VL-4B 训练设置下,ActionPiece 在 LIBERO 上达 94.8%,未见过的 LIBERO-Plus 达 68.8%,SimplerEnv 达 71.9%,VLA-Arena L0-L2 达 51.5%。组件消融显示两个目标共同提升 PRC 与策略成功率,表明物理关系监督对动作 tokenization 的价值。
论文精读
TL;DR ActionPiece 提出物理秩一致性(PRC)评估动作 tokenization 的关系保真度,并通过联合表征与量化监督保留动作间物理距离排序,在 LIBERO 上以 Qwen3-VL-4B 实现 94.8% 成功率,证明关系监督对 VLA 策略的有效性。
问题
问题背景
自回归 VLA 模型 依赖动作 tokenizer 将连续动作转换为离散 token,作为策略训练目标与可执行命令的桥梁。
现有方法局限
主流评估只关注点级重建误差(如 MSE),然而压缩后相似动作可能仍簇拥在某个代表性运动附近,而不同情境所需的动作调整却被削弱、畸变甚至反转。MSE 无法捕捉这种关系保真度,导致重建误差小的 tokenizer 在实际控制中表现依然不佳。
为什么这个问题难/重要
动作 tokenization 需要在离散码本有限容量下保留连续物理空间中的局部距离排序,这与图像 tokenization 的感知相似性不同——机器人动作的小幅误差直接导致末端位姿、力控等物理量偏差,且跨演示的动作差异正是策略泛化的关键信号。业界关注点已从单纯重建精度转向物理关系保持,因为下游策略学习仅能利用 token 序列携带的监督信息,关系丢失无法通过策略训练恢复。
行业类比
类似语音编解码器从仅看频谱 MSE 转向引入 PESQ/STOI 等感知排序指标:仅保整体失真不足以确保语义保留,动作 tokenization 也需要物理层面的排序一致性。
核心洞察
- 动作 tokenization 的质量不能只看点wise重建误差,而应关注重建后动作之间物理距离排序是否保持。PRC 指标填补了这一空白,它度量局部邻居排序在 token 化和重建前后的变化,为不同词表和解码器提供了统一的 relational fidelity 评估基准。
- ActionPiece 将物理排序保持作为监督信号直接作用于表示学习和量化过程,而不只是依赖重建损失。通过在编码器特征距离和码本分配概率上都施加排序约束,模型学习到的离散 token 能更好地保留连续动作空间的局部几何结构,从而提升下游策略在复杂操作任务中的成功率和泛化性。
方法
输入为机器人示教中的连续动作序列(如末端位姿、夹爪开合等)。ActionPiece 通过编码器将连续动作映射到连续特征向量,并利用定义在动作空间上的物理动作距离捕获动作之间的局部差异。
关键模块
- 物理秩保持:对于每个锚点动作,选取其在物理距离下的近邻与远邻,约束编码器输出和量化后特征的距离排序与真实物理距离排序一致(即近邻距离小于远邻)。
- 量化正则化:在码字分配分布上应用相同的排序约束,使码字间的概率分布也体现物理接近度,增强量化后的结构保持。
- 重建损失:解码器从量化特征重建原始动作,保证可执行性。
训练与输出
三个损失联合优化,得到码书和冻结解码器。策略模型(如 Qwen3-VL-4B)接收视觉和语言输入,输出离散 token 序列,经冻结解码器映射回连续动作执行。
与同类方法差异
不同于仅以 MSE 等点态重建误差为目标的动作分词器(如 VQ-VAE 类),ActionPiece 显式监督动作间的物理距离排序,通过物理秩保持和量化正则化保留上下文相关的细微动作调整,使压缩后的 token 仍能忠实反映物理关系。
实验
实验设计
ActionPiece 在 Qwen3-VL-4B 策略训练设置下评估,先在机器人操作数据上训练 动作分词器 与冻结解码器,再用于自回归策略学习。评估覆盖 LIBERO、LIBERO-Plus、SimplerEnv 及 VLA-Arena L0-L2,并做组件消融验证物理关系监督的作用。
关键发现
ActionPiece 在 LIBERO 上达到 94.8% 成功率,在未见过的 LIBERO-Plus 上为 68.8%,SimplerEnv 71.9%,VLA-Arena L0-L2 平均 51.5%。消融实验显示,物理秩保持 与 量化正则化 联合监督不仅提升 物理秩一致性(PRC),也直接提升策略成功率。
与基线对比
摘要强调在相同 Qwen3-VL-4B 策略训练设置下进行比较,说明改进来自分词器而非策略容量。传统点误差指标(如 MSE)无法反映关系保真度,而 PRC 从排序角度补充评估,ActionPiece 的联合监督比单纯重建更能保留局部物理距离排序,从而提升下游策略性能。
行业影响
落地场景
ActionPiece 面向自回归 VLA 模型的动作分词环节,适合需要将连续控制信号离散化为 token 的机器人操作任务。典型落地包括:
- 仓储物流机器人:电商仓库中的抓取、分拣、装箱等操作,要求动作序列保留细微调整(如插入、对齐、力控变化)。ActionPiece 通过 物理秩一致性 避免压缩后调整被抹除或反转,提升复杂操作成功率。
- 医疗辅助机器人:手术或康复场景中的精细位姿控制,需要高保真动作重建,PRC 指标可量化动作关系保持程度,作为安全验证参考。
- 自动驾驶底层控制:将方向盘转角、油门/刹车等连续动作 token 化,辅助端到端驾驶策略训练。
商业价值
- 降本:更高质量的动作 token 减少策略训练所需的演示数据量,降低数据采集与标注成本;同时提高任务成功率,减少机器人现场调试与失败重试带来的时间与资源消耗。
- 增收 / 体验:在仓储、配送等场景中,更高成功率和动作稳定性直接提升自动化吞吐量,缩短投资回报周期。在服务机器人场景,更自然的动作执行改善用户体验,加速产品商业化。
- 研发效率:PRC 提供统一、与解码器无关的度量,可作为 tokenizer 选型与回归测试的自动化质量门禁,缩短模型迭代周期。
与现有产品 / 工作流接口
ActionPiece 输出离散 token 和冻结解码器,可无缝嵌入现有自回归 VLA 训练管线,无需修改策略网络架构。集成路径:
- 使用机器人演示数据训练 ActionPiece tokenizer,替换现有动作离散化模块(如 VQ-VAE)。
- 冻结 tokenizer,将动作 token 作为训练目标,与视觉语言模型(如 Qwen3-VL)联合微调。
- 推理时通过冻结解码器将预测 token 还原为连续动作命令。
该方法兼容主流 VLA 框架与推理栈,GitHub 实现 提供配置与训练细节,便于工程团队快速验证效果。
局限
- **仿真验证为主**:论文在 LIBERO、LIBERO-Plus、SimplerEnv、VLA-Arena 四个仿真基准上评估,但缺少真实机器人实验。Action tokenizer 的物理距离度量依赖特定动作空间的归一化和关节配置,跨 embodiment 或真实世界动力学差异可能导致 PRC 监督失真。工程部署时,tokenizer 解码延迟与 policy 推理的耦合尚未评估,可能影响实时控制闭环。
- **PRC 侧重局部排序**:物理 rank consistency 仅约束近邻排序,不能反映全局动作分布或长期执行中的累积误差。在极高压缩率或小码本设置下,即使局部排序保持较好,重建误差仍可能显著,导致策略成功率下降。此外,与先前 tokenizer 的对比中,各方法训练超参数不完全一致,性能提升可能部分来自训练细节而非核心设计。
- **训练复杂度增加**:在重建损失之外加入 physical rank preservation 和 quantization regularization 两个目标,需要额外的负样本挖掘和距离计算,调参成本上升。该方法仍依赖 VQ-VAE 框架,码本大小、量化层级等关键超参由经验确定,缺乏系统化指导,限制了在新动作空间或新机器人平台上的快速适配。