ScienceIDE: 将世界科学代码库转化为 Agent 可学习环境
科学代码仓库以可执行模型、方法和工具的形式,承载了数十年的人类知识。然而,碎片化的工具链、隐式的领域约定以及专门化的正确性标准,使这些知识难以转化为可靠的学习经验——我们将这一挑战称为 scientific experience bottleneck(科学经验瓶颈)。 为此,我们提出 ScienceIDE,一套可将全球科学代码转化为科学 agent 可编程环境的基础设施。在专家定义的 scientific cases 与 acceptance criteria 引导下,agent 把代码仓库转化为可执行环境,支持 任务生成、执行 和 科学验证,并为监督微调、强化学习与评估提供共享基础。 利用经过验证的交互轨迹,我们训练了 PhAI-IDE-72B、PhAI-IDE-9B 和 PhAI-IDE-4B。该模型系列在留出的科学代码修复任务,以及代码、推理、知识等多项通用基准上均取得提升,说明科学经验能够正向迁移至更广泛的能力。 ScienceIDE 为 agent 学习与科学实践的一体化工作空间奠定基础,让人类的科学软件成为发展科学智能的共享基座。代码:https://github.com/aitofound/ScienceIDE
论文精读
TL;DR ScienceIDE 将全球科学代码库转化为智能体可学习的可执行环境,用专家验收标准生成训练轨迹,训练的 PhAI-IDE 系列在科学代码修复和通用能力上同步提升,打通科学经验到 AI 能力的闭环。
问题
问题背景
AI for Science 正从专用模型走向通用科学 agent,但科学代码库中的可执行知识——模型、方法、工具——尚未被有效转化为训练信号。
现有方法局限
当前工作大多止步于静态数据集或单领域基准:
- 工具链碎片化:不同科学领域的构建系统、依赖管理和运行入口差异巨大,难以自动化统一执行;
- 隐式领域约定:科学任务的正确性往往依赖专家设定的验收标准,而普通单元测试无法覆盖数值容差、物理约束或统计有效性;
- 缺少端到端管线:从代码仓库到可交互训练环境(任务生成、执行、验证)没有标准化协议,导致大量科学代码无法被 agent 直接消费。 作者将这一瓶颈称为 scientific experience bottleneck:科学经验难以规模化转化为可靠学习信号。
为什么这个问题难/重要
构建科学代码的可编程环境必须同时解决科学验证的可信度(不能仅靠测试通过)、任务难度校准(适应不同预算与策略)以及跨领域泛化(覆盖物理、化学、生物等不同代码库)。业界关注度高是因为科学代码是高质量、可执行、天然包含 ground truth 的知识源,若能变成在线学习环境,不仅可提升 model 在科学推理上的表现,还可能通过 RL 产生向通用代码与推理能力的正迁移——这正是 ScienceIDE 试图验证的假设。
行业类比
类似于 SWE-bench 将 GitHub 代码仓库转化为代码 agent 的训练与评测基础设施,ScienceIDE 试图为科学代码建立同一层抽象,让全世界的科学软件成为训练科学智能的共享基底。
核心洞察
- ScienceIDE 的核心见解是将世界科学代码库转化为智能体可学习环境,把科学软件从应用目标变为经验来源。与多数 AI for Science 工作把科学问题作为下游任务不同,ScienceIDE 反向操作,通过专家定义的验收标准显式化领域知识,将代码仓库包装成可生成任务、执行并验证的环境,使监督微调和强化学习能够利用科学交互轨迹。这种‘科学为 AI’的路径为获取高质量复杂推理数据提供了新渠道,区别于仅依赖通用代码或文本语料的训练方式。
- 另一个关键见解是用 scientific checks 将专家验收标准编码为可执行验证,解决了科学经验无法大规模自动标注的瓶颈。科学代码的正确性标准远不止单元测试,还包含领域约束和数值合理性。ScienceIDE 通过校验步骤把隐式知识转化为可计算的奖励信号,使得强化学习可以在科学任务上获得可靠反馈。这超越了过去仅用 pass@k 或人类标注的评估方式,为科学智能体的在线学习提供了基础设施。
方法
输入
- 科学代码仓库(科学软件生态中的可执行模型、方法、工具)
- 专家定义的科学案例与验收标准(acceptance criteria)
关键模块
- 环境编译:将仓库封装为可编程环境,统一接口供智能体调用,支持任务生成、执行与结果收集。
- 科学检查:从官方测试扩展到科学检查(scientific checks),不仅验证代码通过原有单元测试,还检查执行结果是否满足特定领域的正确性准则(如数值精度、物理约束)。
- 任务工厂:将可复用的科学方法特化为任务生成器,批量产出不同难度与预算需求的任务,避免重复造轮子。
- 任务验证:通过实际执行来确认任务有效性与难度(“Propose broadly; establish validity by execution”),并根据策略和计算预算调整相对难度。
- 学习连接:收集验证过的交互轨迹,用于监督微调(SFT)、**强化学习(RL)**和离线评估;在线阶段利用可验证反馈(如执行成功、科学检查通过)作为奖励信号。
输出
- 可编程科学环境,为模型学习提供共享基础,支撑任务生成、执行和科学验证。
- 基于交互轨迹训练的模型家族 PhAI-IDE-72B / 9B / 4B,在科学代码修复和通用基准上均表现出正向迁移。
差异点
不同于仅提供静态数据集或单一领域智能体的工作,ScienceIDE 将科学代码库整体转化为可交互、可执行验证的学习环境,强调执行真实性与科学正确性,使科学经验成为训练通用智能的共享基质。
实验
实验设计
ScienceIDE 将科学代码库编译为可执行环境,基于专家定义的科学案例和验收标准,使 agent 能将仓库转化为支持任务生成、执行和科学验证的环境。训练数据来自 验证过的交互轨迹,覆盖 SFT 与在线 RL。模型族包括 PhAI-IDE-72B、PhAI-IDE-9B、PhAI-IDE-4B。评估维度包括留出科学代码修复、通用代码/推理/知识基准,以及资源效率。
关键发现
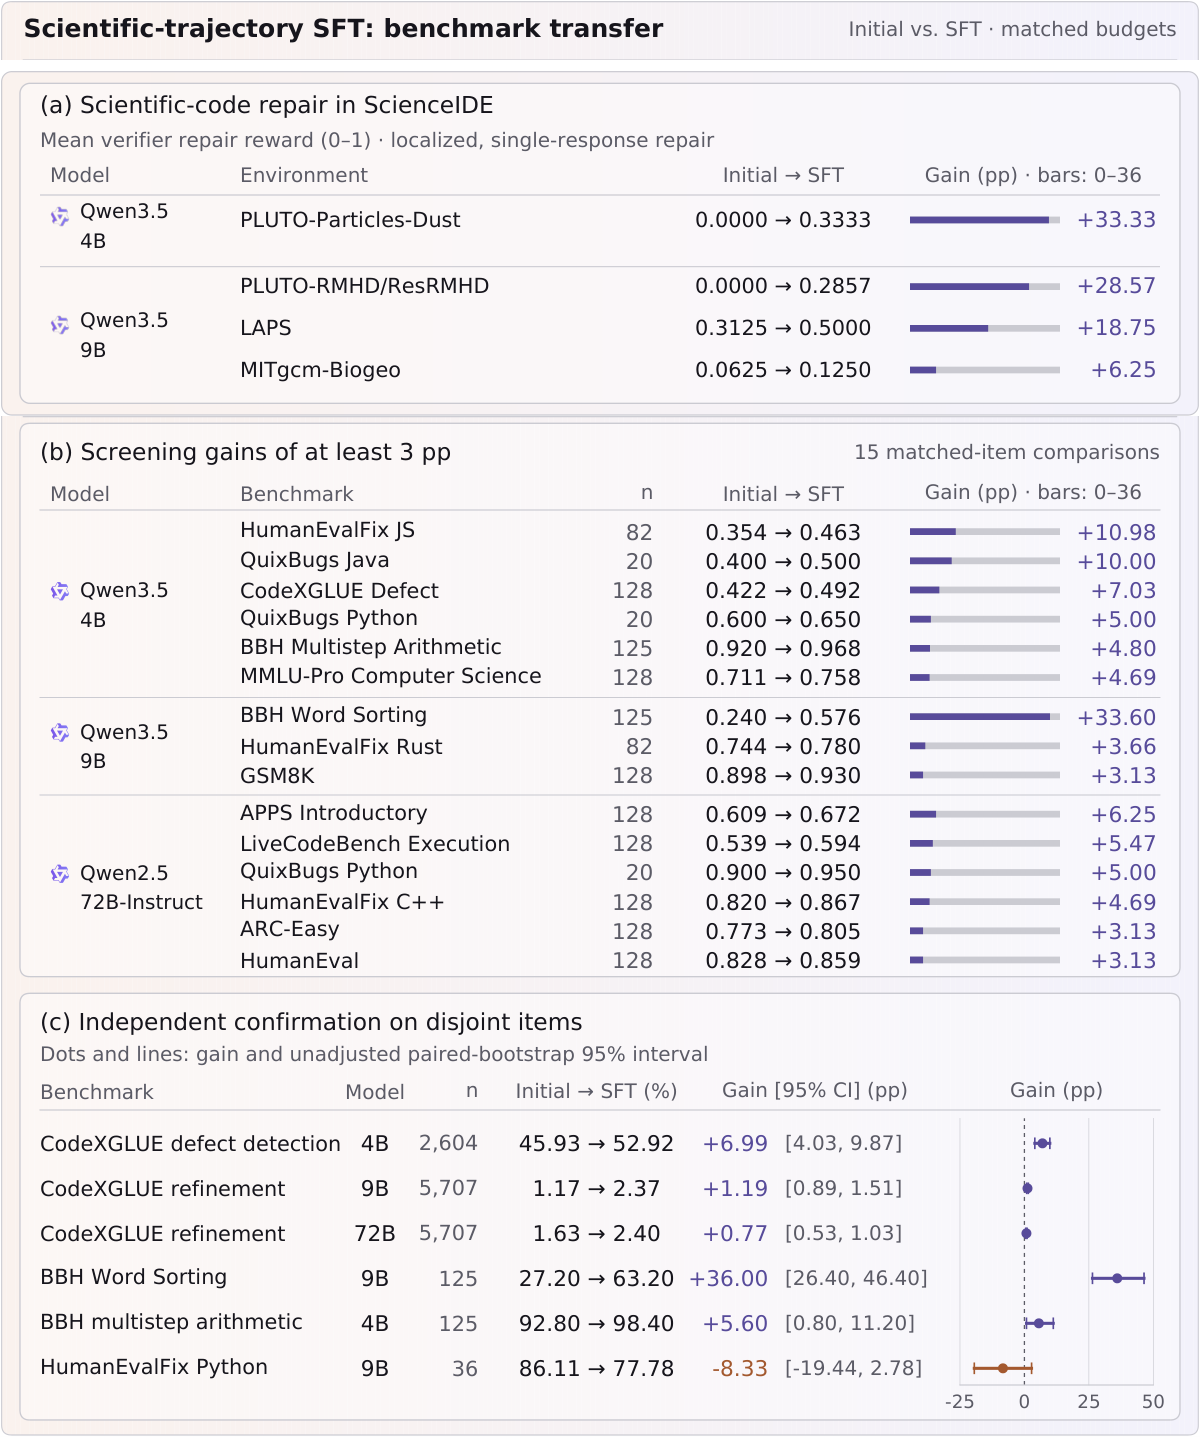
- 使用交互轨迹进行 SFT 后,模型在科学代码修复奖励上提升,且收益泛化到通用代码、推理和知识任务,显示 科学经验可迁移。
- 在线验证器反馈能显著提高留出科学奖励,说明环境奖励信号与任务目标对齐。
- 预算与成功率不呈正相关:更多推理开销不保证更高成功率,提示 agent 的资源分配策略需要优化。
- 失败分析表明,不同缺陷可导致相同错误目标修复,且局部测试通过不意味着完成指定任务,强调验证协议必须覆盖完整科学工作流。
与基线/工程启示
相比纯通用模型,通过科学环境生成的可执行任务与专业验收标准能提供更可靠的监督信号,避免"本地测试通过但未完成指定任务"的问题。这为 AI for Science 提供了一种数据生产范式:将领域专家知识编译为环境,而不是零散收集数据。工程上,ScienceIDE 的 环境工厂 设计(任务工厂 + 科学检查)可复用于不同学科,降低构建科学 agent 训练集的边际成本。
行业影响
落地场景
ScienceIDE 把科学代码库转化为 agent 可交互的执行环境、任务工厂与 verifier,该范式可复制到企业级专业代码资产。
- 金融量化:将策略回测库与风控模型封装为沙箱,让 agent 自动完成因子挖掘、参数调优、缺陷修复,以夏普比率、最大回撤等作为验收标准。
- 医疗影像:把影像配准/分割代码库包装为环境,agent 在不同协议的数据分布上学习适应,用 Dice、HD95 等指标做实时验证。
商业价值
核心价值在于降低把领域代码知识转化为训练信号的边际成本。传统做法依赖专家编写大量示范或奖励函数;ScienceIDE 通过专家定义少量“科学案例 + 验收标准”,自动批量生成可验证任务与轨迹,用于 SFT、RL 和评估。论文显示验证轨迹训练的模型在 held-out 科学代码修复及通用代码/推理/知识 benchmark 上均有提升,说明企业可同时获得垂直能力与通用能力收益,减少重复标注投入、缩短模型迭代周期。
与现有 stack 集成
ScienceIDE 适合作为 MLOps 的中间层:
- 通过
Docker/Kubernetes提供可执行环境,接入 GitHub/GitLab 等代码仓库。 - 将“科学检查”作为 CI/CD 门禁,保证修复质量与可复现性。
- 训练阶段对接 Ray/DeepSpeed 等分布式框架,评估阶段输出标准轨迹供 SFT/RLHF 使用。
- 环境协议可封装为 API,供 LangChain、AutoGen 等现有 agent 框架直接调用,降低集成门槛。
局限
- **专家依赖与可扩展性瓶颈** ScienceIDE 依赖领域专家为每个科学仓库定义案例和验收标准,这一人工过程成本高、难以规模化,可能将“科学经验瓶颈”转移为“专家标注瓶颈”。论文虽提及专家定义,但未展示自动化生成这些标准的机制,限制了其覆盖大规模科学代码库的能力。不同领域的验收标准差异巨大,专家知识的主观性可能影响环境的一致性和可复现性,削弱其作为通用基础设施的可靠性。
- **评估范围与泛化风险** 实验集中于**科学代码修复**任务和选定的通用基准(代码、推理、知识),任务类型较为单一。科学实践还包括数据分析、模型构建、实验设计等,当前环境可能无法充分代表这些能力。模型训练数据来自有限科学仓库生成的轨迹,存在对特定代码风格的过拟合风险,泛化到未见科学领域的能力未经充分测试。与 **SWE-bench** 等成熟软件工程基准相比,ScienceIDE 的评估维度和难度分级可能不够全面,缺乏多领域标准化校准。
- **生态成熟度与部署障碍** ScienceIDE 开源但社区参与度较低(GitHub 24 stars),说明其易用性、文档或实际价值尚未得到广泛验证。与更成熟的代码执行环境(如 **SWE-bench**、OpenAI 的代码训练管道)相比,ScienceIDE 在工具链完整性、容器化支持、多语言科学代码覆盖等方面可能仍有差距。科学代码往往依赖专有数据、特定硬件或复杂依赖,实际执行中可能遇到障碍,限制了其在真实科学工作流中的直接应用。