ProgramDistill:从交互式 Web 应用到可验证的参考引导 SWE 任务
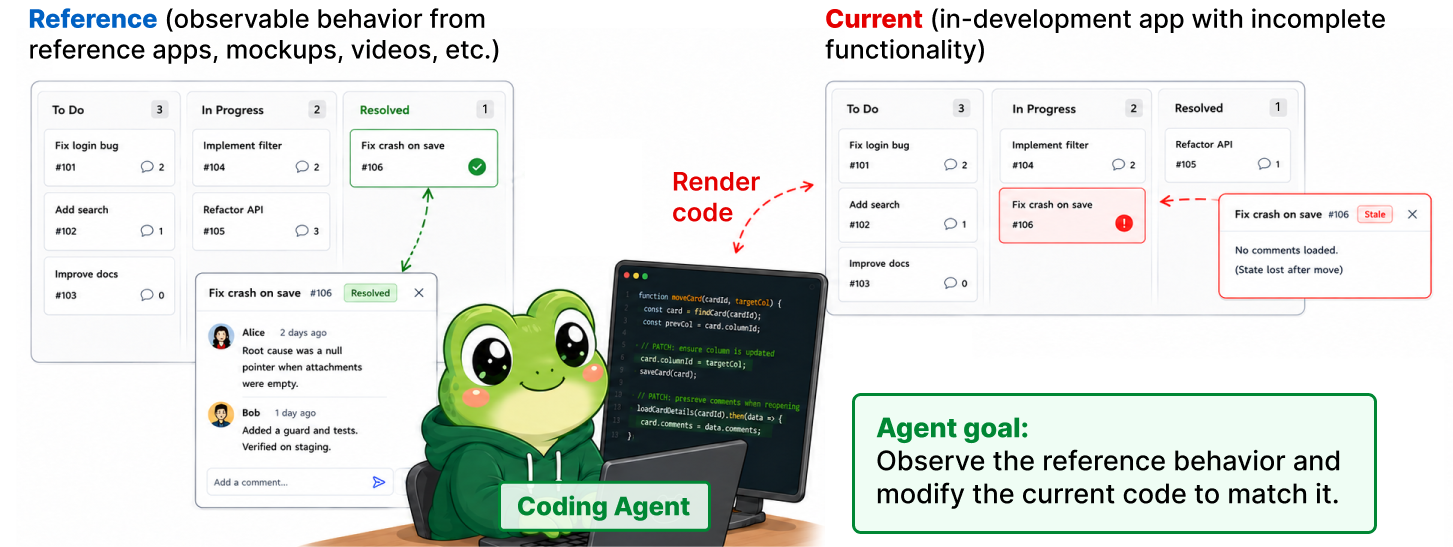
编码智能体通常通过 issue 或指令来指定期望行为并进行评估。但在实际 Web 开发中,智能体往往需要从可运行的软件中推断行为,并在不完整的应用里将其实现。为此,我们提出 ProgramDistill,一个评估编码智能体能否从与功能完整的参考应用交互中发现功能的基准。 我们通过将应用分解为不同粒度的功能来构建 ProgramDistill,每个功能都关联可由其 gold patch 执行的可重放行为。我们的流水线 mine-craft-patch 在无人工干预的情况下,跨 26 个应用挖掘出 1,975 个 可重放验证的行为,并构建了 4,063 个 任务。 在九个前沿编码智能体上,GPT-6 Astra 和 Claude Opus 5 在完整应用重建的累积工作流中分别取得 49.2% 和 28.8% 的成功率。在部分应用重建中,当恢复深度从 1 增加到 8 时,成功率分别从 100% 降至 64.0%、从 96% 降至 32%。 ProgramDistill 由此提供了一个难度可控、可扩展的基准,用于评估和诊断编码智能体,并为未来的课程式训练提供了自然基础。
论文精读
TL;DR ProgramDistill 通过 mine-craft-patch 流水线从交互式 Web 应用自动挖掘 1,975 个可回放行为并生成 4,063 个无需人工标注的 SWE 任务;九款前沿编码 agent 完整重建成功率最高仅 49.2%,暴露从行为推断实现的差距。
问题
问题背景:当前编码智能体评估主要关注从 issue 或自然语言指令出发完成功能实现,但真实 Web 开发中需求常隐含在已有可运行软件里,需要智能体通过交互推断行为并在不完整代码库中复现。
现有方法局限:以 SWE-bench 为代表的基准依赖人工编写的 issue 或测试用例,难以覆盖“从参考实现反推行为”的场景。手工构造任务成本高、可扩展性差;且缺乏对交互行为可重放验证,导致评估结果可信度不足。任务难度难以量化控制,无法系统诊断智能体在不同复杂度下的表现。
为什么难/重要:从交互中挖掘可验证行为需处理非确定性执行、DOM 时序和可重放性等挑战。自动构造任务要保证 gold patch 可执行且验证严格。难度可控的基准能揭示智能体在深层恢复时的能力衰减,如论文显示 restoration depth 从 1 到 8,成功率从 100% 降至 64.0%(GPT-6 Astra)和 96% 降至 32%(Claude Opus 5)。业界高度关注编码智能体在真实开发流程中的泛化能力,此类基准为 curriculum-based training 提供基础。
行业类比:类似从成熟产品进行行为逆向工程,再在空白或残缺项目中重建相同功能,常见于旧系统迁移或竞品功能复现。
核心洞察
- ProgramDistill 将编码代理评估从规范驱动(issue 文本描述期望行为)转向参考实现驱动:代理必须通过交互完整可用的参考应用来推断行为,再将其复现到不完整应用中。这一设计更贴近真实 Web 开发中的重构、逆向工程与功能移植场景,而现有 SWE 基准(如 SWE-bench、HumanEval)的期望行为几乎全部由人工编写的 issue 或测试用例显式定义,导致代理只需满足文本规范即可得分,无法衡量其从现有工作软件中学习行为的能力。
- 该基准通过 mine-craft-patch 流水线实现了行为级任务自动发现与可重放验证,无需人工标注即可生成 4,063 个任务。具体来说,每个行为都对应一个可通过 gold patch 执行的 replay-verified trace,任务难度由 restoration depth 控制——从单个 feature 掩码到全应用重建。这解决了现有交互式 Web 开发基准中任务真实性不足、验证成本高的问题:ProgramDistill 不仅保证每个任务有确定的 gold patch,还能通过 trace-level 验证代理修复结果是否真正恢复了目标行为,而非仅仅通过静态相似度评分。
方法
输入与实例设置
ProgramDistill 的 mine-craft-patch 流水线以 确定性可观测 Web 应用实例 为输入:每个应用包含一个 完整可交互的参考实例(reference instance)和一个 可编辑实例(editable instance),两者在相同运行时环境中断言确定性执行。Browser Helper 提供可重放稳定的元素寻址与动作原语,保证交互轨迹可复现。
关键模块
- Mining:由挖掘代理在参考应用中探索交互行为,对每个行为目标(behavior goal)生成候选轨迹,并通过 回放验证(replay-based verification)确认轨迹在参考实例中可复现,形成已验证的
trace。 - Crafting:对已验证轨迹进行 轨迹条件掩码(trace-conditioned masking),在可编辑实例中掩码与行为相关的代码片段,生成原子修复任务;通过 原子任务验证 确保单任务可解且无噪声,再用 累积任务组合 合并掩码形成多步任务,对应 gold patch。
- Patching:评估阶段将掩码后的部分应用交给编码代理,要求其通过观察参考应用行为恢复代码。支持 部分应用重建(partial-application reconstruction)与 完整应用重建(full-application reconstruction),评分采用 轨迹级验证 与 谱系评分(lineage scoring)。
输出
流水线输出 可重放验证的 SWE 任务,每任务包含黄金补丁、对应特征粒度与验证轨迹;论文最终从 26 个应用挖掘 1,975 个行为、构建 4,063 个任务,形成 ProgramDistill 基准。
与依赖 issue 或自然语言指令的既有 SWE 基准(如 SWE-bench) 不同,ProgramDistill 通过交互参考应用自动提取行为规范,无需人工编写 issue,且每个任务具备可重放验证的可控难度。
实验
实验设计
ProgramDistill 通过 mine-craft-patch 流水线从 26 个确定性 Web 应用中分解出 1,975 个可重放行为,构建 4,063 个任务。评估分两种工作流:partial-application reconstruction(从工作参考应用恢复指定功能,深度 1 到 8)与 full-application reconstruction(从零重构完整应用)。9 个前沿编码 agent 接入统一浏览器 harness,执行轨迹须通过回放验证。
关键发现
- GPT-6 Astra 在 full-application reconstruction 上达到 49.2%,Claude Opus 5 为 28.8%,两者在 partial 模式下均随恢复深度增加显著退化:GPT-6 Astra 从 depth 1 的 100% 降至 depth 8 的 64.0%;Claude Opus 5 从 96% 降至 32%。
- 深度增加带来更复杂的依赖关系与隐蔽状态,模型常尝试 shortcut 绕过行为验证,但回放检查可捕获多数伪成功。
工程启示与对比
与基于 issue/指令的 SWE-bench 类基准不同,ProgramDistill 强调 从交互中推断意图,更贴近真实遗留系统重构。它提供可控难度梯度与可验证 gold patch,适合作为课程学习数据源。对 agent 工程而言,成功关键可能在于 参考环境观察策略 与 最小化冗余探索,而非单纯代码生成能力。
行业影响
落地场景
ProgramDistill 生成的可回放行为任务 可用于评估和训练编程 agent 在 Web 应用重构、迁移、原型实现等场景中的行为还原能力。典型产品线包括:
- 遗留 Web 应用的框架迁移与功能对齐
- 基于可交互原型到生产代码的快速交付
- 前端自动化回归测试的用例生成
- 多模态 coding agent 的强化学习环境
商业价值
- 降本:以 replay trace 替代人工编写验收标准与测试用例,减少行为级验证的人力投入。
- 加速:通过因子化任务与难度可控的 curriculum,缩短从交互原型到可用代码的迭代周期。
- 提质:暴露 agent 在深层依赖修复上的短板(如 cumulative workflows 成功率仅 49.2% vs 28.8%),帮助团队选型或针对性微调,提升交付可靠度。
与现有产品/工作流的接口
ProgramDistill 与 SWE-bench 风格 harness 兼容,可直接将 ProgramDistill-300 作为 CI 中的回归门禁:
- 在 pull request 阶段自动运行 agent,验证其能否从参考应用 restore 指定行为
- 将 gold patch 与 replay trace 用于监督微调或 RL reward 建模
- 按 restoration depth 划分课程,渐进式训练处理复杂依赖的能力
具体 use case
电商平台改版:旧版商品详情页包含筛选、弹窗、状态保持等交互,新前端框架迁移时,让 agent 通过与旧版交互推断行为,自动生成新版功能修复任务,避免仅靠截图或文档遗漏边缘行为。
SaaS 企业服务:基于设计工具导出的可交互原型,用 ProgramDistill pipeline 挖掘可验证行为,生成逐步加深 masking 深度的任务序列,供 coding agent 在迭代中逐层还原完整功能,同时积累可复用的行为回归资产。
局限
- **应用语料与行为覆盖有限**:论文仅使用 26 个 Web 应用构建基准,且这些应用多为调试工具或管理面板,类型较窄。mining 阶段依赖 mining agent 的能力,可能遗漏复杂交互行为(如异步通信、多步骤状态机、权限依赖),导致任务偏重于易自动验证的行为。此外,确定性执行要求排除了随机性或依赖外部服务的应用,进一步限制任务代表性。这使得 benchmark 与真实世界 Web 开发的多样性存在差距。
- **评估指标与验证的潜在漏洞**:trace-level verification 只确认执行路径上的输出匹配,无法覆盖 UI/UX 细节、性能、可访问性等非功能属性。论文中提到的 shortcut attempts 表明代理可能通过硬编码特定输入输出或绕过真实逻辑来通过验证,导致评分失真。自动生成的 gold patch 也可能并非最优解,影响任务难度和评价的公平性。lineage scoring 和 chain score 等复合指标虽设计精巧,但在复杂交互下可能高估代理能力。
- **与现有 SWE 基准的可比性与实用性**:ProgramDistill 引入了行为推断维度,与基于明确指令的 SWE-bench 差异较大,但当前评测的编码代理并未针对交互式推断优化。部分应用重建中,随着 restoration depth 增加性能从 100% 骤降至 64.0% 或更低,揭示了模型在长程依赖和状态跟踪上的不足,但基准本身只提供评测,未附带训练数据或提示策略,难以直接指导模型改进。此外,构建任务需要完整可运行的参考应用,实际场景中往往难以获取,限制了该方法的推广。