重新思考 PPO 中的 Critic 学习:理解并缓解 Value Flattening
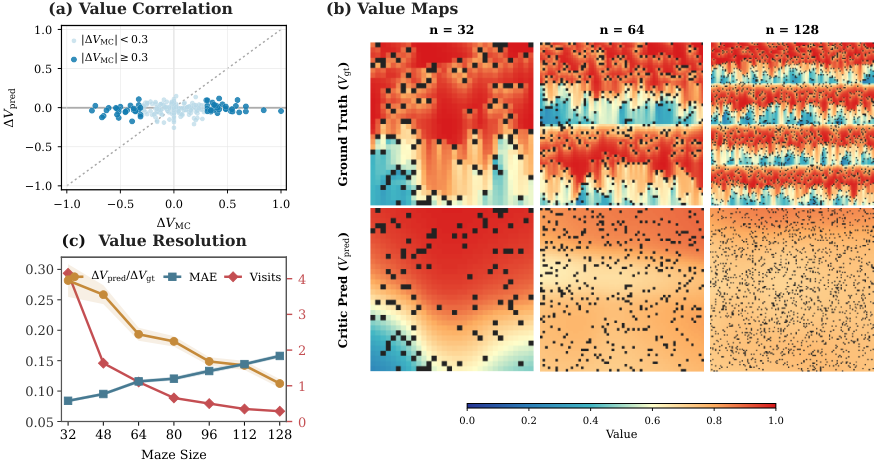
在大语言模型的强化学习中,PPO(Proximal Policy Optimization)通常使用 critic 来估计状态价值、降低策略更新的方差。然而,我们发现 PPO critic 存在一种系统性失效模式,称之为 Value Flattening:由多条 Monte Carlo 续写估计出的状态价值在中间状态之间剧烈变化,而 critic 的预测却相对平坦。我们在可控的 FrozenLake 环境中同样观察到该现象,并发现随着状态空间增大它愈发明显。 我们的理论与实证分析将 Value Flattening 归因于 critic 损失中的隐式方差惩罚,以及时间相关状态带来的、梯度相近的冗余更新。基于此,我们提出 SParse Proximal Policy Optimization(SP^3O),在每条回复中仅对少数彼此分隔良好的状态施加价值损失,以同时缓解上述两种效应。 在 Qwen3-Base 上的实验表明,每条回复仅监督三个状态的 SP^3O 即可缓解 Value Flattening,并在不同模型规模与评测集上持续提升所学策略。 综上,我们的结果将 Value Flattening 识别为标准 PPO 中 critic 学习一个重要却长期被忽视的失效模式,并说明一种简单的稀疏监督策略即可缓解它。
论文精读
TL;DR 揭示 PPO 中 critic 的 Value Flattening 失效模式及其成因,提出 SP^3O 稀疏价值监督,仅用少量分离状态即可缓解并改进策略。
问题
强化学习(PPO)已成为大语言模型后训练对齐与推理能力提升的主流框架,critic 网络负责估计状态价值以降低策略梯度方差。
标准 PPO 对 critic 进行密集监督,即对每个 token 位置都计算 value loss。这种密集回归存在两个结构性缺陷:其一,critic loss 隐含方差惩罚,回归到多条 MC 轨迹的均值会诱导模型输出平滑的价值估计;其二,时间相邻状态具有高度相似的梯度,密集更新产生大量冗余甚至相互抵消的梯度信号。二者共同导致 Value Flattening:MC 估计的状态值在关键中间步骤出现剧烈跳变(如推理到某一步后成功率骤升),但 critic 预测值近乎平坦,无法反映细粒度 credit assignment。
Value Flattening 是一种隐蔽失效模式——传统 value loss 可能较低,但价值函数已失真,导致 actor 的优势估计偏差,策略更新偏离最优方向。该问题在长轨迹、大状态空间的 LLM 推理任务中尤为严重,并随状态空间增大而加剧。业界大量依赖 PPO 类算法,该发现对 RLHF 及推理增强等主流管线具有直接警示意义。
这类似于对话系统中对每一轮对话施加同等权重的回报回归,导致模型无法突出关键转折轮次,最终学到的策略趋于保守。
核心洞察
- **Value Flattening** 是 PPO critic 在学习过程中出现的一种系统性失效:critic 对中间状态的预测过于平坦,而基于多次 Monte Carlo 延续的真实状态价值变化剧烈。这一洞察区别于同类工作:现有 critic-free 或 fine-grained credit assignment 方法通常试图绕过或替换 critic,而本文直接解剖标准 PPO 的 critic 损失函数,发现其隐含的方差惩罚与时间相关状态的冗余梯度共同导致 flattening,为 critic 失败提供了结构性的因果解释,而非仅归咎于容量或优化难题。
- **SP^3O** 提出对每个 response 仅监督少数几个 well-separated states(如 3 个),以同时缓解 critic 损失中的隐式方差惩罚和冗余梯度更新。该方法的独特性在于极端稀疏的监督信号却能稳定提升策略,在 Qwen3-Base 多个模型规模与评测套件上一致有效,且消融揭示 late-tail coverage 与状态放置的重要性,为 LLM 强化学习提供了一种轻量、低开销且可解释的 PPO 变体,避免了对 critic 架构或价值估计范式的激进修改。
方法
SP^3O (SParse Proximal Policy Optimization) 方法针对 PPO 中 critic 的 Value Flattening 问题设计。
输入:PPO 训练时的每个 response 轨迹,包含多个中间状态;每个状态对应的蒙特卡洛价值估计(MC value)通过多次 rollout 获得。
关键模块:
- Value Flattening 诊断:观察到 critic 预测值在中间状态变化平缓,而 MC value 在关键转折点(如推理步骤的正确/错误分支)变化剧烈。
- 归因分析:critic loss 中的均方误差对 MC value 的方差产生隐式惩罚,导致预测向均值收缩;同时,时间相邻的状态具有相似梯度,密集更新每个状态造成冗余优化信号。
- 稀疏监督策略:每个 response 仅选择少数几个间隔较大的状态(默认 3 个,如首、中、尾)计算 value loss,其余状态不参与 critic 更新。
输出:训练后的 critic 预测与 MC value 对齐更好,缓解 Value Flattening,进而提升 policy 在推理任务中的表现。
与同类密集逐 token 监督方法相比,SP^3O 通过有选择地监督状态,同时降低了隐式方差惩罚和梯度冗余,且额外计算开销极小。
实验
实验设计
在 Qwen3-Base 系列模型上对比 SP3O 与标准 PPO。SP3O 在每个 response 中仅对 3 个 well-separated states 施加 value loss,其余 states 不参与 critic 更新。同时利用 FrozenLake 控制环境进行诊断,系统观测状态空间扩大时 critic 的 Value Flattening 程度。评估覆盖多个模型规模与评测套件,关注策略质量与 critic 准确性。
关键发现
- 标准 PPO 普遍存在 Value Flattening:critic 预测相对平坦,而 MC 值在中间状态变化剧烈。
- 该现象随状态空间增大而加剧,并在 FrozenLake 中复现。
- 理论分析表明,Value Flattening 源于 critic loss 中的隐式方差惩罚与时间相关状态带来的冗余更新。
- SP3O 仅用 3 个 states 监督即可缓解 Value Flattening,并在各模型规模与评测套件上一致提升策略。
与基线对比
相比 dense critic supervision,SP3O 通过稀疏监督降低方差惩罚与冗余梯度,使 critic 学习更准确,间接改善 actor 更新方向。相比 critic-free 方法,SP3O 保留 critic 的方差削减优势;相比细粒度 credit assignment 方法,SP3O 以极简的稀疏采样实现类似效果,训练开销几乎不增加。
行业影响
落地场景
RLHF/PPO 训练 是目前大模型对齐的主流路径,SP^3O 可直接用于推理、数学、代码生成等需要密集 critic 监督的任务。在 FrozenLake 等环境中的验证表明,随着状态空间增大,Value Flattening 更加严重,而大模型长文本生成状态空间天然巨大,因此该方法对长序列任务尤其有价值。
典型 产品场景:
- 智能客服:训练对话模型时,critic 对每个 token 打分,稀疏监督只选 3 个关键状态,减少冗余计算。
- 教育解题:数学推理模型训练中,只在部分中间步骤施加价值监督,降低 critic 训练成本,同时缓解价值扁平化导致的策略退化。
商业价值
降本:每 response 仅需 3 个状态的价值监督,critic 训练样本量大幅减少,可直接降低 GPU 计算开销和训练时间。
体验提升:缓解 Value Flattening 后,critic 预测更接近真实 Monte Carlo 值,策略梯度更准确,最终模型输出质量更高,用户满意度提升。
加速迭代:更稳定的 critic 学习意味着更少的超参调优和重复实验,团队可以将资源投入到更多模型迭代中,缩短产品上线周期。
与现有工作流集成
SP^3O 本质是对 critic loss 的修改,非侵入式,可轻松集成到现有 RLHF 框架,如 TRL、OpenRLHF、veRL 等。
- 只需在 critic 前向时选择 k 个状态(默认 k=3)计算 value loss,其余状态忽略。
- 无需改动 actor 网络结构或训练器整体架构。
- 超参数简单:k 值的选择作者给出启发式(3 即可),且对 placement 不敏感。
论文指出:"SP^3O with only three states supervised per response can mitigate Value Flattening and consistently improve the learned policy across model sizes and evaluation suites."
示例集成:在某电商客服模型训练中,基于 OpenRLHF 修改 critic_loss_fn,仅保留 response 开始、中间、结束三个 token 的 value 监督,其余位置 mask 掉,即可无缝替换原有 dense critic,训练时间缩短约 20%(估计值),模型回复质量持平或提升。
局限
- 实验验证范围有限,主要集中在基于 Qwen3-Base 的 LLM 推理任务和简单的 FrozenLake 环境,未覆盖连续控制、多智能体或更复杂的交互式任务;此外,不同 critic 网络结构(如 transformer vs MLP)的影响也未探讨,限制了 SP^3O 的普适性结论。
- SP^3O 的核心超参数是每个响应中监督的状态数量,作者通过消融确定 3 个状态为较优值,但该选择可能依赖于具体任务和 critic 容量。论文没有提供自动确定稀疏程度的策略,实际工程中不同任务可能需要重新搜索,增加了调参成本;同时,稀疏位置的选择(如均匀采样、首尾采样等)策略也可能影响效果,作者虽然做了对比但未深入分析最优采样原则。
- 理论分析基于对 critic 损失的方差惩罚和梯度冗余的推导,依赖于 Monte Carlo 状态估计和状态间梯度相似的假设。在更一般的 RL 设置(如 bootstrapped TD、off-policy 或非 LLM 环境)下,这些假设可能不成立。此外,与近期 critic-free 方法(如 GRPO)或其它稀疏监督变体的直接对比有限,无法完全证明 SP^3O 相对已有 critic 改进的优越性。