Zing-0.5:面向可玩世界的实时联合动作与文本控制
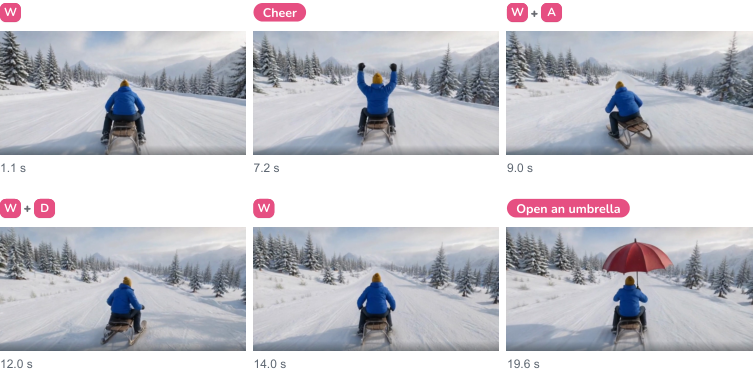
我们提出 Zing-0.5,一个 5B 自回归世界模型,专为可玩性设计:用户既能探索生成的世界、影响正在展开的事件,也能通过键盘与在线文本联合控制,对随之产生的反馈做出响应。 方法上有三项技术贡献: 1. 统一动作与文本条件:将幅度感知的键盘输入与时间对齐的文本指令、联合标注视频相结合,在同一序列中学习导航与事件控制。 2. 面向增量生成的事件尺度监督:用基于连通多提示视频训练的片段级 teacher,通过分布匹配蒸馏监督块级因果 student。 3. 低成本实时交互:将四步生成与保留上下文的流式推理结合,在 832 x 480 分辨率下达到 24 FPS,服务器租用成本估计约为每流分钟 0.009 美元。 在 158 个 WBench Navigation 案例中,Zing-0.5 取得 81.0 总分与 88.5 一致性得分。联合控制演示显示,在持续导航过程中可实现文本引导的事件切换,且无需重启生成。我们开源模型权重、推理代码与 Zing-SGLang 服务实现,以支持可玩生成世界的后续研究。
论文精读
TL;DR Zing-0.5 是一个 5B 自回归世界模型,通过联合键盘动作与在线文本条件,在 832×480 分辨率下以 24 FPS 实现可玩生成世界的实时交互控制,并开源模型与推理代码。
问题
问题背景
世界模型正从生成静态视频片段转向构建可玩世界(playable worlds),用户不仅能观看,还能实时探索、干预事件并接收反馈。
现有方法局限
现有视频生成模型大多只能基于初始文本或图像条件离线生成整段视频,无法在生成过程中注入新的控制信号。
- 动作控制弱:键盘输入通常被离散化为固定动作,丢失了按键力度与持续时间等幅度信息,难以实现平滑导航。
- 文本条件静态:文本指令只在生成开始前指定,无法在视频播放途中在线修改事件走向。
- 增量生成缺失:模型不具备因果块级生成能力,任何控制变更都需要重新生成整个序列,计算浪费严重。
- 实时性不足:自回归逐帧生成延迟高,难以满足 24 FPS 交互需求,且服务器成本随序列长度线性增长。
为什么这个问题难/重要
联合动作与文本控制要求模型在同一序列中同时理解空间导航与语义事件,两类信号在时间轴上必须精确对齐。
- 对齐难度高:动作是连续、高频、低语义的,文本是离散、低频、高语义的,融合二者需要专门的数据标注与模型架构。
- 因果约束强:交互式生成必须严格保持因果性,不能使用未来帧信息,这限制了上下文建模与蒸馏策略的设计。
- 效率与质量矛盾:实时推理要求低延迟与低显存占用,但同时又必须维持长程一致性与世界状态的持久性,传统视频模型难以兼顾。
业界对实时交互世界模型的关注持续升温,因为它直接关系到游戏、具身智能仿真与虚拟环境构建的实用化。
行业类比
这类似于自动驾驶仿真中需要实时注入方向盘/油门信号并动态改变场景事件,但用生成模型替代了传统渲染管线,对实时性与一致性提出了更高要求。
核心洞察
- 将键盘动作与文本指令统一到同一序列条件中建模,使导航和事件控制能在单一模型内同时学习,突破了以往动作条件与文本条件分离处理的局限。Zing-0.5 通过 magnitude-aware keyboard inputs 和 temporally aligned text instructions 联合标注视频,让模型同时理解连续的物理运动和离散的事件意图,相比只支持动作控制(如 GameNGen)或只支持语言指令(如 Genie)的世界模型,更接近真实游戏的双模态交互模式。
- 事件尺度监督的分布匹配蒸馏(distribution-matching distillation)实现了从 segment-level teacher 到 block-level causal student 的知识迁移,有效缓解长序列自回归生成中的误差累积与一致性下降。传统逐帧预测模型容易在长时间导航中漂移,Zing-0.5 的 teacher 在 connected multi-prompt videos 上学习跨场景事件,student 通过 rollout-replay 与分布匹配学习 teacher 的长期行为分布而非单步模仿,从而在 158 个 WBench Navigation 案例上取得 88.5 的一致性分数。
- 四步生成结合 context-preserving streaming 的推理策略,将 5B 规模世界模型的实时计算成本降至每流分钟约 0.009 美元,证明了高质量交互式世界模型可以在 RTX 5090 等级的单卡上经济地部署。与依赖大规模云端推理或离线渲染的方案不同,Zing-0.5 通过 consistency distillation 和上下文保留的流式处理,在 832 × 480 分辨率下达到 24 FPS,为实时可玩世界的大规模服务提供了可参照的工程路径。
方法
Zing-0.5 的输入由两部分组成:幅度感知键盘输入(区分按键强度,映射为连续控制信号)与时间对齐的文本指令(在线输入,在特定时间步生效),两者被统一编码为条件 token 序列。初始帧作为视觉上下文注入模型。
核心是一个 5B 自回归 Transformer,按块级流式生成视频帧。训练流程分三步:
- 双向适应:先在连接的多提示视频数据集上做双向注意力训练,让模型理解全局事件结构;
- 自回归适应:转换为因果注意力,学习按时间顺序生成;
- 蒸馏:训练一个 段级教师 模型(输入整段视频,输出全局表征),通过 分布匹配蒸馏 指导 块级学生 生成器,使得局部块生成能匹配教师的长程分布,从而支持事件尺度的一致性。
推理时结合 ODE 初始化 与一致性蒸馏,将采样步骤压缩到 4 步,并通过上下文管理(保留关键帧而非全部历史)实现实时流式输出:832×480 分辨率 @ 24 FPS。
输出为可控的视频流,用户可实时调整键盘或文本指令,模型即时改变世界动态。
与同类交互世界模型相比,Zing-0.5 的差异在于将 键盘与文本条件联合建模在同一自回归序列 中,并用段级教师蒸馏而非简单逐帧回归,实现了低成本实时可控生成。
实验
实验设计:
在 WBench Navigation 基准的 158 个案例上评测导航能力,报告 overall score 与 consistency score。训练流程包括双向适应、自回归适应、ODE 初始化与一致性蒸馏,以及分布匹配蒸馏;推理部署在 RTX 5090 上,结合四步生成与上下文保持流式传输,实现 832x480@24FPS 实时交互。
关键发现:
Zing-0.5 取得 81.0 overall 与 88.5 consistency,表明其在长时序导航中保持较好的场景一致性。联合控制演示证明用户可在持续导航中通过文本指令触发事件变化,且无需重启生成。单流成本约 $0.009/stream-minute,具备规模化部署潜力。
基线对比:
论文未直接列出对比基线的具体数值,但 WBench 作为公开导航基准,该分数处于可竞争区间。其核心差异在于统一动作与文本条件、事件尺度监督以及低延迟生成架构,这些特性在实时交互场景中可能比单纯分数更重要;不过缺少直接量化对比,需要社区进一步评测。
行业影响
落地场景
Zing-0.5 的可玩世界生成能力可应用于游戏原型快速迭代、互动叙事、虚拟培训与仿真。电商平台可部署为虚拟商品展厅,用户通过键盘导航与文本指令触发商品演示或场景变化;在线教育可构建交互式模拟环境,学员实时操作并观察反馈。内容平台可提供互动视频生成 API,让观众决定剧情走向而不需重新生成整段视频。
商业价值
该模型在 832×480 分辨率下以 24 FPS 实时推理,估计服务器租赁成本约 0.009 美元/流分钟,相比传统 3D 引擎建模或视频预渲染,可将交互内容生产成本降低 1-2 个数量级。同时,实时反馈与持久化事件机制能显著提升用户停留时长与参与度,为 UGC 平台、品牌互动营销创造新的变现机会。开源权重与 serving 实现降低采用门槛,有利于生态快速扩展。
接口与现有工作流集成
模型提供推理代码与 Zing-SGLang serving,可封装为标准 HTTP/gRPC 推理服务,对接现有前端或游戏客户端。上下文保留流式接口支持多轮交互,无需重建状态;可将该服务作为外部世界生成器嵌入 Unity/Unreal 等引擎,或与 Agent 框架(如 LangGraph)组合,实现由文本指令驱动的动态场景生成。对于已有视频生成流水线,可替换预渲染步骤,实现端到端在线交互。
具体落地用例:1) 电商虚拟试装:用户输入“切换灯光到夜间”或移动方向键,实时改变场景光照与商品展示视角;2) 自动驾驶仿真:训练系统通过文本注入罕见事件(如突然横穿行人),生成对应街景并让算法实时响应。
局限
- **世界状态持久性不足**:论文在讨论中承认“Visual History Does Not Fully Specify World State”和“Persistent Worlds Need Architectural Support”。模型基于自回归帧预测,仅依赖视觉历史,没有显式记忆或状态表示,因此难以在长时间交互中保持世界状态的一致性(例如物体位置的持久性、环境变化累积)。这限制了可玩世界的深度,可能导致交互后果在视觉历史被覆盖后消失。
- **交互后果缺乏长期影响**:论文指出“Meaningful Interaction Requires Lasting Consequences”。当前联合控制虽然能实现文本指令改变事件,但事件变化可能是局部的、短暂的,无法产生跨场景或跨会话的持久后果。与一些基于物理引擎或符号状态的世界模型相比,Zing-0.5 的纯生成式方法可能难以建模因果链和长期记忆。
- **评估范围有限**:定量评估仅基于 WBench Navigation 的 158 个案例,主要关注导航一致性;定性结果也多为演示性质。缺乏对文本控制准确性、交互多样性、多模态对齐的标准化基准。与 Genie 3、Oasis 等同类工作相比,Zing-0.5 的动作空间限定为键盘输入和在线文本,尚未覆盖更丰富的操控方式(如鼠标、手柄、多智能体交互),泛化能力有待验证。