MiniMax-H3 能推理物理世界吗?一项全模态生成模型的评估
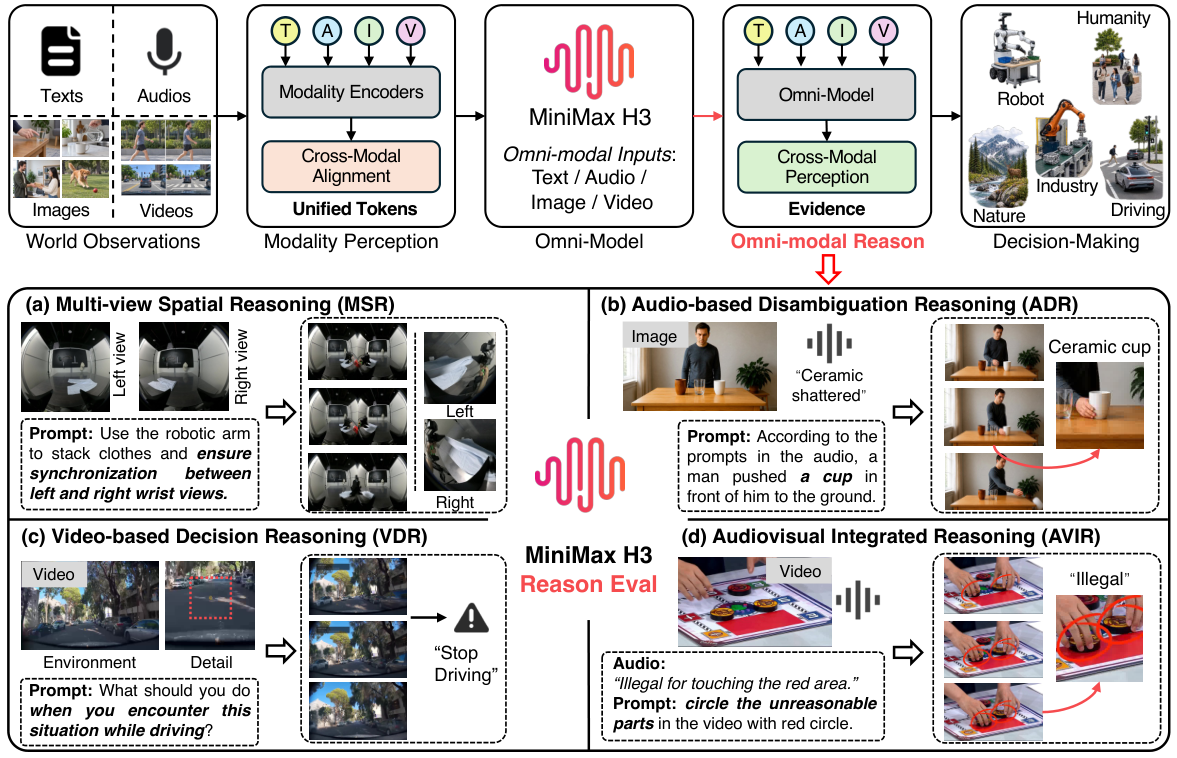
MiniMax-H3 这类 Omni-Modal 生成模型 的出现,标志着内容生成正走向文本、图像、视频与音频的统一建模:它在共享隐空间中将多模态上下文理解与音视频联合生成结合到一起。这一统一架构引出一个根本性问题:多模态对齐能否提升模型的世界推理能力,全模态输入又能开启哪些新的评估范式? 为回答该问题,本文提出一个围绕物理世界推理的四个互补维度组织的综合评估框架。与现有视频生成和世界模型评估不同——后者常受限于输入模态单一、且提示与目标视频内容高度匹配——本评估专门利用 Omni-Model 的多模态输入,构建多样化的新任务,要求模型跨模态整合互补信息。 具体涵盖四类场景: - 隐式提示 + 多帧图像 - 音频 + 图像 - 前缀视频 - 音频 + 视频 每种单一模态只提供关于底层事件的部分证据,模型需联合推理互补语义线索,以推断潜在事件状态与未来动态。 在 517 个评估实例上,MiniMax-H3 总体成功率为 41.97%。其中基于视频的决策推理最高,达 56.00%;基于音频的消歧推理最弱,仅 27.40%。结果表明,有效的多模态整合仍是充分发挥多样输入模态优势的关键。项目地址:https://github.com/gulucaptain/MiniMax-H3-Reason。
论文精读
TL;DR 评估 MiniMax-H3 对物理世界的推理能力:构建四类需跨模态互补推理的任务,517 个实例上整体成功率 41.97%,揭示多模态融合仍是关键瓶颈。
问题
问题背景:全模态生成模型(Omni-Modal Generative Models)如 MiniMax-H3 将文本、图像、视频、音频统一到共享潜空间,引发核心疑问:多模态对齐能否提升模型对物理世界的推理能力,以及新的评估范式如何设计。
现有方法局限:已有视频生成与世界模型评估框架存在两方面限制。其一,输入模态单一,通常仅用文本或图像作为条件,无法考察全模态模型中音频、视频前缀等多通道互补信息的联合推理;其二,评测设置过于宽松,提示词与目标视频内容高度匹配,模型只需表面映射即可生成合理结果,难以区分“记住了训练分布”与“真正理解物理因果”。因此,现有基准无法有效衡量模型从部分证据中推断潜在事件状态与未来动态的能力。
为什么这个问题难/重要:物理世界推理要求模型整合互补语义线索,例如仅凭一帧图像加一段音频判断事件发生条件,或从多视角帧推测三维空间关系。单一模态只提供部分证据,模型必须进行跨模态消歧与逻辑推断。全模态模型虽有统一架构,但对齐质量与推理能力的关系尚不明确,评测范式需要针对性设计。该问题直接关系到全模态模型能否从“生成工具”走向“世界模拟器”,是当前业界关注的焦点。
行业类比:类似自动驾驶中融合摄像头、激光雷达与毫米波信号进行场景理解,仅依赖单一传感器易产生歧义,多模态融合评测才能真正暴露系统对环境推理的短板。
核心洞察
- 评估范式从“生成内容匹配度”转向“跨模态物理推理”:现有视频生成与世界模型评测通常给定明确 prompt 或与目标视频高度相似的条件,模型往往只需执行条件生成,而非真正推理。本文通过设计隐式提示、多帧、音频-图像、前缀视频、音频-视频等输入组合,使每个模态只提供部分证据,迫使模型对潜在事件状态和未来动态做联合消歧。这一设计更贴近开放世界中“观察不完整、需跨模态补全”的真实推理场景,为 omni-model 的物理世界理解提供了更严格的测试基准。
- 多模态推理能力不平衡:VDR 成功率 56.00% 而 ADR 仅 27.40%,揭示音频信号在物理状态消歧上仍是主要瓶颈。模型在视频前缀驱动的决策推理中表现最好,说明视觉时序因果链建模较强;但音频-图像、音频-视频输入下的推理严重不足,表明音频语义与视觉物理属性之间缺乏有效对齐。这提示模型优化应重点强化音频模态的物理语义编码以及跨模态注意力中的语音-视觉因果绑定,而非仅依赖统一 latent 空间的生成式预训练。
- 统一 latent 框架并不自动带来物理世界推理能力:尽管 MiniMax-H3 在共享潜在空间内联合建模多模态,整体成功率仅 41.97%,说明架构上的多模态统一与可靠的世界推理之间存在显著差距。该结果提醒从业者:将文本、图像、视频、音频映射到同一表示空间只是必要条件,缺少显式的世界状态表征、物理常识约束或因果归纳偏置,模型仍会在多模态整合中出现系统性失效。未来工作需在统一建模基础上引入面向物理推理的训练目标或记忆模块,而非仅依赖生成损失。
方法
评估框架设计
该方法为 Omni-Modal 生成模型 MiniMax-H3 构建了一套物理世界推理评估范式,重点考察模型是否能从互补的多模态输入中联合推断潜在事件状态与未来动态。
输入设计:评估实例覆盖四种输入组合——隐式提示 + 多帧图像、音频 + 图像、前缀视频、音频 + 视频。每个单一模态仅提供部分证据(例如音频提供声音线索、图像提供静态场景),模型必须融合跨模态语义才能正确推理。
关键模块:四个场景针对不同推理能力:
- MSR(多视角空间推理):检验模型从不同视角帧与隐式提示中还原空间关系与运动;
- ADR(音频消歧推理):利用音频线索消除图像中的动作歧义;
- VDR(视频决策推理):给定前缀视频,预测后续合理决策或动态;
- AVIR(音视频集成推理):联合音视频输入进行综合事件推断。
数据构建流程包含:来源收集、任务特定实例构造、隐式提示生成、迭代专家评审。隐式提示不直接描述目标视频内容,避免简单文本-视频匹配,强制模型进行真实世界推理。评估采用人类标注的成功率作为主要指标。
输出与指标:模型根据多模态输入生成答案或决策,由专家标注判断正确性,统计成功率。在 517 个实例上,整体成功率为 41.97%,VDR 最高(56.00%),ADR 最低(27.40%)。
与同类方法的差异:不同于现有视频生成评估或 World-Model 评估中输入模态单一且提示与目标内容高度重合的设置,本框架刻意构造信息不全的多模态输入,要求模型像人类一样利用跨模态互补证据进行推理,更严格地检验全模态模型的世界理解能力。
实验
实验设计与方法
评测框架围绕四个物理推理维度构建:Multi-view Spatial Reasoning (MSR)、Audio-based Disambiguation Reasoning (ADR)、Video-based Decision Reasoning (VDR)、Audiovisual Integrated Reasoning (AVIR)。每个任务要求模型整合跨模态互补证据——隐式 prompt 配合多帧、音频-图像、前缀视频、音频-视频——单一模态仅提供部分事件信息,需联合推理隐状态与未来动态。数据经专家迭代审核,共 517 个实例,采用人工评估。
关键发现
MiniMax-H3 总体成功率为 41.97%,表明其物理世界推理可靠性有限。其中 VDR 成功率最高达 56.00%,说明视频帧序列提供的前后文信息较充足,支撑了决策型推理。ADR 表现最弱仅 27.40%,揭示音频信号在消解视觉歧义时仍难以有效融合,成为主要瓶颈。
与同类工作的差异
现有视频生成和世界模型评测常受限于输入模态单一、且 prompt 与目标视频高度对齐,模型可依赖表面匹配而无需深层推理。本工作显式利用 omni-model 多模态输入优势,要求每个模态只提供部分证据,必须进行跨模态因果整合。因此 41.97% 的成功率应被解读为在更逼近真实物理推理条件下的表现下限,而非绝对能力上限;未来提升需关注音频-视觉联合对齐与隐式 prompt 的指令跟随能力。
行业影响
落地场景
MiniMax-H3 作为 Omni-Modal 生成模型,可在需要融合文本、图像、视频、音频进行物理世界推理的场景中试点。目前 Video-based Decision Reasoning 的成功率最高(56.00%),可优先应用于:
- 内容平台视频理解:自动提取事件脉络、因果关系,辅助审核与推荐。
- 电商直播分析:结合主播语音与商品画面,推理商品功能演示的完整性,生成结构化卖点标签。
- 自动驾驶仿真:利用多帧图像与音频输入,推断他车意图或预判突发场景,为决策模块提供补充信号。
Audio-based Disambiguation Reasoning 仅 27.40% 成功率,暂不宜单独依赖,需结合规则或人工兜底。
商业价值
- 降本:替代部分人工视频标注与事件抽取,减少审核人力。
- 增收:更准确的多模态语义理解可提升广告匹配、商品推荐效率。
- 体验提升:在教育、医疗等交互场景中,模型能联合音视频推理,提供更自然的反馈(如虚拟实验中根据操作声音和画面判断学生动作)。
但当前整体成功率仅 41.97%,模型需以辅助工具而非自主决策核心方式部署,建议配合置信度阈值与人工复核。
与现有工作流接口
可将 MiniMax-H3 作为 推理服务,通过 REST/gRPC 接入 MLOps 流程:
- 输入多模态原始数据,输出`event_type`、`reasoning_trace`、`confidence` 等结构化字段。
- 作为视频生成或内容平台的前置 reasoning encoder,提取隐式事件表示,替换现有规则或单模态模型。
- 使用开源评测框架 MiniMax-H3-Reason 对特定业务数据做微调与回归测试,避免依赖通用基准。
具体用例
- 短视频安全审核:输入视频片段+环境音频,要求模型判断是否包含危险动作(如高处跳跃、利器使用),输出事件类型和关键帧区间。视频模态推理率较高,可缩小人工审核范围。
- 在线教育虚拟实验:学生操作画面(图像序列)+ 敲击/碰撞音频,模型推断实验步骤是否完成、操作是否规范,生成实时指导提示。该场景要求音视频联合推理,目前 AVIR 成功率尚可,但需通过提示工程约束任务边界。
局限
- 论文仅针对 **MiniMax-H3** 这一特定模型进行评测,未与 **GPT-4o**、**Gemini** 等具备多模态能力的 Omni-Model 做横向对比,因此无法判断所提出的任务难度是否过高或过低,也难评估 **MiniMax-H3** 是否具有代表性。此外,模型版本、训练数据及推理设置未完全公开,第三方复现和扩展评估存在障碍,影响结果的可信度与泛化性。
- 评测实例规模为 517 个,虽覆盖四类任务但每类样本数可能不均衡,且数据来自公开视频/音频片段,场景多样性受限。人类评估采用主观判断,缺乏自动化指标或一致性检验,可能引入标注者偏差。尤其 **Audio-based Disambiguation Reasoning (ADR)** 成功率仅 27.40%,远低于其他任务,但论文未深入分析是否源于模型音频编码能力不足还是任务设计本身过难,缺少消融实验支撑。
- 论文提出的评估框架新颖之处在于要求模型整合互补多模态线索,但本质上仍沿用现有物理推理分类(空间、因果、决策等),未提出新的理论维度或可扩展的评估协议。与 **Video-MME**、**WorldBench** 等现有 benchmark 相比,缺少对模型内部表征或注意力机制的探查,无法解释多模态融合失败的具体环节,这也限制了该框架对模型改进的直接指导价值。