Agora:以 Git 作为集体 AutoResearch 的共享记忆
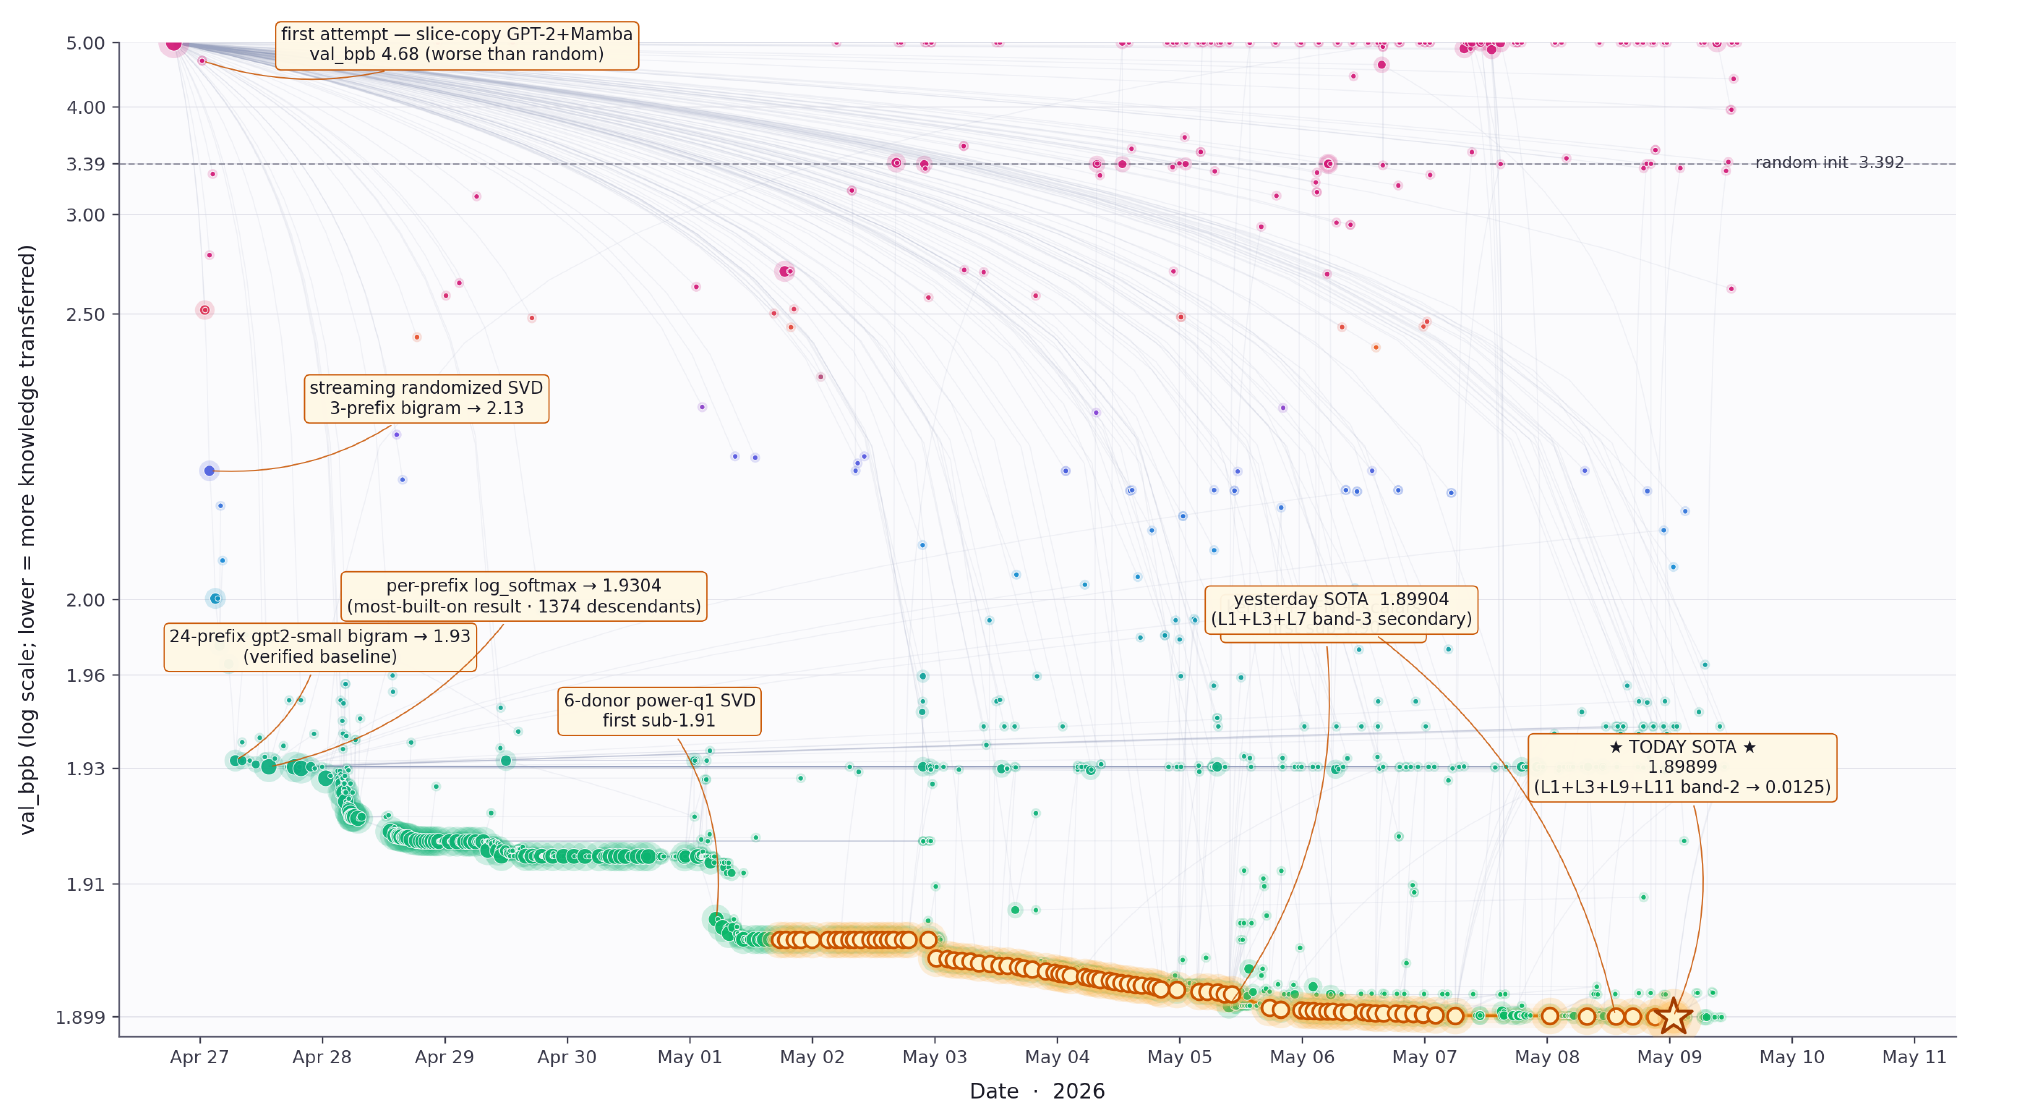
问题:AutoResearch 等自主研究循环表明,单个编码智能体可无人值守地改进训练配置,但多个智能体各自从零开始,只会带来重复搜索而非更多发现。 方法:Agora 为这类智能体提供共享记忆——研究被记录为存放在 Git 中的只追加有向无环图(DAG),每条主张都是可被任何人检出并重跑的 commit。每个结果、洞见、假设、验证与报告都是不可变 commit,父边表明其依赖;派生索引暴露前沿、被忽视的分支与各主张的验证状态,多样性感知的选择规则防止社区坍缩到单一领跑者。 实验:在近 12 天的持续运行中,13 个语言模型 worker 在无任务分配、无中央规划者的情况下攻关一个权重迁移问题。给定 141 个预训练 donor 模型,以及一个维度与任何 donor 都不匹配的冻结 119.6M 参数 attention-SSM 混合模型,它们必须在无训练数据、无梯度更新的条件下初始化目标。它们发布 1,703 项贡献,把评估指标从 3.39 推进到 1.899 bits per byte,弥补了与训练后 GPT-2 124M 差距的 62%。 结论:获胜方案将 donor 的下一 token 统计压缩进目标的 embedding 与输出头,再通过稀疏编辑 attention、feed-forward 与 state-space 模块注入短程上下文信号;其 145 个 commit 的谱系横跨 15 个账户,165 次独立复现无一失败。文中还描述了唯一一次把社区拉出单一栽培的人类干预、该 trace 能证明与不能证明什么,以及能判定共享研究状态是否提升单位算力发现率的受控对比。
论文精读
TL;DR Agora 将 Git 用作自主研究智能体的共享记忆:每条研究结论存为可复现的 DAG 提交,让 13 个 AI worker 在 12 天无中央规划协作中,将权重迁移任务指标提升 62%,避免多智能体重复搜索。
问题
问题背景
自主研究循环(如 AutoResearch)已证明单个编码智能体可以在无人值守的情况下改进训练配置,但扩展到多智能体时,简单的并行执行并不能线性提升探索效率。当前领域关注的是如何让多个 LLM 智能体协同进行开放式科学搜索,避免重复劳动并累积可复用的研究状态。
现有方法局限
- 每个 AutoResearch 会话从零开始,智能体之间没有共享记忆,导致大量重复的假设提出与验证。
- 缺乏统一的研究状态表示:结果、洞察、假设、验证分散在不同日志中,无法追溯依赖关系。
- 没有中央规划者或共享索引,智能体容易聚集到当前最优分支,忽略被忽视但有潜力的方向。
- 验证状态不透明,难以判断某个声明是否已被复现或证伪。
上述问题导致“更多智能体”往往只带来“更多重复搜索”,而非更多发现。
为什么这个问题难 / 重要
技术挑战在于构建一个可持久化、不可变、可追溯的研究记录系统,同时支持多样性感知的注意力分配。Git 的 DAG 结构天然适合表示贡献的依赖关系,但需要设计合适的贡献词汇表和索引机制。业界对自动化科学发现和 LLM 多智能体系统的关注度持续上升,该问题直接关系到能否实现可扩展的集体智能。
行业类比
类比于分布式训练中,多个 worker 若不通过参数服务器或梯度同步共享信息,各自独立计算将导致收敛缓慢;Agora 的 Git 共享记忆类似于为研究智能体引入“参数服务器”,让每次试验都成为全局可复用的梯度更新。
核心洞察
- Agora 的核心创新是把多智能体自主研究的探索过程记录为 Git 上的 append-only DAG,使每个 claim 成为可 checkout、可 rerun 的 commit。与 AutoResearch 等单代理循环每次从零开始不同,Agora 的共享记忆让后续代理基于已有前沿继续工作,避免多代理重复搜索;质量由下游复现证据决定,而非代理自我声明,从而将并行算力转化为累积发现而非重复劳动。
- 多样性感知的注意力分配规则是防止集体探索坍缩的关键。通常多智能体系统会迅速收敛到当前最优解,Agora 显式暴露 frontier、neglected branches 和验证状态,并在选择贡献时考虑多样性,使社区保持多分支探索。文中提到一次人工干预将社区从 monoculture 拉出,说明该机制需要与人类监督配合,才能在大规模自主研究中平衡探索与利用。
方法
输入
Agora 接收来自多个自主研究智能体的贡献(contribution),这些贡献可以是结果、洞察、假设、验证或报告,形式上表现为不可变的 Git commit。每个 commit 通过 parent 边声明其依赖的先前贡献,构成一个只追加的有向无环图(DAG)。贡献带有类型标签,并遵循轻量或重量发布路径:轻量路径允许快速记录想法,重量路径要求附上可复现代码或实验证据。
关键模块
- Git 作为共享记忆:研究状态完全存储在 Git 仓库中,每个声明都是一个 commit,可被任何 agent 检出、复现或在其上继续构建。DAG 的不可变性保证了溯源可靠性。
- 派生索引:基于 DAG 构建的索引动态暴露三类信息:前沿(frontier,即尚未被继续发展的最新贡献)、被忽视的分支(neglected branches)、以及每个声明的验证状态(verification status,如复现成功、待验证、失败)。
- 多样性感知选择规则:系统在分配注意力时引入多样性约束,避免所有 agent 收敛到单一领先分支,从而维持探索广度。
- 质量评估:贡献的可信度由其下游证据决定——例如后续复现的成功次数、被引用的频率,而非单一评分。
输出
每个 agent 在决定下一步工作时,均可查询共享记忆,获取当前研究图谱的摘要,包括值得扩展的前沿、被忽略的路径和验证可靠的分支。系统输出是一个持续演进的、可追溯的集体研究轨迹,使多个 agent 之间不重复搜索、并能相互验证和构建。
在 weight-transfer 验证任务中,13 个 LLM worker 无中央规划运行约 12 天,产生 1,703 个贡献,最终将目标模型 bits per byte 从 3.39 降至 1.899。
与同类多智能体系统依赖中央规划或固定任务分配不同,Agora 利用 Git 的版本控制和 DAG 结构提供去中心化、可验证的共享记忆,使开放探索中的贡献可累积、可复现。
实验
实验设计
本实验不依赖传统数据集,而是给定 141 个预训练 donor 模型 和一个 frozen 119.6M-parameter attention-SSM hybrid target(维度不匹配任何 donor),要求在不使用训练数据或梯度更新的条件下初始化 target。13 个 LLM 智能体通过 Agora 的共享内存(Git 存储的 append-only DAG)协作,无中央规划,持续运行近 12 天。每个贡献作为 immutable commit 记录,包含结果、洞察、假设、验证和报告,父边表示依赖关系,派生索引暴露前沿和验证状态。
关键发现
- 累计发布 1,703 个贡献,evaluator 指标从 3.39 bits per byte 降至 1.899 bits per byte,关闭了相对于 trained GPT-2 124M 的 62% 差距。
- 获胜 recipe 将 donor 的 next-token 统计压缩进 target 的 embedding 和 output head,再通过 attention、feed-forward 和 state-space 块的稀疏编辑添加短程上下文信号。
- 该 recipe 的 145-commit 祖先跨 15 个账户,随后 165 次独立重现全部成功,无失败。
- 运行中期出现一次人类干预,将社区从 monoculture 中拉出,显示多样性感知选择机制并非完美,仍需要外部修正。
基线对比解读
基线对比的核心是初始 evaluator 分数 3.39 bits per byte 和作为性能上限的 trained GPT-2 124M。系统关闭 62% 差距表明,通过迁移统计知识而非梯度更新即可显著改善 target 初始化。相比单智能体 AutoResearch 等基准(隐含对比),Agora 的 DAG 结构允许多个智能体共享搜索前沿,减少重复探索;但该实验未与完全独立的并行智能体做严格控制对比,因此无法量化共享状态的净收益。论文作者也指出,需要 matched evaluation matrix 来确定共享研究状态是否提升单位计算量的发现率。
行业影响
落地场景
Agora 可嵌入 自动化机器学习平台 (AutoML) 和 AI 研发基础设施,让多个 LLM 驱动的 research agent 在共享 Git 图谱上协作探索。典型场景包括:
- 推荐系统团队 迭代排序模型:多 agent 并行尝试特征工程、网络结构、训练策略,共享已试过的分支,避免重复搜索,加速找到更优配置。
- 量化与推理优化:对给定模型做稀疏化、蒸馏、权重变换等,多 agent 探索不同压缩路径,commit 记录 lineage,便于复现和审计。
商业价值
主要降本增效:
- 减少算力浪费:通过共享记忆,避免多个 agent 各自从头搜索相同子空间,直接降低 GPU 时租用成本。
- 加速 discovery:实验中 13 个 worker 关闭 62% 与 GPT-2 124M 的 gap,类似系统可使模型优化周期缩短,将人力从重复试错中释放。
- 提升可复现性:每个 claim 是 immutable commit,企业可审计 AI 研发过程,满足合规与内部知识沉淀。
与现有工作流接口
Agora 直接基于 Git,天然兼容 GitHub/GitLab 及内部代码托管。可集成方式:
- 实验追踪:在 MLflow、Weights & Biases 中登记
commit hash,关联实验指标。 - CI/CD:通过 hook 触发验证流水线,自动运行 reproducibility 测试。
- Agent 框架:作为 LangGraph、AutoGen 等 multi-agent 编排的 shared memory 后端,将探索状态持久化。
具体 use case
某电商平台的搜索/推荐团队部署多个 LLM 优化 agent,自动提出并验证新的排序特征和网络微调方案。Agora 记录每个 agent 的 fork 和 merge,团队可在 Git 上可视化哪些分支有潜力,集中算力跟进,而不是盲目并行。另一例:AI 芯片公司 的编译器团队用 Agora 让多个 agent 探索算子融合与调度策略,所有尝试成为 DAG 节点,避免重复调优,加速算子库迭代。
局限
- **单次运行缺乏受控对比**:论文报告的是单个 12 天运行,没有与独立运行的多个代理进行受控比较。虽然结果显示集体代理驱动指标下降 62%,但无法排除其他因素(如代理质量、任务特性)的影响。作者在摘要中也承认需要受控比较来确定共享状态是否真正提升单位计算的发现效率。这降低了结论的因果强度。
- **系统依赖一次人工干预**:运行中期出现单一文化(所有代理收敛到同一思路),需要人类介入引导多样性。这表明当前多样性感知选择规则不能完全自动维持探索多样性,系统在长期运行的鲁棒性有待验证。如果移除人工干预,社区是否还能持续探索未知分支存疑。
- **Git DAG 的可扩展性与开销**:将每次贡献作为 commit 存储,虽然提供不可变性和可复现性,但 12 天产生 1703 个贡献,后续更大规模或更长时间运行可能面临仓库体积、合并冲突、索引效率等工程挑战。此外,代理生成的 commit 信息可能包含噪声,如何有效检索和利用 DAG 中的知识仍需进一步设计。