NeuPAT: 面向语言保持的多模态大语言模型的神经元感知可塑性分配调优
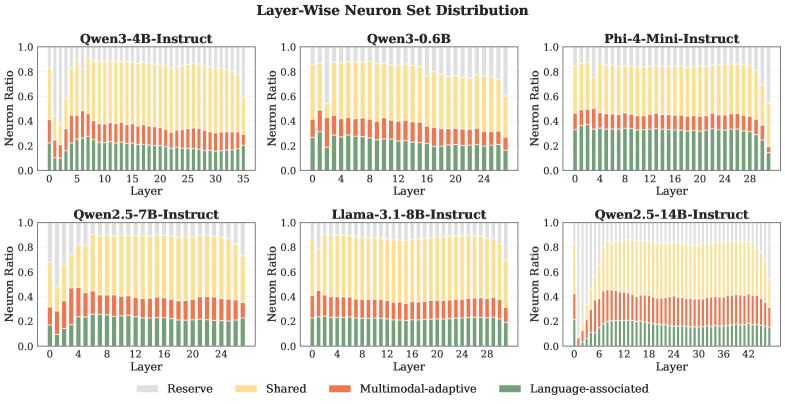
大语言模型(LLM)的多模态扩展带来了新的感知能力,但往往以损害预训练阶段获得语言智能为代价。本文从内部适应动力学角度研究该现象,发现预训练 LLM 中的神经元在多模态学习期间表现出异质性可塑性:部分神经元对保持语言能力至关重要,而另一些则更易于适应多模态知识。 基于上述发现,我们提出 NeuPAT(Neuron-aware Plasticity Allocation Tuning),一种轻量级、架构无关的框架,在多模态指令调优期间分配神经元级更新约束。NeuPAT 通过小规模探测阶段估计神经元适应模式,选择性地保护语言敏感神经元,同时利用更具可塑性的神经元促进多模态适应。 跨多种 LLM 家族实验表明,NeuPAT 在 11 个语言基准上恢复了由朴素调优造成的 94.5% 语言能力退化,同时保持了可比较的多模态性能,为能力保持的多模态扩展提供了有效途径。
论文精读
TL;DR NeuPAT 通过小规模探测识别语言敏感神经元,在多模态指令微调中施加逐神经元更新约束,保护语言能力同时保持多模态性能,可恢复 94.5% 语言退化。
问题
问题背景:多模态大模型在扩展 LLM 感知能力时,保持原有语言智能成为核心挑战,语言退化直接限制模型落地。
现有方法局限:主流缓解遗忘的手段包括 LoRA 等参数高效微调、EWC 类权重正则化以及后处理模型合并。然而这些方法普遍将网络视为均质结构,忽略了预训练 LLM 内部存在功能分化的神经元:部分神经元对语言能力至关重要,另一些则更易适配多模态知识。统一约束强度无法同时兼顾“保护语言敏感神经元”与“允许多模态可塑神经元充分更新”,导致要么语言保留不足,要么多模态性能受限。此外,现有方法需要全局超参搜索或额外推理阶段,部署成本较高。
为什么这个问题难/重要:LLM 数十亿参数中识别语言关键神经元需要在极小规模探测集上可靠估计重要性;同时多模态学习过程中神经元可塑性动态变化,静态约束容易过强或过弱。在工业级多模态助手、视觉问答等场景中,文本推理与安全对齐能力回退会带来严重体验与合规风险,业界迫切需要低开销、架构无关的自动约束分配方案。
行业类比:类似为已上线的对话系统增加视觉输入通道,既要快速适配新图像理解,又不能使原有安全策略和文本生成质量回退,相当于在模型内部做“神经元级资源调度”而非全局更新限速。
核心洞察
- 多模态微调中的语言能力退化源于神经元层面的可塑性异质性,而非均匀遗忘。NeuPAT 通过小规模探测识别出语言敏感神经元与多模态适应神经元,从而在更新时施加差异化约束。这一视角区别于 LoRA、EWC 等全局或参数级方法,后者未利用神经元功能分化,常导致保护不足或限制过多。
- NeuPAT 的“神经元可塑性分配”机制提供了一种轻量、架构无关的能力保持路径。与需要额外记忆或复杂重要性估计的方法相比,NeuPAT 仅需少量探测数据即可分配更新约束,且不修改模型架构,可在不同 LLM 家族上通用,恢复 94.5% 的语言退化,工程落地成本低。
方法
输入与预处理
给定预训练 LLM 作为文本骨干,以及多模态指令微调数据集。在正式微调前,先用一个小规模探测集(包含纯语言样本和视觉-语言样本)估计每个神经元的模态关联重要性。
关键模块
- Modality-Associated Importance Estimation:通过前向传播计算每个神经元对语言任务和多模态任务的重要性(如基于激活或梯度,由
τ_a控制阈值),得到语言敏感度分数。 - Neuron Adaptation Role Allocation:根据分数分配角色:语言敏感神经元标记为保护,高可塑性神经元标记为适应,其余中性。
- Role-Aware Multimodal Tuning:在微调中施加 neuron-wise 更新约束:对语言敏感神经元使用强正则化或降低学习率,对多模态适应神经元放宽约束,实现异质性可塑性分配。
输出
训练得到保留语言能力且具备多模态理解能力的 MLLM。论文在 11 个语言基准上恢复 94.5% 的 vanilla tuning 性能损失,同时保持多模态性能相当。
与同类方法的差异点:NeuPAT 通过小规模探测在神经元粒度上识别模态偏好,而非使用参数级全局约束(如 EWC)或低秩适配(LoRA),因此能以更细粒度实现能力保留,且对多种 LLM 骨干通用。
实验
实验设计
NeuPAT 在多种 LLM 家族上评估,与 LoRA、EWC、WINGS、TIES、Locate-then-Merge、PlaM 等基线对比。实验包含 小规模 probing 阶段估计神经元适应模式,然后进行角色感知的多模态调优。评估覆盖 11 个语言基准和多模态任务。
关键发现
摘要显示:NeuPAT 恢复了 vanilla tuning 造成的语言能力退化的 94.5%,同时保持可比的多模态性能。
- 验证了神经元异质性:部分神经元对语言保持关键,另一部分更适应多模态知识。
- 通过保护语言敏感神经元并允许更具可塑性的神经元进行多模态适应,有效缓解了灾难性遗忘。
与基线对比解读
- 相比 LoRA 等统一低秩适配,NeuPAT 提供神经元级的精细更新约束,避免对所有参数施加相同强度的限制。
- 相比 EWC 基于任务损失的重要性估计,NeuPAT 从模态关联角度直接估计神经元对语言/多模态的重要性,更贴合多模态扩展场景。
- 相比 WINGS 等硬性神经元选择,NeuPAT 使用 soft 约束(通过正则化系数调节),保留一定可塑性,避免过度约束后续学习。
- 架构无关设计使其可泛化到不同 LLM 骨干,实验验证了跨骨干的通用性。
行业影响
落地场景
NeuPAT 适用于任何在多模态扩展时需要保留语言能力的 LLM 微调流程。典型场景:
- 电商智能客服:模型需同时理解商品图片与用户文本提问,并保持流畅对话。用 NeuPAT 在新增视觉指令数据上微调,避免语言理解退化。
- 医疗影像报告生成:多模态模型读取影像和病历文本,输出诊断报告。语言准确性至关重要,NeuPAT 可保护医学语言知识,提升报告质量。
- 教育辅导系统:处理图文混合的数学题,解题步骤解释需要严谨的语言逻辑,NeuPAT 保持数学/逻辑用语正确性。
商业价值
- 降本:减少语言能力退化导致的模型回滚和重新训练;避免为不同能力维护多个模型版本,节省 GPU 与人工成本。
- 体验提升:用户感知不到文本交互质量下降,多模态功能上线不会影响原有聊天/问答体验,降低客户流失。
- 增收:更可靠的多模态模型可拓展高价值场景,如更精准的商品推荐、自动化报告生成,提升转化率与客单价。论文数据显示可恢复 94.5% 的语言退化,几乎无损,加速产品迭代。
与现有工作流接口
NeuPAT 是轻量级、架构无关框架,可轻易集成到现有微调栈:
- 插入位置:在 standard multimodal instruction tuning 前增加一个小规模 probing 阶段(估计神经元重要性),随后在优化器中施加 neuron-wise update constraint(如逐神经元梯度缩放)。
- 兼容性:与 LoRA、QLoRA 等参数高效方法正交,可叠加使用;无需改动 Transformer 架构,仅需在优化器或梯度更新处增加 mask/正则项。
- 工程实现:可用 PyTorch 自定义 optimizer wrapper 或梯度 hook 实现,无需额外服务。适用于多 LLM 家族(论文验证多个 backbone),减少适配成本。
局限
- 依赖**探测阶段**估计神经元重要性:NeuPAT 需要额外的**小规模探测阶段**来估计模态相关重要性,这增加了实现复杂度和额外计算开销。探测集的选择和规模可能影响估计稳定性,论文虽做了敏感性分析,但在实际部署中,对于不同分布的多模态数据,重要性估计可能需要重新校准。此外,探测阶段仅使用有限样本,可能无法完全捕捉语言敏感神经元的动态行为,导致保护策略的泛化性受限。
- 神经元角色分配基于固定阈值:NeuPAT 通过设定目标重要性质量 `τ_a` 来划分保护与可塑神经元,但该超参数可能对模型和任务敏感。不同 LLM 家族或不同多模态数据集下,最优阈值可能变化,需要额外调参。与 **LoRA** 等即插即用方法相比,NeuPAT 需要更多经验性配置,可能增加工程负担。此外,逐神经元约束的实现需要修改优化器或梯度掩码,对某些训练框架的兼容性可能受限。
- 只评估语言能力保持,未全面考察其他认知能力:论文主要关注语言基准恢复,但多模态扩展可能影响 LLM 的其他能力,如推理、常识、代码生成等。NeuPAT 的保护机制可能对语言敏感神经元有效,但未验证是否同时保护其他高级能力。在更广泛的任务中,神经元重要性可能不是单一模态可分离的,简单保护语言敏感神经元可能无法全面防止通用能力退化。需要进一步探索多维度能力保持的权衡。