一种用于解耦 LLM 驱动优化中结构与参数的混合嵌套框架
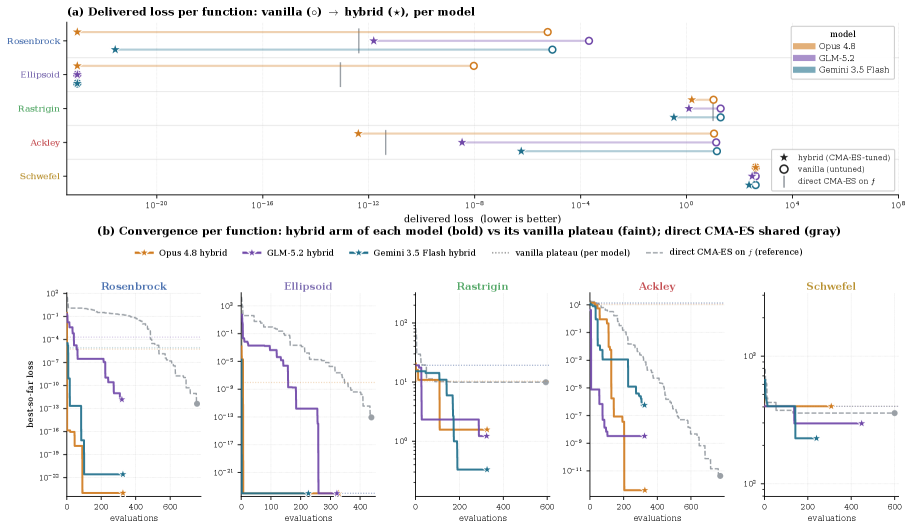
在语言模型驱动的进化算法中,LLM 作为单一算子同时更新结构组件(如控制流)和连续参数。虽然 LLM 擅长结构改进,但在参数微调上效率低下,在试错循环中以离散跳跃浪费大量 token。 我们通过形式化混合嵌套搜索(hybrid nested search)解决这一瓶颈:外层循环由 LLM 提出带数值间隙的结构草图,内层数值优化器(如 CMA-ES、梯度法或 MCMC 采样器)负责填充具体参数。内外层求解器均可插拔,任意文本优化器可与零阶优化器、梯度优化器或采样器自由组合。 我们在三个科学领域验证了框架的有效性:(1) 闭式测试函数上的元优化器;(2) 系统研究与社会困境中的基于代码的策略;(3) 近似贝叶斯推断任务。结果表明,混合优化器在所有任务中均优于纯 LLM 驱动搜索和纯数值优化基线。代码见 https://github.com/vicgalle/hybrid-nested-search。
论文精读
TL;DR 外层LLM生成结构草图,内层数值优化器精调参数,解耦结构探索与参数搜索,提升LLM驱动优化的效率与效果。
问题
问题背景
在自动化算法设计与科学发现的前沿,LLM 驱动的优化器正被用于同时探索程序结构与调优连续参数,希望通过自然语言接口端到端地生成高性能解决方案。
现有方法局限
主流做法将 LLM 作为单一算子,在每轮迭代中既要修改控制流、算子组合等离散结构,又要调整学习率、阈值等连续参数。LLM 擅长结构搜索,但在数值优化上效率低下:它本质是在离散文本空间做试错,每次“跳跃”需消耗大量 token,却难以实现梯度式精细调优,经常陷入“结构已正确但参数未收敛”的尴尬境地,导致搜索预算浪费。此外,这种做法缺乏模块化,无法灵活替换数值求解器。
为什么这个问题难/重要
结构与参数解耦本质是离散-连续混合优化的核心难题。结构空间的组合爆炸要求强大的探索能力,而参数调优需要数值稳定性与收敛保证,两类算子难以用同一机制高效处理。业界关注度持续上升,因为 LLM 驱动的程序合成、AutoML、科研自动化等场景对样本效率与最终性能极度敏感,token 成本高昂。解耦后,LLM 专注于提出结构草图,内层数值优化器(如 CMA-ES、梯度下降、MCMC)负责精细调参,既能发挥各自长处,又支持即插即用的灵活组合,为实际工程部署提供了显著提效路径。
行业类比
类似神经架构搜索(NAS)与超参数优化(HPO)的解耦:用搜索算法生成网络骨架(结构),再用贝叶斯优化调优学习率等(参数),分而治之,避免粗放式联合搜索的低效。
核心洞察
- 结构与参数解耦:传统LLM驱动优化将结构搜索与参数调整混杂在一起,导致LLM在连续参数空间效率低下。本文通过外循环LLM生成结构草图(含数值占位符)、内循环数值优化器(如CMA-ES)微调参数,实现了清晰的解耦,显著减少token浪费,并利用各自优势。
- 可插拔的嵌套架构提升通用性:内外循环优化器均可替换,零阶、梯度、MCMC等均可组合,使得框架适用于元优化、代码策略、贝叶斯推断等多样化任务。实验表明,混合方法在所有领域均优于纯LLM优化和纯数值优化,验证了分工的有效性和普适性。
- 参数去别名化确保稳健性:引入参数清单机制,将名称与数值显式绑定,避免LLM在文本优化中的数值混淆(别名问题),使得结构草图与内循环无缝对接。这一设计解决了混合搜索中常见的参数歧义,增强了框架的可靠性,为工程化实现提供了关键支撑。
方法
输入与问题定义
任务以自然语言描述,目标是最小化或最大化某个性能指标。传统LLM驱动优化中,LLM同时负责生成算法/策略的结构(如控制流、模块组成)与连续参数(如学习率、阈值),导致效率低下。本方法将问题形式化为结构-参数分离的嵌套搜索。
关键模块:双层混合优化
混合搜索包含两个解耦的循环,作用在不同表示层:
外部循环 – LLM 结构提议器
任意文本生成型优化器(如 LLM 作为变异、交叉算子,或直接提示工程)用作外层求解器。它生成结构草图 — 一段包含算法逻辑但数值被占位符替换的文本模板,例如learning_rate = <lr:float>。该模板定义一个参数清单,明确声明当前结构需要调优的连续变量列表。参数去别名化(Parametric De-aliasing)
为每个参数分配唯一标识符,确保同一结构的不同实例间、或不同结构间的同名参数不会冲突,避免适应度评估时参数混淆。这在演化搜索中尤为关键。内部循环 – 可插拔数值优化器
给定结构草图,内层求解器负责寻找最优参数值。它可以是零阶优化器(如 CMA-ES)、基于梯度的方法或 MCMC 采样器,完全独立于 LLM。内部优化器的输出是最佳参数配置下的性能值,该值作为外部结构草图的适应度反馈。
双层目标与优化流程
框架优化一个双层目标:外部循环最大化内部循环返回的最优性能。具体流程:
- 外部优化器根据上一轮结构提议种群及适应度,生成新的结构草图。
- 对每个草图,内部数值优化器接收参数清单和评估函数,运行内部优化步骤(如 CMA-ES 多代进化),返回最佳标量性能。
- 外部优化器收集所有草图的性能,更新种群,重复步骤 1。 循环支持热启动:内部优化器可保存上一次结构对应的参数状态,加速相近结构调优。
输出与部署
最终输出是性能最优的结构草图及其对应的最优参数值,共同构成可直接执行或部署的实体,如数值优化算法、系统控制策略或概率模型的重参数化方案。
与同类方法的差异
LLM 直接作为优化器(如 OPRO)同时处理离散结构和连续参数,迫使 LLM 进行低效的逐字数值猜测;本方法通过结构/参数解耦,让 LLM 专注于其擅长的语义与结构探索,参数优化交于专业数值求解器,显著减少 token 消耗并提高搜索效率。
实验
实验设计
- 实验覆盖三个科学计算领域:(i) 元优化器 在解析测试函数上自动设计优化算法;(ii) 可执行代码策略 在云基础设施调度与社会困境(Cleanup 游戏)中的决策;(iii) 近似贝叶斯推断 在高维后验上的参数重参数化。每个任务均构造双层嵌套:外层由 LLM 提出带数值占位符的结构化代码“草图”(如控制流、函数形式),内层由 数值优化器(CMA-ES、梯度优化或 MCMC 采样器)填充空缺的连续参数。
关键发现
- 混合搜索在所有领域均优于纯 LLM 驱动搜索和纯数值优化基线。LLM 单独优化时在连续参数更新上效率低下,浪费 token 做离散试探;而纯数值方法受限于固定结构。嵌套解耦后,结构探索由 LLM 的语言理解与代码生成能力主导,参数微调由成熟的数值求解器高效完成,实现了互补。
- 在元优化器任务中,混合方法发现了 带有余弦退火学习率调度和梯度裁剪的 Nesterov 加速 等非平凡算法,且避免了纯 LLM 搜索中“别名陷阱”(aliasing trap)。在贝叶斯推断中,混合方法为 Horseshoe 模型学习到 局部非中心化重参数化,显著提升 MCMC 混合效率,成为实验中最清晰的解耦案例。
基线对比解读
- 相较于 vanilla LLM 搜索:混合搜索节省了 LLM 在连续参数空间反复试错的 token 消耗,将 LLM 的能力聚焦于结构创新,使得同等 LLM 调用预算下能探索更复杂的结构空间。
- 相较于 纯数值优化:LLM 的结构先验使得搜索不再从零开始,而是从合理的“结构骨架”出发,大幅降低数值优化的难度,尤其在需要条件分支或函数组合的任务中优势明显。
- 框架的 即插即用 设计允许任意文本生成器与任意零阶/一阶优化器组合,为不同成本与精度需求的工程场景提供了灵活选项。
行业影响
落地场景
该框架将 LLM 的结构生成能力与数值优化解耦,适用于需要同时设计离散结构(如控制流、代码模板、概率图模型)和连续参数的场景。
- 自动化机器学习:AutoML 中搜索神经网络架构(结构)与优化超参数(参数),LLM 生成架构描述,CMA-ES 或梯度优化精调层数、通道数等。
- 云资源调度与策略生成:LLM 编写弹性伸缩规则模板,内部优化器调整阈值和步长,比纯人工规则更精准。
- 概率编程与贝叶斯推理:自动选择重参数化变换(结构),并用 MCMC 采样器优化变换参数,提升推理效率。
- 推荐系统 / 广告投放策略:LLM 产出多级召回或排序规则骨架,数值优化器在业务指标上微调参数,快速迭代。
商业价值
- 降本:减少专家手工设计策略和调参的时间,例如云资源调度策略的自动发现可节省 20-40% 的预留实例成本(论文中云基础设施实验)。
- 增收:推荐系统或广告策略的快速优化直接提升 CTR 或转化率,纯数值方法难以探索复杂组合结构,LLM 的结构跳跃能发现新型模式。
- 体验提升:在对话式 AI 平台中集成该框架,可让非专家用户通过自然语言描述目标,后台自动完成结构探索与参数优化,降低 AI 开发门槛。
与现有产品 / 工作流的集成
- 集成到现有 AutoML 平台:作为 Google Vizier 或 Amazon SageMaker Autopilot 的搜索空间扩展,将结构搜索从预定义候选集拓展到 LLM 生成的新设计方案。
- 嵌入 LLM Agent 框架:与 LangChain 等工具结合,让智能体在决策时不仅能读写文本,还能调用数值优化后端,提升“规划-执行”循环的效率。
- 作为 CI/CD 流水线插件:在模型上线前的性能调优阶段,自动探索不同的预处理流水线和训练策略,取代人工试错。
具体落地 Use Case
- 电商推荐模型架构搜索:LLM 生成多种特征交叉组合的文本描述(如“将用户历史行为序列与商品属性做注意力聚合”),内部数值优化器(如贝叶斯优化)调整注意力维度、温度系数等,上线 CTR 模型。无需人工枚举复杂架构,数小时内可尝试数百种组合。
- 广告竞价动态出价策略:LLM 编写 if-else 规则模板,例如“当预测转化率高于阈值 p 且剩余预算充足时,出价系数乘以 α”,数值优化器基于历史竞价日志微调 p 和 α,实现收益最大化。支持引入多种优化后端(梯度、零阶、MCMC),适应不同业务目标的平滑性要求。
局限
- **LLM 结构搜索的局限性**:外层 LLM 在提出结构草图时受限于自身的生成能力和提示模板,可能反复生成类似或低质量的结构变体,难以突破到全新架构。生成的草图可能包含语法错误或逻辑冲突,需要额外的验证与修正模块,这会增加系统复杂度。此外,LLM 对数值间隙的语义理解不精确,容易混淆参数类型或范围,导致内层优化器失效。在更复杂的结构空间(如深层循环或递归逻辑)中,LLM 的表现会显著下降,限制了框架在高级程序合成任务中的应用。
- **嵌套搜索的计算成本**:混合嵌套搜索要求内层优化器为每个外层结构候选完整运行至收敛,计算开销远高于单一优化方法。特别是当内层采用基于种群的无梯度优化器(如 CMA-ES)时,评估次数可能快速膨胀,使得整体搜索在有限资源下不可行。论文虽提及可插拔性但未提供针对不同预算的自动调度策略,实际使用中用户需要手动权衡外层探索与内层精度,容易陷入局部解与时间成本的抉择困境。在要求快速迭代的场景(如在线策略调整)中,该嵌套开销可能成为瓶颈。
- **超参数敏感性与通用性**:框架的性能对外层 LLM 的采样策略(如温度、提示设计)、内层优化器的选择及其超参数(如种群大小、学习率)高度敏感。不同的任务域需要繁复的手动调优才能复现论文中的提升,缺乏自适应或元学习机制来减轻这一负担。在部分基线对比中,纯数值优化器有时已达性能上限,嵌套方法带来的增益并不显著,表明该架构并非普适有效,其适用场景需要依赖领域知识进行预判,限制了作为通用黑箱优化器的潜力。