OasisKV: 利用 Lookahead 稀疏预取将解码 KV 缓存扩展到 HBM 之外
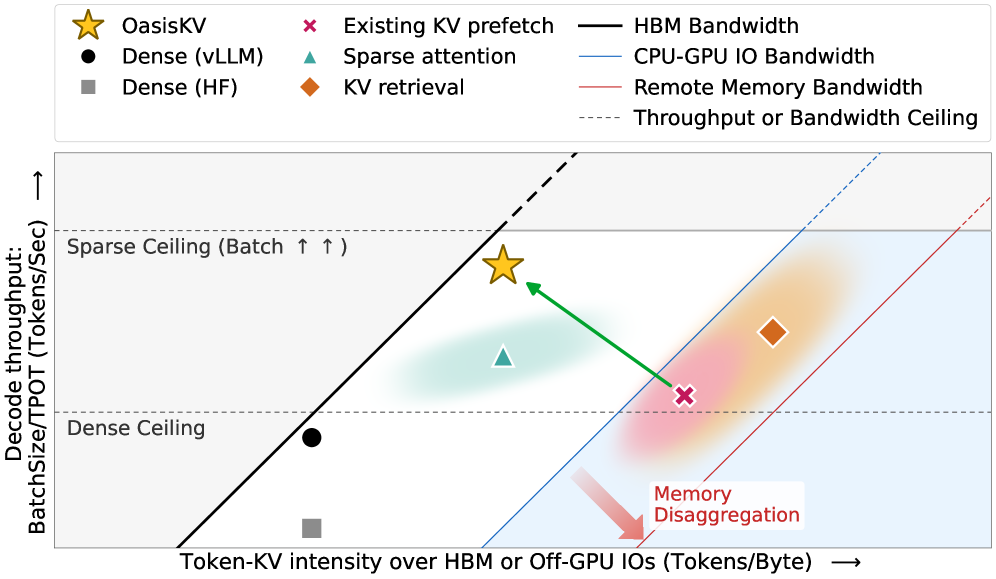
大语言模型(LLM)推理服务正日益受到内存而非算力的制约。随着长上下文和长形式推理工作负载的普及,键值(KV)缓存在 LLM 令牌生成(即解码)期间主导了内存占用和内存流量。特别是,HBM 容量已成为稀缺且昂贵的资源,严重限制了推理批处理大小和系统吞吐量。 本文提出 OasisKV,一种以内存为中心的 LLM 推理系统设计,通过在 LLM 解码期间将完整 KV 缓存存储与 HBM 解耦,缓解 HBM 容量压力。由于解码时的注意力天然稀疏,OasisKV 仅在 HBM 中保留最相关令牌的 KV 条目用于注意力计算。我们观察到,使用推测解码(SD)起草的 lookahead 令牌可以提前准确预测未来重要的令牌。OasisKV 采用高效的注意力后台流水线来识别重要的 KV 块,然后从更高容量的内存层级(如主机或远程内存)预取它们,并在下一步解码使用之前暂存于 HBM。 我们基于 vLLM 实现了 OasisKV。Lookahead 预测足够准确,在 2,048 令牌 KV 预算下,精度保持在完整注意力的 0.7 分以内。这使得 OasisKV 能够将稀疏性转化为吞吐量收益:在推理工作负载上,相比密集 vLLM 达到 1.69 倍吞吐量,精度损失仅 0.1 分;在多 GPU 长上下文服务上,吞吐量提升高达 2.1 倍。在 prefill-decode 分离场景下,OasisKV 达到约 2 倍密集吞吐量,同时每个请求的 KV 占用减少 6.5–9.7 倍,并且解码节点主机内存比完整 KV 传输少 2.2–2.6 倍。
论文精读
TL;DR OasisKV 利用投机解码提前预测未来重要 token,将完整 KV 缓存放于低层内存,仅预取解码所需稀疏 KV 至 HBM,突破容量瓶颈,实现 1.69–2.1× 吞吐提升且准确度损失极小。
问题
问题背景
LLM 推理服务正从计算受限转向内存受限。长上下文推理(例如长文本、详细推理链)使 KV cache 在 decode 阶段的 HBM 占用和带宽消耗剧增,严重限制批处理大小和系统吞吐量。
现有方法局限
已有的 KV cache 稀疏化或分层存储方案存在明显缺陷:
- 静态稀疏模式(如滑动窗口、top-k 的启发式保留)难以捕捉 decode 过程中动态变化的注意力分布,导致关键 token 丢失,精度下降明显。
- 离线分析或基于规则的预取无法实时预测下一个 decode step 真正需要的 KV 块,要么预取命中率低,浪费带宽;要么为了保障精度而过度加载,节省有限。
- 全量 KV 转存到主机或远程内存虽然释放 HBM,但每次 decode 仍需从低层存储拉取大量数据,带宽瓶颈突出,且在 prefill-decode 分离架构下 decode 节点的主机内存压力极大。
为什么这个问题难且重要
技术挑战:decode 时的注意力天然稀疏(往往只需前序 token 中的一小部分),但准确、快速地动态定位这些重要 token 十分困难,因为注意力模式随生成内容实时变化。低延迟推理场景要求预取开销极小,任何过多的额外计算或数据搬运都会抵消吞吐增益。 业界关注度:大模型上下文窗口已扩展至 128k 甚至 1M token,HBM 容量却是固定的,每块 GPU 的 80GB 空间很快被 KV cache 耗尽。有效降低 decode HBM 占用成为提升服务效率与控制成本的关键,各大推理框架(vLLM、SGLang 等)均积极探索相关方案。
行业类比:就像推荐系统中针对超长用户行为序列进行实时稀疏检索与精准预取一样,在长文本生成中准确捕捉最相关的历史信息,是平衡效率与准确率的通用性难题。
核心洞察
- 将推测解码的草稿令牌转化为KV缓存预取的精确信号,使解码注意力从预测中直接获益。传统稀疏注意力依赖离线统计或启发式规则,无法适应上下文动态变化;OasisKV巧妙利用推测解码本身生成的多步前瞻tokens,在线、准确地预测未来注意力模式,从而在极低KV预算下(2048 tokens)保持模型准确率(差距<0.7点),而其他工作如H2O、StreamingLLM在类似预算下往往存在较大精度损失。
- 异步背景流水线使KV管理完全脱离关键路径,将内存带宽瓶颈转化为吞吐增益。与同步的KV卸载(如FlexGen)或逐层重计算不同,OasisKV的前瞻注意计算和预取都在后台异步执行,与主解码通路无依赖,因此KV预取和传输延迟基本被隐藏。这使得在真实推理负载下,即使面对有限带宽的异地存储,也能实现1.69倍至2.1倍吞吐提升,而不会增加单个请求的延迟。
方法
输入:推理请求到达后,其完整 KV 缓存驻留在高容量、低带宽的远端/主机内存中,HBM 仅保留动态选择的关键 token 的 KV 块。当前解码步的查询向量 Q 与 HBM 中的局部 KV 执行注意力计算,生成下一个 token;同时利用推测解码(speculative decoding)草拟出多个 lookahead tokens,这些草稿 token 作为后续重要性的预测依据。
关键模块
- 低开销前台注意力:在 HBM 上的稀疏 KV 上完成精确注意力,仅需少量数据搬移,保证生成延迟不膨胀。
- 全异步后台 Lookahead 注意力:利用草稿 lookahead tokens 在后台对远端完整 KV 做注意力打分,计算出每个 KV 块的重要性分数,整个过程与前台解码并行,不阻塞 token 生成。
- Delta 选择与上限驱逐:将后台计算的重要块与当前 HBM 驻留块比较,只传输增量部分(delta),并设置 HBM 缓存容量上限,超过时驱逐最不重要的块,防止缓存污染。
- 远端部分拉取:对于多节点 disaggregation 场景,支持从远程内存按需拉取部分 KV 块,通过网络预取进一步隐藏延迟。
输出
每个解码步生成新 token,且 HBM 中的 KV 缓存始终迭代更新以覆盖未来所需的重要上下文。系统整体吞吐量因 HBM 容量压力降低而提升 1.69–2.1 倍,精度损失控制在 0.1–0.7 点内。
与同类方法的差异:现有稀疏 KV 预取方案(如 InfiniGen)依赖静态规则或单步注意力选择,而 OasisKV 利用推测解码的 lookahead tokens 对未来多步注意力进行准确预测,并通过异步流水线将预取开销完全隐藏在解码关键路径之外,实现了预测驱动的动态稀疏化,而非被动局部近似。
实验
实验设计
OasisKV 基于 vLLM 实现,评估覆盖单/多 GPU 服务、prefill-decode 分离和真实推理工作负载。系统利用 speculative decoding 生成 lookahead tokens,通过异步背景流水线预测重要 KV 块并预取至 HBM,默认 KV 预算 2048 tokens。基线包括密集 vLLM 及其他稀疏注意力方案。
关键发现
在推理工作负载上,OasisKV 以仅 0.1 点准确度损失实现 1.69× 吞吐量提升;在多 GPU 长上下文服务中提升高达 2.1×;在 PD 分离下吞吐量翻倍,同时 KV 需求减少 6.5–9.7 倍,主机内存减少 2.2–2.6 倍。即使 KV 预算严苛(如 512 tokens),准确度下降也控制在 2.9 点以内。
基线对比解读
相比密集 vLLM,OasisKV 将注意力稀疏性切实转化为吞吐量增益,远超简单将 KV 缓存移至低层内存的方法。其前瞻预取机制精度高,有效隐藏了多级内存访问延迟,而异步背景处理避免了影响关键路径。对比现有稀疏检索方法,OasisKV 在更低 KV 占用下仍能保持竞争力,凸显 lookahead 预测与 delta 选择策略的优势。
行业影响
落地场景
OasisKV 直接适用于长上下文、长形式推理的大语言模型推理服务,典型业务包括:
- 代码助手:处理整个仓库级别的上下文代码补全与问答。
- 企业知识库问答:基于多文档的法律、金融、医疗合规审查,需要一次性摄入长文本并生成详细报告。
- 多轮对话系统:客服、教育辅导等场景中,对话历史可长达数万 token,KV 缓存成为瓶颈。
- Disaggregated 推理集群:预填充与解码分离的架构中,解码节点 HBM 压力尤为突出,OasisKV 可大幅降低解码节点的存储与传输开销。
商业价值
- 降本:通过将完整 KV 缓存卸载到 CPU 内存或远程存储,HBM 容量需求大大降低,允许在同样 GPU 上运行更大批量或使用更便宜的 GPU,显著降低单次推理的硬件成本。
- 增收:更高的吞吐量意味着相同资源可服务更多并发用户,直接提升 API 服务或 SaaS 产品的收入上限;对于云服务商,可提高 GPU 实例的利用率与投资回报率。
- 体验提升:在长上下文场景下,OasisKV 能在保持精度的同时维持低延迟(实验表明精度损失控制在 0.7 点以内,吞吐提升至 1.69–2.1 倍),避免因内存不足而截断上下文或拒绝请求,保障端到端服务质量。
与现有产品/工作流的接口
OasisKV 基于 vLLM 实现,而 vLLM 是生产环境中使用最广泛的 LLM 推理引擎之一。集成要点:
- 非侵入式部署:可作为 vLLM 的插件或调度策略扩展,无需改动模型权重或推理逻辑。
- 存储层级适配:需要预先配置高容量内存池(例如 CPU DRAM 或 RDMA 连接的远程内存),并调整
KV budget(论文中设为 2048 token)以平衡精度与性能。 - 网络与带宽规划:在 disaggregated 场景下,需评估解码节点与存储节点之间的网络带宽,确保预取延迟可控;OasisKV 的部分传输 + 网络预取机制可有效利用带宽。
- 与投机解码协同:业务若已启用投机解码,OasisKV 可复用其生成的 lookahead tokens,无额外开销;若未启用,则需引入轻量级 draft model。
具体落地 use case
- 电商智能客服:日均百万级会话,历史消息长达数百条。OasisKV 让单个 GPU 能承载更多并发对话,同时保证长上下文下的回答相关性,避免因 KV 缓存溢出导致上下文丢失。
- 在线教育 AI 辅导:一对一的编程或数学辅导中,需要跟踪学生数十步的推理轨迹与对话历史,OasisKV 可在保留完整上下文的前提下,将单卡并发辅导能力提升近一倍,直接降低运营成本,并保障高峰时段的响应速度。
局限
- OasisKV 的准确性和吞吐量提升严重依赖**投机解码(speculative decoding)**生成的前瞻 tokens 的预测能力。如果 draft model 与 target model 的对齐程度不足,或工作负载本身缺乏可预测的注意力模式(例如高度随机或创造性生成任务),前瞻注意力的准确率可能下降,导致重要 KV 块识别错误,从而引入显著的精度损失。论文主要在长上下文推理和某些基准上验证,未充分讨论这种依赖在更广泛任务上的鲁棒性。
- 系统设计引入了额外的**异步后台管线**来执行前瞻注意力计算和 KV 块的预取,这虽然与主解码阶段解耦,但仍会消耗一定的 GPU 计算和内存带宽资源。在 GPU 利用率已接近极限的高吞吐场景下,后台任务可能成为新的瓶颈或者与前台产生资源竞争,抵消部分吞吐增益。论文没有详细量化后台开销对所有模型和硬件配置的影响,可能在某些部署中性能提升不如预期。
- OasisKV 的有效性建立在**解码阶段注意力自然稀疏**这一假设上,即仅少量 token 对下一个 token 的生成至关重要。对于某些对抗性用例或注意力分布非常平坦的任务,该假设可能不成立,导致 HBM 中保留的少量 KV 不足以覆盖关键信息,精度劣化可能超出可接受范围。同时,论文的评测主要集中在 LLaMA 系列模型,缺乏对非 Transformer 架构或多模态模型的考量,泛化性有待进一步验证。