Evidence-RL: 面向证据密集型视觉推理
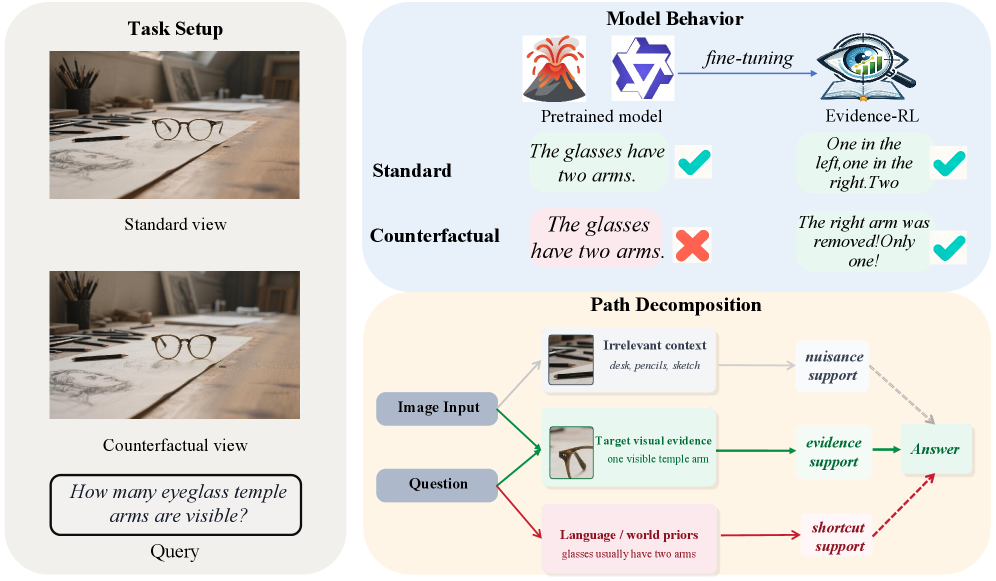
视觉语言模型(VLM)应从具体图像证据,而非语言先验、数据集捷径或无关视觉上下文中作答。现有的感知感知后训练方法通过全局扰动或注意力代理鼓励图像使用,但并未测试采样答案是否因果依赖于支撑它的局部证据。 为此,我们提出反事实证据解耦(CED)——一种针对 VLM grounding 的训练时证据审计。对于每个回答,CED 会中立化一个以对象为中心的证据区域,并将支持度下降与匹配的非证据区域比较。我们将此信号与 GRPO 内的答案正确性结合,奖励依赖证据路径而非捷径或干扰路径的正确答案。CED 使用弱对象级提议,无需问题特定证据标注,且不增加推理时开销。 在九个公开基准和四个主干网络上,CED 优于先前的基于 RL 的后训练方法,针对性分析验证了其以对象为中心的信号。
论文精读
TL;DR Evidence-RL 通过反事实证据解耦在 GRPO 训练中审计 VLM 回答对局部图像证据的因果依赖,抑制语言先验与无关上下文,实现强证据驱动的视觉推理。
问题
视觉语言模型 (VLMs) 在多项视觉推理基准上表现亮眼,但业界逐渐意识到模型常依赖语言先验、数据集偏见或无关视觉线索给出答案,而非真正基于图像中的具体证据。这使得模型在实际部署中的可靠性和可解释性受到质疑。
现有感知感知后训练方法(如全局图像扰动、注意力图代理奖励)虽尝试鼓励模型使用视觉信息,却存在根本缺陷:它们无法验证一个采样答案是否因果依赖于支持该答案的局部证据区域。这类方法仅度量“是否看了图像”,却无法区分模型是真的聚焦于关键物体,还是被非证据背景(nuisance regions)所干扰,或通过统计捷径匹配答案。因此,模型仍可能产生看似合理但缺乏视觉根据的幻觉。
构建可审计的证据依赖在技术上极具挑战。首先,获取细粒度、问题级别的证据标注成本高昂且不可扩展;其次,训练时需对局部视觉区域进行因果干预,同时避免破坏模型主干的表征能力;再次,如何将该信号无缝融入强化学习后训练流程(如 GRPO)并保持零推理开销,是工程落地的一大难点。然而,在医疗影像诊断、自动驾驶等高安全领域,模型必须能够“指认”其决策的依据,否则错误的置信度将带来严重后果。因此,全球 AI 研究机构正积极探寻无需手动标注、可直接在训练中强化证据 grounding 的实用方案。
这好比医学影像 AI 系统不仅要报告“病变”,更需圈出具体的病灶位置——视觉问答同样要求模型具备从图像中定位并依赖关键证据的能力。
核心洞察
- 从“图像感知”到“因果证据依赖”:现有 VLM 后训练方法多通过全局扰动或注意力鼓励视觉使用,却未验证答案是否真正源自局部证据。CED 首次提出训练时反事实审计,通过局部遮掩证据区域并对比回答支持度变化,直接量化答案对证据的因果依赖,从而压制语言先验和捷径,为可解释的视觉推理提供新方向。
- 弱监督证据提议与 GRPO 的轻量结合:CED 利用现成对象检测器生成弱监督证据区域,无需问题级人工标注,显著降低落地成本。将该证据依赖信号整合为 GRPO 奖励项,无需增加推理开销,即可训练模型在正确回答同时依赖正确视觉路径。实验表明此方案对提议质量鲁棒,跨 9 个基准、4 种主干均有效,工程可行性高。
- 反事实脱钩作为通用视觉审计接口:CED 通过对比证据区与非证据区的回答支持度差异,构建局部空值模型,不依赖具体任务标注,可迁移至不同 VLM 和推理范式(直接回答或思维链)。分析显示该机制能区分相关与无关证据,且对空间扰动不敏感,表明其可能成为多模态模型证据感知训练的通用组件。
方法
输入
图像和自然语言问题作为 VLM 的输入,模型生成包含思维链(CoT)或直接答案的响应。
关键模块
1. 反事实证据解耦(CED)
CED 在训练时充当证据审计器,为每个生成的响应计算一个 证据依赖性信号。具体流程:
- 通过弱监督对象提议获取候选证据区域(无需人工标注)。
- 对每个响应,选择与其语义最相关的区域作为 Evidence Region,同时选取语义无关的区域作为 Non-evidence Region。
- 执行 反事实干预:用均值特征替换 Evidence Region,观测模型对该响应预测概率的下降幅度,得到 证据边际。
- 对比 Non-evidence Region 干预后的概率变化作为局部基线,从而排除全局扰动带来的噪声。
最终信号量化了答案对局部证据的因果依赖程度,避免被语言先验或数据集捷径欺骗。
2. 证据引导的 GRPO(Evidence-RL)
将 CED 信号融入 Group Relative Policy Optimization(GRPO) 的奖励设计中:
- 基础奖励:答案正确性(+1 正确,-1 错误)。
- 证据奖励:若答案正确且 CED 信号强(依赖证据),额外给予正向奖励;若正确但信号弱(依赖捷径),则抑制。
- 若答案错误,无论证据依赖如何均不给予额外奖励,避免错误答案被强化。
该奖励结构引导策略在优化正确性的同时,强化对视觉证据的利用。
输出
训练后 VLM 在推理时无额外开销,直接以常规方式生成回答。模型学会优先从图像证据中提取支持,而非依赖语言先验或无关视觉语境。
与同类方法的差异:CED 首次在 RL 后训练中引入 对象级反事实干预来审计证据依赖性,而以往方法仅通过全局扰动或注意力代理间接鼓励图像使用,无法验证答案是否真正因果源于局部视觉证据。
实验
实验设计
在 9 个公开视觉推理基准(如 OKVQA、TextVQA、POPE 等)与 4 个主流 VLM 骨干(LLaVA 系列等)上评估,对比多种 基于 RL 的后训练方法(如 PerSAM、G-LLaVA)。CED 利用弱监督目标提议(SAM)构建证据/非证据区域,无需问题级标注,在 GRPO 框架中将回答正确性与反事实证据依赖信号结合作为奖励,且推理阶段无额外开销。
关键发现
- 证据依赖性信号有效:反事实抹消证据区域后,正确回答的支持度显著下降,而非证据区域消融影响微弱,验证了奖励能精准识别因果依赖。
- 一致优于先前方法:在所有基准和骨干上取得提升,尤其在需要 细粒度证据推理 的任务(如 TextVQA、POPE)上优势更明显。
- 奖励高度鲁棒:对提议质量不敏感,均值替换干预类型产生最强判别信号。
- 克服语言偏置:在 FREAK 等语言先验数据集上,迫使模型依赖视觉证据而非语言捷径。
- 自进化能力:模型可通过自身证据闭环迭代提升,文本能力不退化。
与基线对比的深度解读
传统感知奖励依赖全局扰动或注意力代理,无法验证答案是否因果依赖于特定局部视觉线索。CED 通过 对象级反事实审计 首次直接测试答案的证据依赖性:比较证据区域与匹配的非证据区域被干预后的支持度差异,以此惩罚利用无关上下文或语言捷径的正确回答。这种细粒度 grounding 监督 使模型在证据定位任务上比单纯 GRPO 或感知代理方法鲁棒性更强,且无需昂贵的人工证据标注,提供了一种可扩展的视觉推理强化学习范式。
行业影响
落地场景
Evidence-RL 直接服务于所有依赖视觉语言模型(VLM)进行关键决策的产品,核心诉求是让模型回答真正扎根于图像证据,而非语言捷径或无关上下文。典型场景包括:
- 电商内容审核与商品识别:平台需验证商品图片是否与描述一致(如颜色、材质、缺陷),模型若过度依赖标题元数据而非图像本身,容易造成漏判或误判。
- 医疗影像辅助报告:根据 X 光或病理切片生成诊断建议时,必须确保结论来自影像中的病灶区,而非训练数据中的报告模板或病史文字。
- 自动驾驶感知:车辆需要基于摄像头画面识别临时路标、异常障碍物,若模型被训练分布中的常见场景先验误导,可能忽略关键视觉证据。
- 文档理解与企业流程自动化:发票、合同关键字段提取需对齐图像区域,而非依赖 OCR 文本的语言模式。
商业价值
- 降低错误成本:许多 VLM 存在“幻觉”或“有图不看”的问题,CED 奖励函数迫使模型依赖证据,显著减少因视觉忽略导致的质量事故,如电商错误属性匹配的退货成本、医疗误诊的声誉风险。
- 提升用户体验与信任:可解释的视觉依据让用户能验证模型决策,增强对产品智能的认可度;在内容审核场景下,避免因过度依赖文本先验而误伤合规内容,保护用户体验。
- 无缝集成,零推理开销:CED 仅在训练阶段作为奖励信号引入(与 GRPO 等 RL 框架兼容),推理时无需任何额外计算,对已部署的 VLM 产品流水线无任何速度或资源影响,升级成本极低。
与现有产品/工作流的接口
- 后训练阶段即插即用:方法基于弱监督的对象提议(如从 SAM 等模型提取的候选区域),不要求人工标注证据边界框,可自动嵌入现有 VLM 的 RL 微调流程。
- 奖励信号替换:在原有的 GRPO 或 PPO 奖励中,加入
reward = correctness * (1 + λ * evidence_margin),即可让模型学会关注证据区域,无需改动模型架构或数据管道。 - 泛化能力强:已验证在 Qwen2-VL、InternVL2 等主流开源 VLM 上有效,且跨多个数据集(共 9 个基准)均有增益,便于集成到不同的产品栈中。
具体落地 Use Case
- 跨境电商商品上架审核:卖家上传商品图时,系统需自动判断是否包含违禁品或与文本描述不符。现有模型可能看到“仿冒品”文字就直接拒绝,但 CED 引导的模型会严格比对图像区域,减少误判;对于“真皮”标签纠纷,可提供图像斑点特写作为证据,提升纠纷处理的自动化率和公信力。
- 远程医疗平台影像问答:患者上传皮肤镜照片并描述症状,模型给出初步评估并高亮疑似病灶区域。采用 Evidence-RL 后,模型不会单凭“瘙痒”等文本描述给出诊断,而是确保视觉特征与回答有因果依赖,降低因语言先验导致的误导向,提高医生复核效率与安全性。
局限
- - **证据区域粒度受限于物体级提议**:方法依赖弱监督物体检测器生成证据区域,因此主要适用于物体为中心的视觉证据。对于需要更细粒度属性判断、空间关系、计数或抽象视觉推理的任务,CED 的证据审计可能不充分,FREAK 等刻意注入语言偏见的基准上的剩余差距表明此局限。
- - **训练额外计算开销**:CED 在训练时需为每个响应额外执行至少两次干预前向(证据区域与非证据区域),并计算支持度变化,这增加了训练成本。虽然推理时无开销,但与仅用全局扰动的感知感知 RL 方法相比,训练效率可能较低,可能限制在大规模 VLM 上的应用。
- - **干预实现敏感于视觉编码器架构**:区域干预依赖 token 映射和向量替换策略,对视觉编码器的 spatial-merge 方式敏感,可能引入人工痕迹,导致模型学习对抗干预而非真正证据依赖;跨不同 VLM 架构(如卷积 vs. ViT)迁移时,需重新调整替换方式和超参数,泛化鲁棒性有待验证。