TSDS-Toolbox: 用于度量时间序列数据集相似度的工具箱
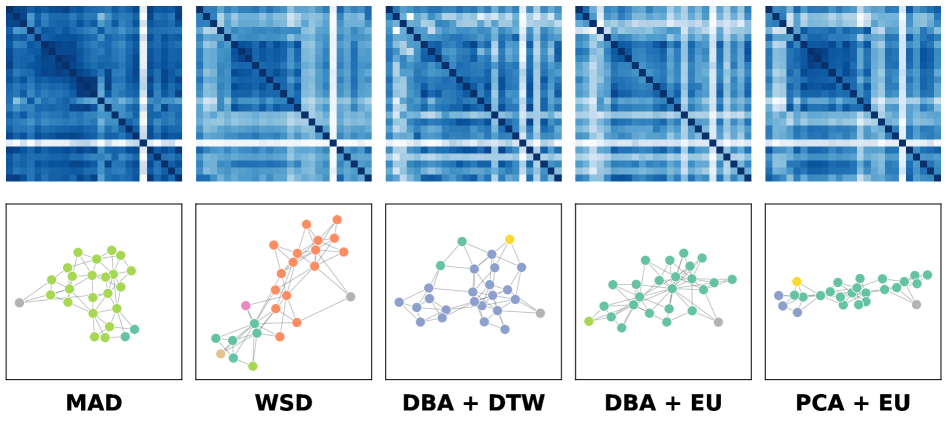
人工智能(AI)的快速发展显著加速了时间序列分析研究,尤其体现在预测、分类和生成任务中。近期模型,特别是基础模型,受益于时间序列数据集相似度——它在微调时的源数据集选择中扮演重要角色。然而,许多现有实现用于基准测试时间序列数据集相似度方法时较为碎片化,且难以扩展。 为应对上述挑战,我们提出统一框架 TSDS-Toolbox(时间序列数据集相似度工具箱)。该工具箱支持:(1) 对时间序列数据集相似度方法进行系统化、可复现的比较;(2) 用户可灵活扩展,添加自定义数据集、相似度方法和下游时间序列任务;(3) 通过集成时间序列数据集缩减器,对数据集级和序列级相似度方法进行一致评估。 通过多样实验设置下的综合实验,验证了 TSDS-Toolbox 的有效性,且工具箱已公开可用。
论文精读
TL;DR TSDS-Toolbox 统一量化时间序列数据集相似性,支持可复现对比与灵活扩展,一致评估数据集级和序列级相似性,简化源数据集选择与微调。
问题
问题背景
时间序列分析在预测、分类、生成等任务中进展迅速,基础模型(如 TimesFM / MOMENT 等)依赖大规模预训练,而 数据集相似性 正成为源数据集选择与微调的关键因素。
现有方法局限
现有时间序列数据集相似度方法各自实现,碎片化严重:
- 缺乏统一基准:不同论文使用不同度量、不同评估协议,结果难以复现与对比。
- 数据集级与序列级方法割裂:序列级相似度(如 DTW / Soft-DTW 等)无法直接用于数据集整体比较,缺少 数据集 reducer 的标准化集成。
- 扩展性差:添加新数据集、相似度方法或下游任务需大量重复工程,难以适应快速迭代的基础模型实验需求。
- 评估不统一:相似度对下游任务(fine-tuning 性能)的实际影响缺少系统化评估。
为什么这个问题难/重要
时间序列数据集具有 高维、异质、长度不等、非平稳 等特性,相似度的定义强烈依赖下游任务——预测任务关注趋势与季节性,分类任务关注判别模式,生成任务关注分布结构。因此,一个可扩展、可复现的统一工具箱对于推进基础模型在时间序列上的迁移与适配至关重要。业界在构建时间序列基础模型时,亟需快速筛选相关源数据集,减少试错成本。
行业类比
类似 NLP 领域中的预训练数据与目标任务的匹配度评估工具,TSDS-Toolbox 可视为时间序列领域的“数据适配度仪表盘”,帮助工程师在微调前量化候选数据集的潜在价值。
核心洞察
- TSDS-Toolbox 通过集成时间序列数据集 reducer,统一了 dataset-level 与 series-level 相似性度量,解决了以往碎片化实现难以比较和扩展的问题。现有时间序列数据集相似性方法多分散在不同代码库中,缺乏统一评测协议,导致不同论文的结果难以复现或公平对比;该工具箱提供标准化管道(数据层-相似层-评估层-分析层),将任意相似性方法接入一致的评价框架,并允许用户添加自定义 reducer,使数据集级与序列级方法在同一基准下比较,这是同类工作缺乏的系统性设计。
- 该工具箱将相似性度量与下游任务(预测、分类、生成)解耦,强调可扩展性,直接服务于基础模型微调中的源数据集选择。随着时间序列基础模型兴起,选择相似源数据集进行微调对性能至关重要;但以往工作往往为特定模型或任务硬编码相似性计算,难以迁移。TSDS-Toolbox 允许用户在不修改核心框架的情况下添加新数据集、相似性方法和下游任务,使研究者能快速评估“数据集相似性”对迁移学习收益的影响,从而推动以数据为中心的 AI 流程。
方法
TSDS-Toolbox 采用分层管道设计,将时间序列数据集相似度度量拆解为 Data Layer → Similarity Layer → Evaluation Layer → Analysis Layer 的流水线。
输入与准备
- 输入为任意时间序列数据集,可为单变量或多变量序列,并可选关联下游任务标签(如分类类别、预测目标)。
Data Layer统一加载、缓存与标准化数据集,提供接口注册自定义数据源,支持不同格式与规模。
关键模块
- Similarity Layer 封装多种相似度方法,分为 dataset-level(直接对整数据集提取特征/统计量计算距离)与 series-level(先计算序列对相似度,再聚合)。
- 核心创新是集成 time-series dataset reducers:将任意序列级相似度矩阵通过可插拔 reducer(如均值、最大池化、注意力加权等)转换为数据集级分数,从而用同一评估协议统一两类方法。
- Evaluation Layer 将相似度分数与实际性能绑定:将选出的相似源数据集用于下游任务(如 forecasting / classification / generation)微调,记录目标数据集上的精度、损失等指标,作为相似度方法的间接验证。
- Analysis Layer 负责输出基准报告、可视化排名、方法稳定性统计,便于横向比较。
输出
- 为每种相似度方法生成标准化的数据集相似度矩阵与下游任务性能对照表,用户可据此选择最优源数据集或扩展新方法。
与现有碎片化实现相比,TSDS-Toolbox 的差异点在于通过统一的 reducer 抽象桥接序列级与数据集级相似度,并在同一框架内同时支持可复现基准与可扩展插件机制。
实验
实验设计
论文摘要指出 TSDS-Toolbox 在多种时间序列任务(forecasting / classification / generation)下验证了工具箱的有效性,并强调实验覆盖 dataset-level 与 series-level 相似度方法以及集成 reducer 的一致性评估。但正文摘录未给出具体数据集名称、规模或评估指标数值,因此无法准确枚举数据集清单或量化结果。
关键发现
工具箱的核心贡献在于提供统一、模块化的基准框架,使不同粒度的相似度方法能在同一评价协议下对齐。作者称其验证了在多样实验设置下的有效性,但未披露定量对比数据。从工程角度看,该工具箱解决了相似度基准实现碎片化、难扩展的问题,允许用户自定义数据集、相似度方法与下游任务,便于复现与公平测评。
与基线对比
现有实现多为独立代码仓库,缺乏统一接口与可扩展性;TSDS-Toolbox 通过数据层、相似度层、评估层与分析层的解耦设计,提供了系统化比较与拓展能力。虽然缺少具体数值对比,但其模块化设计本身即构成对碎片化基线的工程改进,为后续研究提供了可维护的评测基础设施。
行业影响
落地场景
TSDS-Toolbox 可直接用于时间序列基础模型(如 TimesFM、Chronos)微调前的源数据集筛选。在金融、零售、工业 IoT、医疗监护等场景,团队需从大量历史传感器或业务数据中挑选与目标域相似的数据集做 few-shot 或 fine-tuning。该工具箱提供统一接口,支持数据集级与序列级相似度度量,可嵌入数据管理平台用于数据集检索与推荐。例如,电商平台为新品类销量预测模型快速匹配历史相似品类数据;自动驾驶公司评估新采集路测数据与已有训练分布的差异。
商业价值
主要价值在降本增效:减少人工比对数据集的时间,避免盲目训练失败带来的 GPU 成本浪费。对数据交易或共享平台,相似度搜索能力可作为增值服务,提升数据集匹配准确率与成交转化。对模型运维团队,快速判断新数据是否“分布外”,能提前预警模型漂移,降低线上事故风险。
与现有工作流接口
工具以 Python 包形式发布,可集成到MLOps 流水线:在数据摄取阶段调用 TSDS-Toolbox 计算新数据集与基准数据集的相似度,将结果作为元数据写入特征存储或数据目录(如 Feast / Amundsen)。也可封装为 REST 服务,供 AutoML 平台或数据标注平台调用。其模块化设计允许自定义相似度方法和 reducer,适配不同业务指标。
局限
- 该工具箱的核心贡献在于**统一现有时间序列数据集相似性方法**,而非提出新的相似性度量算法。因此其创新性主要停留在工程整合层面,在方法学上的突破有限。对于需要新颖相似性度量来解决特定任务的研究者,该工具箱无法直接提供算法层面的改进,仍需依赖已有方法或自行扩展。
- 实验部分虽然声称在多种实验设置下验证了有效性,但论文摘要未明确给出与现有专用实现或基准的定量对比结果,难以评估统一框架带来的实际性能提升或开销。此外,工具箱的扩展性、易用性等指标缺乏系统化的用户研究或大规模社区验证,可能影响其在复杂真实场景中的可靠性。
- 工具箱依赖于内置的**时间序列数据集降维器**来统一数据集级和序列级相似性评估,但降维过程可能引入信息损失,特别是对于高维或长序列数据。对于不同特性的时间序列(如多变量、不规则采样、长时序),降维器的选择和参数设置对相似性结果影响较大,工具箱未深入探讨这种敏感性。