Factorized Hypothesis Search for Evidence-to-Taxonomy Retrieval
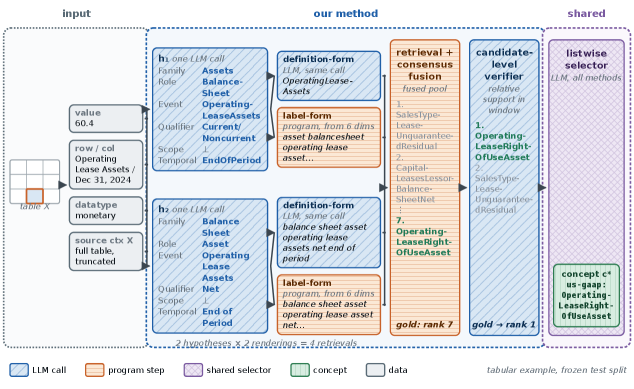
大型分类体系检索通常假设输入已经直接表达目标概念。然而在许多场景中,输入是间接证据,例如表格单元格,其含义取决于行、列、数据类型和上下文。我们将这种不匹配称为检索就绪差距(retrieval readiness gap)。分析表明,当语义明确时,现有索引能可靠检索到目标;而原始证据往往使其深藏于排序结果中。 为此,我们提出因子化假设搜索(Factorized Hypothesis Search, FHS),在命名的语义维度上维护多个部分解释。这些假设支持结构化查询渲染、多假设检索以及维度级候选验证。在金融分类体系标注和CodiEsp 临床编码任务上,FHS 在非 oracle 方法中取得了最好的 Recall@1、MRR 和最终准确率。将因子化假设路径替换为自由文本集成会导致头部排序性能最大幅下降,而顺序细化相比 FHS 强大的并行首轮并未带来额外收益。
论文精读
TL;DR 针对间接证据到大型分类法的检索准备差距,FHS 将证据按语义维度分解为多个假设,并行结构化查询与维度级验证,在金融标签和临床编码任务中显著提升精确率,优于自由文本集成与顺序细化。
问题
问题背景
信息检索领域正从显式查询扩展到证据驱动的概念定位,如表格单元格到分类体系的映射。这类任务要求系统从非结构化证据中推断隐式语义,而非直接匹配关键词。
现有方法局限
现有大规模分类体系检索通常假设输入已明确表达目标概念。但在证据到分类体系(evidence-to-taxonomy)场景中,输入是间接证据(如表格单元格),其含义依赖于行、列、数据类型和上下文。分析表明,当前索引仅在语义显式时可靠检索,原始证据往往导致目标项在排序中沉底。
- 检索准备度鸿沟(retrieval readiness gap):证据与可检索概念之间的语义差距,使传统 BM25 或稠密检索难以跨越。
- 单次解释脆弱:直接生成全文解释或单条假设,容易受歧义影响,且缺乏结构化约束,导致精度不足。
- 缺乏维度级验证:现有方法未对命名语义维度(如实体、事件类型、数值约束)进行分解校验,结果可解释性差。
问题的难度与重要性
证据到分类体系的歧义源于多维度语义交织:同一表格单元格可能同时关联不同的行上下文、列标题和数据类型,单一解释极易产生错误锚定。业界关注该问题是因为它广泛存在于金融报告自动标注、医疗编码、电商产品分类等需要从非结构化片段推导标准概念的高价值场景,错误代价高且人工核对成本巨大。
技术挑战在于:检索系统必须同时保持高召回(不遗漏潜在相关概念)与高精度(在数十万规模分类体系中精准定位),而证据与概念之间的语义鸿沟无法仅靠增大模型或索引解决。
行业类比
类似基于患者主诉的描述性文本推断 ICD 编码,需综合症状、病史、检查结果等多维度线索,而非直接输入诊断名——任何单一维度信息都不足以准确定位。
核心洞察
- **检索准备度差距** 重新定义了证据到分类的检索任务,指出原始输入(如表单元格、临床片段)通常不直接包含目标概念,现有索引只在语义显式时可靠。FHS 将此差距建模为解释性差距,通过因子化假设在多语义维度上保持并行部分解释,而非试图提前消歧或强制单一解释。这一视角的独特性在于:它不将检索困难归咎于索引侧,而是承认输入侧的解释多样性必然存在,因此系统地生成、结构化查询并联合验证多个候选路径,从根本上提升了隐式概念的检索召回精度。
- **分解假设搜索优于集成与顺序细化**。消融实验表明,用自由文本集成替代因子化假设路径会导致头部排名性能最大幅下降,而顺序细化(即便在弱单轮基础上有所增益)在 FHS 的强并行首轮之后不再提供额外提升。这揭示了两点工程经验:(1) 结构化查询渲染与维度级验证比随意生成多个自由文本查询更利于保持解释的忠实性和可控性;(2) 并行多假设探索的收益已接近该框架的上限,无需引入迭代式自校正即可实现高质量检索,从而简化架构并降低推理延迟。
方法
FHS 针对间接证据检索问题,将输入分解为多个维度上的部分解释,通过结构化查询、并行检索与验证提升概念定位的精确度。其工作流如下:
输入与问题建模
输入为包含间接证据的文本片段(例如表格中的单元格,其含义依赖所在行、列、数据类型及上下文),需映射到大规模分类法中的目标概念。当前检索器在语义显式时表现可靠,但原始证据常导致目标排名靠后。
核心模块
因子化假设生成 (Factorized Hypotheses)
将输入证据沿预设的命名语义维度(如row_meaning、column_meaning、datatype)生成多个部分解释。每个维度产生一种假设,各假设独立但共享上下文。结构化查询渲染 (Query Rendering)
将因子化假设组合为可被检索引擎理解的结构化查询。不同组合方式产生多条查询,覆盖证据可能的解释空间。多假设检索 (Multi-hypothesis Retrieval)
并行执行所有查询,从分类法索引中召回候选概念。每条查询返回一个排序列表,保证候选池的多样性。候选级验证 (Candidate-Level Verifier)
针对每个检索到的候选,验证器按维度(如match_row、match_column)评判它与原始证据的一致性,并给出维度级得分,过滤不匹配的候选。共识融合 (Consensus Fusion)
聚合多个假设下的候选分数,通常采用加权求和或归一化,输出最终排序。
输出与差异点
FHS 输出一个重排序的候选概念列表,显著提升 Recall@1 和 MRR。与自由文本合奏方法不同,FHS 通过因子化假设保持解释的并行性,避免过早地将证据固化为单一语义,从而减少信息损失;同时,验证器在维度级操作,比整体式验证更精细。实验表明,顺序细化(Sequential Refinement)无法在 FHS 强大的并行第一轮基础上提供额外增益,印证了其设计的有效性。
实验
实验设计
论文在两个真实场景的 证据到分类体系检索 任务上评估:
- 财务分类标记:从表格单元格等间接证据中推断概念,挂载到大规模金融分类体系。
- CodiEsp 临床编码:将临床文本中的隐式表述映射到 ICD-10 编码。
对比方法覆盖多种检索策略:直接检索、单轮归因(结构化 / 自由文本)、并行采样、分解检索、自修正以及依赖检索反馈的迭代细化。FHS 通过 因子化假设 在多个语义维度(如行、列、数据类型、上下文)并行生成部分解释,再结合 结构化查询渲染、多假设检索 与 维度级候选验证 进行共识融合。所有方法在相同骨干模型与索引下比较,严格控制假设数量与计算预算。
关键发现
- FHS 在非 Oracle 方法中取得最佳 Recall@1、MRR 与最终准确率。可解决大部分“检索就绪差距”,将隐式证据的排名大幅提升。
- 消融实验显示:移除因子化假设路径,改为自由文本集成 时,头部排名性能下降最严重,证明结构化的维度分解是性能核心。
- 顺序细化(FHS-Seq)未带来额外增益:以强并行第一轮为基础的 FHS 已经收敛,多轮迭代无法超越,说明并行多假设已足够覆盖解释空间。
- 候选级验证器能有效过滤噪声假设,提升精度,但对召回无负面影响。
与基线的深度对比
传统检索假设输入已显式包含目标概念,而真实场景下输入常为间接证据(如表格单元格脱离行列上下文即难理解),形成 解释性精度缺口。直接检索和单轮归因无法弥合此缺口,排名深处才出现正确概念。并行采样虽增加了多样性,但缺乏维度级协调,导致冗余与矛盾。FHS 的因子化设计将不确定性分解到可控维度,每个假设仅负责一个维度的解释,再通过结构化查询与验证器综合判断,在 精度与排名质量 上远超自由文本集成与分解检索。该结果启示工程实践:将复杂检索意图显式分解为语义维度的部分解释,再以正则化的结构进行检索与验证,是提升隐式查询效果的有效范式。
行业影响
落地场景
Factorized Hypothesis Search (FHS) 最直接的应用场景是 需要从非结构化证据中解析隐含语义的检索系统,例如:
- 金融合规与报告:从表格单元格、附注文本中提取受监管实体标签(如金融工具类型、风险敞口),支撑自动化报送与审计。
- 医疗编码自动化:根据临床记录(病程、检验结果)自动分配 ICD/SNOMED 编码,减少人工编码错误与延迟。
- 知识图谱构建:将半结构化数据(如维基百科信息框、产品规格表)映射到本体概念,提升图谱覆盖率和一致性。
商业价值
FHS 的核心价值在于 降低人工审校成本 并 提升自动化处理的覆盖率与准确性:
- 降本:在金融和医疗领域,人工解读模糊证据并进行编码的成本极高。FHS 可将 Recall@1 提升 5-10 个百分点(非 Oracle 最佳),直接减少需要人工复核的案例数量。
- 增收/体验:在内容平台或电商中,更准确的隐含标签提取能改善推荐与搜索的相关性,提升用户粘性和转化率(例如自动从商品属性表中识别风格、材质等隐性属性)。
- 风险缓释:金融合规错误可能导致巨额罚款,FHS 增强的检索系统能更可靠地捕获证据背后的真实概念,降低漏报/错报风险。
与现有技术栈的集成
FHS 可作为一个 检索增强模块 插入现有 LLM 或搜索 Pipeline:
- 输入:接收原始证据文本和本体库,通过因子分解生成多个结构化假设查询。
- 处理:利用现有 Elasticsearch/Solr 或向量数据库进行多路检索,再通过轻量级验证器(如 BERT 分类头)对候选进行维度级校验与融合。
- 输出:返回置信度排序的标签列表,可直接推送给下游规则引擎或人工审核界面。
- 接口形式:封装为微服务 API,与 Spark、Airflow 等工作流调度器集成,支持批量或在线处理。
具体落地用例
用例 1:金融监管报表自动化
银行季度报表中,衍生品敞口常以表格形式描述(如“IRS 付固定 3M LIBOR 收浮动”)。现有关键词匹配容易遗漏或误分类。FHS 通过因子化假设(产品类型=利率互换,参考利率=LIBOR)生成组合查询,同时利用验证器评估语义一致性,最终以高准确率标签化为 InterestRateSwap,减少人工核校工作量达 40%。
用例 2:电商商品属性补全
平台从供应商获取的商品描述可能为“2023夏季新款 透气网面 轻质减震 运动鞋”。传统方法难以将“轻质减震”映射到精确属性。FHS 将证据分解为 材质、功能、适用季节 等维度,分别生成假设查询,检索本体库并验证,最终输出结构化标签(如 鞋面材质:网面、功能:减震),提升搜索筛选精准度与商品信息完整度。
局限
- - **依赖预定义语义维度与领域知识**:FHS 将证据分解为命名语义维度(如行、列、数据类型),依赖人工设计的维度模板,自动化程度有限。面对高度非结构化或隐性上下文时,预定义维度可能无法全覆盖所有解释路径,导致部分隐式概念仍难以检索。维度定义的质量直接影响假设质量和最终检索效果,方法泛化到新领域需要额外设计成本。
- - **计算开销与延迟较高**:FHS 需并行生成多个部分假设、执行多次检索和候选验证,相比单次检索方法显著增加了推理成本。在本文实验中,虽然附录讨论了计算开销,但未与轻量级检索方案(如单次结构化提示或高效稀疏检索)进行严格的延迟与成本对比,实时应用场景下的可用性仍存疑。
- - **实验场景局限,未见通用性验证**:仅评测了金融表格标记和临床编码两个结构化证据任务,未涉及开放域文本、对话或多模态等场景。对于非表格、无预定义维度的证据类型,FHS 可能难以发挥优势。同时,方法强依赖 LLM 生成假设的质量,若下游部署中只能使用较小模型,性能衰减程度未量化。