生产环境中 AI 生成的 C++ 质量特征刻画
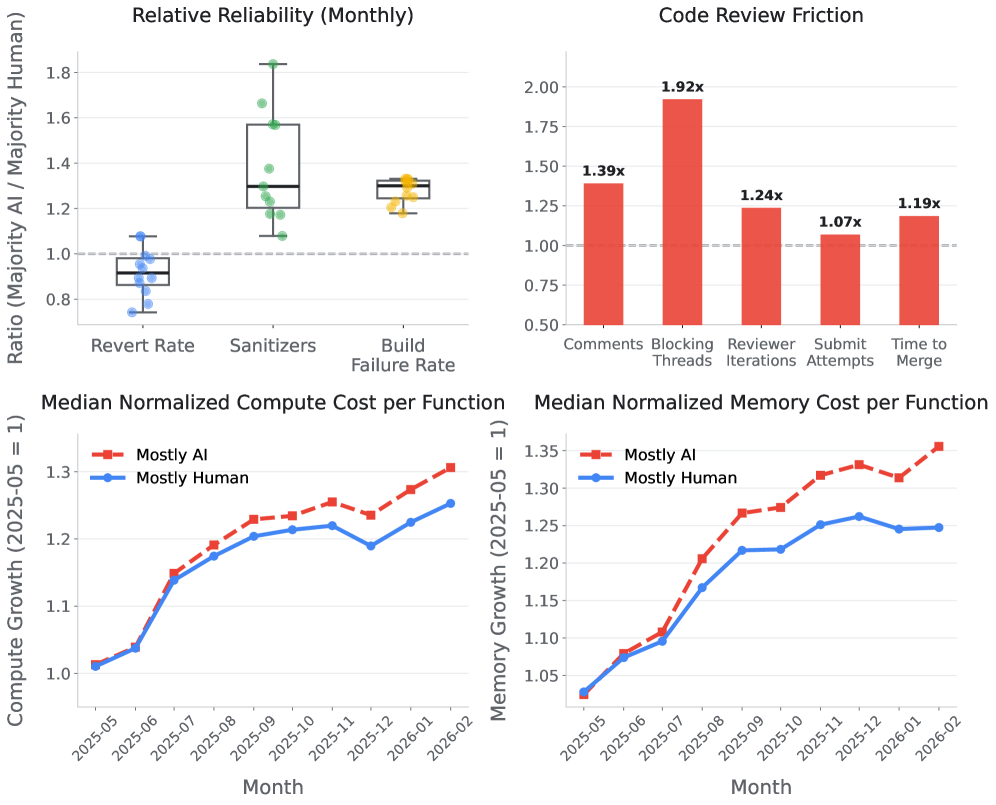
AI 编程助手广泛集成显著提升了工程速度,但近期研究揭示了其带来的代码质量与可维护性挑战。前沿 AI 实验室等行业领导者也对此表示担忧。随着大语言模型日益承担生产代码编写任务,理解其对软件质量的影响成为关键优先事项。然而,由于可观测性壁垒,在工业流程中评估这些影响仍很困难。 本研究在一家运营全球产品、服务数十亿日活用户的大型企业内部,利用对每行生产代码的完整可观测性展开分析。研究对 2025 年 4 月至 2026 年 4 月 期间的 352 万次代码变更 进行了大规模实证,对比 AI 生成与人工编写的 C++ 代码在质量、性能和维护方面的特征。 研究发现,AI 生成的 C++ 代码具有独特的质量特征: - 更高的接口与耦合负担 - 复制和分配开销 - 依赖显式循环而非优化标准 API 这些问题带来了可衡量的下游成本,包括审查工作量增加和 5-8% 的计算资源消耗上升。然而,向模型提供有针对性的分类反馈可缓解这些影响,使目标静态分析警告减少 11.1%,并提升计算效率。
论文精读
TL;DR 大规模工业实证分析表明 AI 生成的 C++ 代码存在接口耦合、拷贝分配和显式循环等问题,导致审查负担加重与计算消耗上升 5-8%,但通过分类指导反馈可减少 11.1% 警告并改善效率。
问题
问题背景
AI 编码助手(如代码补全、文本到代码生成)已广泛集成到开发流程中,显著提升开发速度。然而,生产环境下的代码质量、可维护性与资源效率正成为新的关注焦点,业界越来越担忧 AI 生成代码的长期影响。
现有方法局限
以往研究多基于受控实验或小规模开源项目,无法反映工业级棕地(brownfield)代码库的真实复杂性。关键局限包括:
- 观测性不足:缺乏对每一行生产代码的精细跟踪,难以追溯代码起源(人写 vs AI 生成)及其全生命周期指标。
- 质量定义片面:仅关注功能正确性或静态分析警告数量,忽略 接口耦合、拷贝与内存分配开销、标准库算法使用风格 等深层性能与维护属性。
- 缺乏干预研究:多数工作只描述现象,未验证通过系统性反馈改善 AI 代码质量的有效性。
为什么这个问题难且重要
- 技术挑战:在大规模(百万级提交)、多产品代码库中,构建代码谱系映射(provenance mapping)并结合多种指标(静态分析分类法、人工审查负担、计算资源消耗)进行因果推断,是极高门槛的工程难题。
- 业界关注度:当 AI 生成代码直接部署到服务于数十亿用户的系统中时,微小的性能退化或维护负担都会被放大,直接影响系统可靠性、基础设施成本与总体研发效率。前沿企业(包括头部 AI 实验室)均公开表达了对此类风险的关切。
行业类比
类似自动驾驶中的安全验证,AI 编码助手必须从“功能正确”走向“系统级质量保证”,因为生产代码的隐性质量缺陷会在规模化运维中被不断放大,最终导致巨大的计算资源浪费与维护负债。
核心洞察
- AI 生成代码在真实生产环境中呈现出独特的质量剖面,突出表现为更高的接口耦合度、不必要的拷贝与分配开销,以及过度依赖显式循环而非优化的标准库 API。与多数基于合成基准或小规模实验的同类工作不同,本研究依托一个服务数十亿用户的企业级大规模老旧代码库,并利用其完备的生产可观测性,首次将分析维度从功能正确性延伸到可维护性和运行时资源消耗,量化出 AI 代码导致 5-8% 计算资源增长的工程代价,为行业提供了切实的决策依据。
- 通过向模型输入基于缺陷分类学(taxonomy)构造的针对性反馈,研究者将目标静态分析告警降低了 11.1%,并提升了计算效率。这一干预效果的独到之处在于,它表明将结构化、领域相关的质量知识注入生成过程,比简单的提示工程或事后过滤更有效;它并非让模型记住特定模式,而是诱导出更符合生产要求的 API 使用和资源管理习惯,为“质量左移”的 AI 辅助编程提供了可落地的新范式。
方法
数据采集与溯源
研究基于一家服务数十亿用户的全球企业生产环境,覆盖 2025 年 4 月至 2026 年 4 月的全部 C++ 代码变更,共 352 万次 提交。该企业部署了全链路可观测性基础设施,每条合并到主干的代码行均携带 AI 贡献标记(通过 IDE 插件或流水线元数据),可将变更明确归因于 人类编写 或 AI 生成。数据集来自 褐地代码库(长期维护的存量系统),真实反映工业场景。
静态分析分类体系
根据前期代码审查中发现的高频 AI 缺陷模式,团队定义了分层 静态分类法,包含三个维度:
- 接口与耦合负担:新增头文件依赖、不必要的抽象层次、跨模块耦合;
- 拷贝与分配开销:冗余的对象复制、过度的堆内存分配、未利用移动语义;
- 算法风格退化:倾向显式循环而忽略 C++ 标准算法/API(如
std::copy、std::transform),导致指令流偏离优化路径。
将这套分类映射到静态分析规则,对每次提交的增量代码扫描,输出 分类警告计数 与类型分布。
度量与下游影响分析
除了静态缺陷,研究还关联了下游指标:
- 评审代价:通过 Pull Request 评论量、迭代次数衡量;
- 运行时开销:利用性能剖析与资源监控,对比 AI 与人类代码在计算资源消耗上的差异,量化出 5-8% 的 CPU/内存增长;
- 稳定性:回滚率、缺陷报告关联等。
采用配对比较与回归模型,控制作者经验、变更规模等混淆因素。
干预实验
为验证改善可行性,研究者将 分类法指导的反馈 注入模型补全流程:当 AI 建议代码触发特定静态规则时,实时或在后续微调中提供反例与纠正提示。结果显示目标警告率下降 11.1%,计算效率同步改善。
方法差异点
与过往小规模受控研究不同,该方法依托工业级全链可观测性,首次在百行级码基上完成 AI 生成代码的生产环境端到端质量画像,并将运行时资源成本纳入衡量,突破了单一静态分析的局限。
实验
实验设计
研究基于 大型企业生产环境 的 棕色代码库,覆盖 2025 年 4 月至 2026 年 4 月 间的 3.52M 次代码变更。通过 来源追踪 (provenance) 区分 AI 生成代码 与 人类手写代码,并建立 静态分析分类法 (static taxonomy) 对代码特征进行标注。主要评估维度包括:
- 上游代码属性(接口耦合、内存分配模式)
- 下游影响(审查工作量、可靠性、计算资源消耗)
干预实验为模型提供 基于分类法的针对性反馈 (taxonomy-informed feedback),以减轻质量问题。
关键发现
AI 生成的 C++ 代码呈现 独特的质量特征:
- 接口与耦合负担更高,复制和分配开销更频繁
- 风格上倾向显式循环,而非使用优化的标准 API
- 这些特征转化为 可量化的下游成本:
- 审查工作量增加
- 计算资源消耗增加 5-8%
- 通过 基于分类法的反馈干预,静态分析警告减少 11.1%,且 计算效率提升
与基线对比的深度解读
以 人类手写代码 为基线,AI 生成代码在 维护性 与 性能 均显露出系统性不足,并非简单的语法错误,而是 架构风格与资源利用模式的退化。5-8% 的计算开销在企业规模下意味着 显著的成本上升。然而,干预措施带来的 11.1% 警告削减表明:向模型注入领域专属的代码质量信号 能有效扭转劣化趋势,为 AI 辅助编码的工程化集成 提供了可操作的改进路径,即从 泛用生成 转向 质量感知的生成。
行业影响
该研究为全球大规模代码库使用 AI 辅助编程提供了关键的质量量化证据。落地场景:主要适用于对 C++ 性能与可维护性要求严苛的基础设施层产品,如数据库引擎、高频交易系统、嵌入式实时系统以及大型云计算服务。这些场景中,AI 编码助手(如 GitHub Copilot、Cursor)已逐步融入开发者工作流,但其生成的代码往往引入隐式的接口耦合、不必要的内存复制与分配,并倾向于显式循环而非标准算法,造成资源开销增加。
商业价值:研究直接量化了质量下降带来的成本——代码审核工作量增加与计算资源消耗增加 5-8%。对于云服务商或自建数据中心的企业,这意味着显著的成本上升。通过采用论文提出的基于分类法的反馈(taxonomy-informed feedback),可有效减少 11.1% 的静态分析告警,改善生成代码效率,从而降低运营成本,提升软件长期可维护性,延缓技术债务累积。
与现有工作流的接口:可将研究成果集成至 CI/CD 流程,增加针对 AI 生成代码的专项静态分析门禁,利用论文定义的缺陷分类(如接口与耦合、复制与分配开销)自动标记风险片段。同时,在 IDE 端可通过检索增强生成(RAG)向大模型注入分类知识,引导模型生成更优代码。
具体案例:
- 高频交易系统:AI 辅助生成的订单匹配引擎模块若引入额外内存分配,将导致微秒级延迟,直接影响成交滑点成本。通过集成反馈机制,系统可实时检测并提示重写为内存池友好的实现。
- 分布式存储系统:在键值存储的 Raft 共识实现中,AI 代码若产生不必要的数据拷贝,将放大网络与 CPU 开销,降低集群吞吐。静态分析门禁可拦截此类变更,保障系统效率。
局限
- 研究范围局限于单一大型企业的 C++ 生产代码库,尽管规模庞大(352 万变更),但生态、工程规范与工具链的特异性可能影响结论的外部有效性。论文在威胁有效性部分也承认了这一局限,指出不同组织、不同语言或不同 AI 助手可能呈现不同的质量特征。此外,对 AI 生成代码的识别依赖于内部元数据标注,可能存在误标或漏标,且仅覆盖明确由 AI 工具触发的更改,无法捕捉工程师接受生成代码后又手动修改的混合场景。
- 分析指标以静态分析警告、代码复杂度和有限的运行时资源消耗(CPU/内存)为主,未涉及动态行为剖面(如性能剖析、缓存局部性)、安全漏洞、逻辑缺陷等更全面的质量维度。虽然静态问题与可维护性高度相关,但无法直接推断对产品可靠性的完整影响。干预实验也仅验证了基于分类法反馈对指定警告类型的缓解效果(11.1% 下降),未系统探索提示词工程、上下文注入等更丰富的缓解策略。
- 研究未区分不同 AI 编码助手(行内补全、对话式生成、智能重构)或基础模型带来的差异,将所有 AI 生成代码视为同质整体,可能掩盖了不同交互模式或模型能力对质量影响的异质性。同时,对开发者经验水平、任务类型(新功能 vs. 修复)等混杂因素的控制有限,难以剥离 AI 工具本身与使用者技能对代码质量的交互效应。同类实证研究虽也面临相似挑战,但对比之下本文缺乏对开发者行为的细粒度建模,结论对具体工程实践的指导价值受限。