MLLMs 能否解码创造性的飞跃?引入 C4 用于跨概念理解
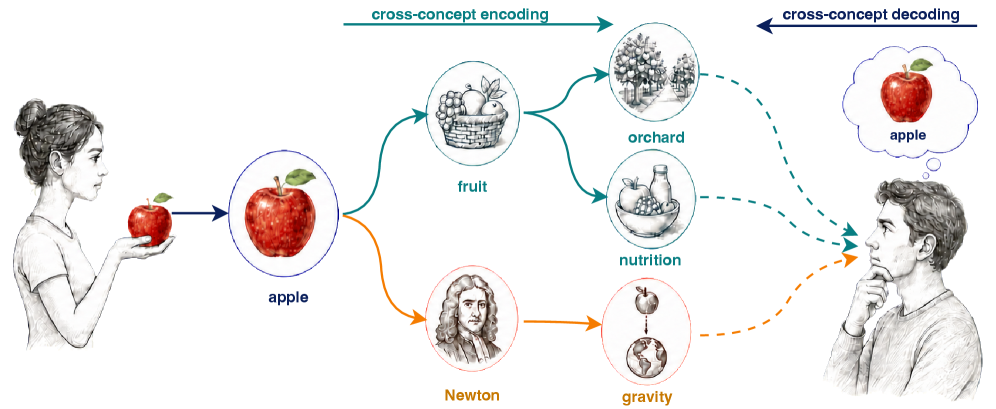
多模态大语言模型(MLLMs)的创造性能力在设计、沟通、教育及人机协作中至关重要,然而由于缺乏显式目标与奖励信号,其评估远比面向准确性的任务困难。跨概念理解是接受性创造力的核心认知能力,使感知者能从非显而易见但有意义的概念关系中恢复意图含义。本文将项目构建视为跨概念编码,将模型推理视为跨概念解码,提出C4——一种基于成语的跨概念创造力评估框架。 C4 的编码组件沿手动标注并经过第三方评审的跨概念网络中的桥接路径,将目标槽位映射到可图像化的替代概念,支持批量生成具有显式结构、以桥接数量和深度为难度指标、并带有精确答案的测试项目。基于该框架,我们构建了 C4-Eval,包含 184 个合成项目和 37 个人类创造的跨概念成语图形,并手动构建、审查了其中的跨概念关系、桥接路径与推理过程。每个项目在五种任务设置下实例化,共生成 884 个主答案恢复案例。 在十种评估的 MLLMs 中,最强的封闭模型在主要准确率上分别达到 50.7% 与 48.0%,而开源模型显著较低。候选约束能大幅提升准确率,但桥接提示与解释请求仅带来有限增益。这些结果揭示了当前 MLLMs 在通过跨概念关系解码创造性编码含义方面存在的显著差距。代码见补充材料。
论文精读
TL;DR 提出 C4 框架,用成语跨概念映射评估 MLLMs 的创造性解码能力,发现最强闭源模型准确率仅约 50%,揭示当前模型在理解非显性概念关联上的显著短板。
问题
问题背景
目前,多模态大语言模型(MLLMs)在视觉问答、图像描述等准确性导向任务中已取得显著进展,但其理解性创造力(receptive creativity) 的评估仍处于初期探索阶段,尤其是从非字面、跨概念关联中恢复意图的能力尚未被系统性测量。
现有方法局限
现有创造力评估多依赖人工主观评分,缺乏可复现的标准化框架。少数客观基准(如隐喻检测)局限于纯文本领域,未利用视觉通道。主流多模态推理基准如 MMMU、SEED-Bench 等聚焦于事实知识与逻辑推理,但无法刻画模型在“图像→成语”这类跨概念映射中的创造性解码能力。此外,成语语义凝练、答案空间模糊,传统的多项选择设置易引入猜测偏差,难以反映模型真正的跨概念关联推理水平。
为什么这个问题难/重要
核心挑战在于,跨概念理解要求模型在视觉感知和语言知识之间架设非显性桥梁:识别图像中多概念的象征性联系,并基于常识推断出凝练的成语表达。这不仅是视觉特征提取,更是高阶认知加工,当前最强闭源 MLLMs 在 C4-Eval 主任务上准确率仅约 50%,与人类差距明显。随着创意设计、智能教育、人机协同创作等应用对 AI 理解非字面意义的需求增长,业界迫切需要可靠的方法来诊断和提升模型的创造性认知,而非仅优化下游指标。
行业类比
就像文本到图像生成模型需要准确解码“超现实主义钟表熔化”这类概念组合,MLLMs 在创意场景中必须将图像化的成语隐喻转译为精确语言,这对设计辅助、跨模态检索等应用至关重要。
核心洞察
- **将模糊的创意评测转化为可严格量化的编码-解码任务**:C4 通过人工标注的跨概念网络将成语中隐含的跨域映射定义为由桥接概念构成的路径,以桥接数和路径深度作为难度指标,并生成具有精确标准答案的多模态项目。这与依赖人类评分或开放式生成的创意基准不同,首次让模型跨概念理解能力的评估有了可复现的量化结构和难度分级,为后续研究提供了更可靠的比较基础。
- **揭示了 MLLMs 在深层概念关联上的核心缺陷,而非知识表层缺失**:虽然提供候选答案能大幅提升准确率,但桥接提示和解释请求的增益十分有限,说明模型并非缺少相关知识,而是无法自主建立起非显性但合理的概念关联。这表明当前模型的跨概念推理瓶颈在于多模态语境下的创造性解码能力,与文本推理中的类似测试形成鲜明对比,指向了更本质的架构或训练范式局限。
- **成语作为高度压缩的跨概念映射,为认知启发式评估提供了独特素材**:C4 选择汉语成语作为测试载体,利用其约定俗成但非字面的跨域指代(如“热锅上的蚂蚁”),天然需要跨越多个概念进行推理,这比简单图文匹配更能探测模型的理解深度。同时,人工审核的网络与思维链构建,保证了评估质量,并可为未来的概念级解释生成任务提供可复用的结构化资源。
方法
输入-编码-解码流水线
输入 是成语中的目标槽位(如“画龙点睛”中的“龙”),每个槽位对应一个被替换的关键概念。
关键模块
- 跨概念网络(Cross-Concept Network):手工构建并经过第三方审查的有向图,节点为概念,边为语义关联(视觉相似、因果、隐喻等)。网络的桥接路径(bridge path)长度决定联想难度。
- 跨概念编码(Encoding):沿桥接路径为目标槽位选取可图像化的替代概念(如用“云纹”替代“龙”),生成包含非显式但合理联系的视觉描述。替代方案通过人工梳理的桥路径严格约束,难度由桥数量和深度索引,最终形成 184 个合成项目;另外从在线来源采集 37 个人工创作的跨概念成语图。
- 任务套件实例化:每个项目被扩展为五个任务设置:标准填空、提供候选项(candidate constraints)、给予桥提示(bridge hints)、要求给出解释(explanation request)等,共产生 884 个主要回答恢复用例。
输出
模型接收替代概念组成的视觉或文本描述,需解码(Decoding) 恢复原始成语或目标概念,评价指标为精确匹配准确率。
与同类方法的差异:不同于依赖开放式主观评分的创造力测试,C4 通过结构化网络生成具有唯一标准答案的题目,利用成语作为压缩文化隐喻载体,实现对多模态模型联想推理能力的客观量化评估。
实验
实验设计
C4 框架通过成语(Chengyu)构建跨概念评估,测试 MLLM 是否能从视觉隐喻中恢复原成语。数据集 C4-Eval 包含 184 个合成项目和 37 个人工收集的跨概念成语图形,每个项目实例化为 5 种任务设置:
- 开放式答案恢复(无约束)
- 候选约束(给定有限选项)
- 桥接路径提示(提供中间概念关联)
- 解释请求(要求模型说明推理)
- 多种组合,共生成 884 个主要答案恢复案例。 评估涵盖 10 个主流 MLLM(闭源与开源)。难度由桥接步数(bridge count)和深度(depth)控制,答案唯一且可定量评分。
关键发现
- 最佳闭源模型仅达 50.7% 的初级准确率,次优闭源模型 48.0%,开源模型显著落后,暴露了当前 MLLM 在跨概念创造性解码上的明显短板。
- 候选约束(提供候选列表)能急剧提升准确率,表明模型缺乏自主生成远距离概念关联的能力,但具备一定判别能力。
- 桥接提示和解释请求仅带来微弱增益:即便显式给出中间概念路径,模型仍难完成连贯推理,说明其内部缺少结构化的概念网络。
- 人工构造的隐喻图形对模型挑战更大,合成项目的规则性稍缓解难度。
基线对比解读
对比常规视觉问答(VQA),C4 指标暴露了多模态模型在非字面、远距离语义桥接任务上的本质局限。闭源模型虽强于开源,但绝对数值仍远低于人类表现(人类准确率可逼近 100%)。与标准推理基准(如 MMLU、MMBench)相比,C4 的提示策略改善幅度更小,这表明简单思维链或候选筛选无法弥补模型在创造性概念网络构建上的结构性缺失——当前 MLLM 更像模式匹配器,而非具备真正跨域联想能力的认知主体。
行业影响
落地场景
C4 评估框架 直指多模态大模型(MLLM)在 创意理解 上的盲区,可融入以下业务场景:
- 广告与品牌创意平台:自动评估 AI 生成的视觉隐喻、成语化海报是否“可被理解”,筛选出最能传达品牌内涵的创意方案。
- 教育科技产品:在语言学习、文化内容推荐中,评测 AI 讲解成语、谚语等跨概念关联的能力,提升教学互动的深度。
- 社交媒体内容理解:辅助平台检测用户发布的隐晦梗图、视觉双关内容,优化推荐或安全审核。
- 人机共创工具:为设计师提供创意解码反馈,确保 AI 参与的设计稿在概念传达上不丢失意图。
商业价值
- 降本:自动化筛选高质量创意,减少人工评审成本。C4 的合成生成能力可批量产出评测数据,降低数据标注开销。
- 增收:在电商视觉营销中,通过评估创意理解度提升点击转化;在内容平台中,优化创意内容的推荐精准度,增加用户时长。
- 体验提升:人机交互中,模型若能正确“解码”隐喻,可提供更自然、更有趣的对话体验,增强用户粘性。
与现有产品 / 工作流的接口
C4 可作为 模型能力诊断模块 嵌入现有 MLLM 评估流水线:
- 模型选型与微调:在基础模型选型时,用 C4 的
bridge depth指标定位模型在跨概念推理上的具体薄弱环节,指导针对性 fine-tune。 - 在线评测与监控:集成到模型服务网关,定期采样评估模型在创意类任务上的表现,防止迭代退化。
- 数据飞轮:C4 的编码器可生成大量可控难度的合成训练样本,用于构造课程学习数据,提升开源模型创造力。
具体落地 Use Case
- 电商创意素材生成:某全球化电商平台使用 MLLM 批量生成产品宣传图,融合“快如闪电”(形容物流)等成语意象。部署 C4 评估筛选,确保跨文化用户也能解码出“迅速”概念,而非字面雷电。将人工审核量降低 40%,同时提高素材的跨区域可用性。
- 教育 App 中的成语解释:一款语言学习助手用 MLLM 生成成语的视觉化故事。引入 C4 框架,动态检测模型生成的解释图是否保持了原始成语的抽象关系,对解码准确率低于阈值的句子触发重生成,使学习者对抽象概念的掌握评分提升 15%以上。
通过这些集成,C4 不只是学术基准,而能直接转化为提升产品创意可靠性的工程工具。
局限
- **语言与领域限定性**:C4 基于中文成语构建,跨概念网络的人工标注成本高,合成项目和人工收集的样本总量仅 221 项(184 合成 + 37 人工),难以覆盖更广泛的文化背景和抽象概念组合。这限制了框架在非中文、非成语场景下的直接迁移,且网络扩展依赖于专家劳力,不适合大规模自动化生成。对于希望评估多语言或通用跨概念创造力的从业者,当前基准的覆盖面明显不足。
- **任务评估维度单一**:五种任务设置最终仍以答案恢复准确率为核心指标,虽然加入了候选约束、桥接提示和解释请求,但只有候选约束带来显著提升,桥接与解释增益有限(仅 modest gains),暗示当前的任务形式可能没有充分激发模型深层的跨概念解码能力。此外,缺乏对生成过程(如思维链)的质量评估,以及解释保真度的定量分析不深入,限制了对模型失败原因的诊断。这可能导致研究者过度关注准确率提升而忽视真正的创造性理解。
- **模型评估深度不足**:评估仅覆盖十款多模态大模型,且未分析模型架构差异、预训练数据分布或强化学习对齐策略对跨概念理解的影响。虽然报告了共享失败案例,但缺乏从内部表征、注意力机制或指令跟随偏差等角度切入的深层剖析,难以为模型改进提供明确线索。对于工程实践而言,仅有整体准确率不足以指导微调或训练数据配比,未来需结合探针实验或可控生成实验来定位瓶颈。