Capek 0.5: 一种以执行为中心的具身智能视觉语言模型
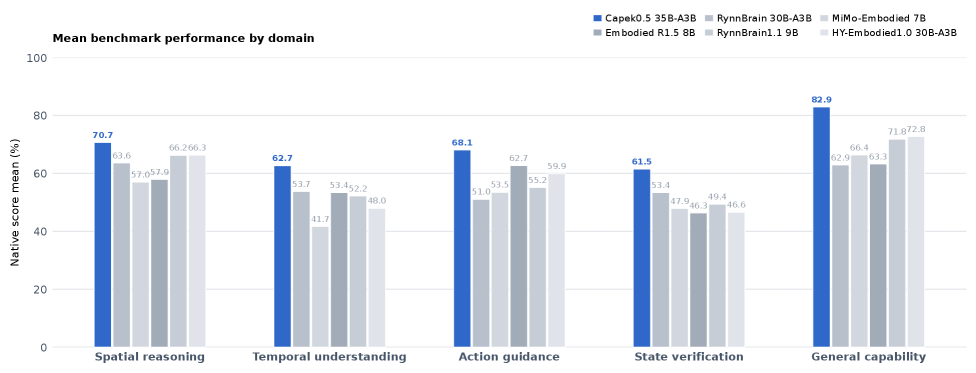
视觉语言模型正日益成为具身智能体的推理核心。机器人执行本质上是迭代的:每个动作都会改变场景和物理状态,不断更新需要感知、推理和验证的内容。满足这些需求需要互补的能力,这些能力在监督信号、预测格式和验证标准上各有不同。现有方法通常针对孤立的、特定任务的目标来发展这些能力,而未解决如何围绕执行整体来组织和整合它们。 我们提出 Capek 0.5,这是一个围绕以执行为中心的能力分类法构建的具身视觉语言模型。该分类法并非按数据集或任务来组织训练,而是根据具身能力在执行过程中的功能角色进行分组,包含四个能力家族:空间推理、时间理解、动作引导和状态验证。每种能力首先由专门模型通过带有可验证奖励的强化学习从共享骨干中习得,然后通过权重空间合并及路由策略空间蒸馏将各专门模型整合为单一的推理时模型。 我们在 2B 和 35B-A3B 规模上实例化了 Capek 0.5,并从三个互补角度进行评估:包括 Capek-StateBench(一个用于状态验证的新基准)在内的综合基准套件;从专门模型到统一模型的能力保持对照研究;以及在模拟具身环境中的闭环评估。Capek 0.5 在大多数匹配基准行上优于其初始化版本,以量化损失在单个检查点中保留了全部四种专门能力,并能迁移到闭环具身任务执行中。
论文精读
TL;DR Capek 0.5 提出以执行为中心的能力分类法,通过 RL 训练专家再合并为统一 VLM,高效融合空间推理、时间理解、动作指导和状态验证,驱动具身智能。
问题
问题背景
具身智能正转向以视觉-语言模型 (VLM) 为推理核心,但机器人执行需要多维能力协同,而非单点任务优化。
现有方法局限
多数工作按孤立数据集或任务分别训练 空间推理、动作生成 等能力,每条研究线追求各自指标最优,忽略执行中能力间的动态反馈:
- 监督信号、预测格式、验证标准不统一,难以形成连贯的感知-规划-验证闭环。
- 模型在推理时被迫串行调用多个专用模块,实时性差,且缺乏统一的状态验证机制来检测动作是否达成预期效果,导致开环成功率虚高而闭环部署失败频发。
为什么这个问题难/重要
机器人执行本质是迭代的:每个动作都会改变场景和物理状态,要求模型持续更新对环境的理解并自主判断任务是否完成。这带来三个技术挑战:
- 能力异构性:空间理解依赖 3D 几何先验,时序建模需处理跨步骤依赖,动作则需物理可行性约束,单一训练目标无法覆盖。
- 信号对齐:不同能力的奖励函数、数据标注粒度差异极大,联合训练易陷入冲突。
- 推理效率:具身任务要求低延迟,模型必须在单一推理通路中同时输出结构化动作与自然语言验证。 业界关注统一执行中枢,以降低工程整合成本并提升长程任务可靠性。
行业类比
类似自动驾驶中感知、预测、规划与控制需在统一流水线中协同并实时验证,具身模型也需将多元能力像微服务一样有机编排,而非简单串联。
核心洞察
- 执行中心的能力分解:Capek 0.5 将具身智能所需能力按执行循环功能阶段划分为空间推理、时间理解、动作引导和状态验证四类,而非沿用按任务或数据集划分的常规方式。这种分类直接对齐机器人迭代执行中感知→推理→动作→验证的闭环,使得强化学习的奖励设计更自然,每个能力可独立获取可验证的监督信号,避免多目标混合训练中的冲突与次优收敛。
- 分阶段合并策略:先通过权重空间合并将各能力 specialist 参数融合作为初始化,再引入带路由的策略空间蒸馏,在不同输入下动态聚合专家输出分布,有效解决了从多专家到统一模型过程中的灾难性遗忘和能力干扰。相比简单的多任务联合微调或渐进式训练,这一策略在保持单个 benchmark 行改善率的同时,将四类能力无损集成到单一推理模型,为多技能具身大模型的后训练提供了高效的合并范式。
方法
核心思路:从专家到统一的执行中心范式
Capek 0.5 将具身 VLM 的后训练围绕“执行过程”重新组织,而非按数据集或任务类别划分。其方法流程遵循 输入 → 能力专家训练 → 模型合并与蒸馏 → 统一输出 的线索。
输入与接口标准化
模型以 视觉观测 + 自然语言指令 作为输入,通过共享的视觉-语言骨干(2B/35B-A3B)进行统一编码。为兼容四类能力的不同输出格式(如空间坐标、时序描述、动作标记、布尔验证),数据构建阶段进行了 输出格式标准化,将所有预测目标映射到统一的文本 token 序列,使单一模型可产生异构输出。
关键模块 1:能力专家训练 (Capability Specialist Training)
以共享骨干为起点,针对 空间推理、时间理解、动作引导、状态验证 四个能力族,分别训练专家模型。训练使用 Token-Level GRPO(Group Relative Policy Optimization),这是一种无须显式价值模型的强化学习方法,直接对 token 序列级奖励进行优化。每个专家有 能力特定的可验证奖励设计:例如空间推理使用 IoU 或坐标误差,动作引导使用任务完成信号,状态验证使用布尔匹配等。这保证每个专家在专属领域获得精准的监督信号。
关键模块 2:能力整合 (Capability Consolidation)
- 权重空间初始化:将多个专家的权重通过 模型合并(weight-space merging) 融合为单一初始模型,保留部分参数共性。
- 路由策略空间蒸馏 (Routed MOPD):在合并模型的基础上,使用策略蒸馏进一步对齐输出分布。路由机制根据输入动态激活不同能力分支,避免能力干扰。最终得到一个统一推理模型,无需在运行时切换专家。
输出
模型在推理时输出与任务对应的内容:可能是物体空间坐标、动作序列、时间关系描述或状态正确性判断。在 Capek-StateBench 等基准上评估能力保留,并在闭环仿真环境中验证任务执行。
与同类工作的差异:传统端到端具身 VLM 通常按任务混合数据训练,各能力相互耦合且奖励信号混杂。Capek 0.5 通过分能力专家训练 + 可验证奖励塑造 + 权重合并与蒸馏,既保证各能力的专项精度,又实现单一模型的执行期整合,避免了多模型切换的开销与不一致性。
实验
实验设计
Capek 0.5 从三个互补视角进行评估:
- 综合基准测试:覆盖 Spatial Reasoning、Temporal Understanding、Action Guidance、State Verification 四大能力族,并引入自建基准 Capek-StateBench 专门衡量状态验证。
- 能力保留可控研究:对比各能力专家模型与合并后的统一模型,量化从专家到单一推理模型的能力损失。
- 具身闭环模拟评估:在模拟具身环境(如 EmbodiedBench、VIGIL)中测试端到端任务执行。
模型包含 2B 和 35B-A3B 两种尺度,统一使用 GRPO 强化学习与可验证奖励,并通过权重空间合并及路由式多目标策略蒸馏(routed MOPD) 将专家能力融入单一推理模型。
关键发现
- Capek 0.5 在绝大多数匹配基准测试行上相比初始化模型均有提升,表明以执行过程为框架组织能力训练有效。
- 统一模型能在一个检查点中保留全部四种专业能力,且损失可量化,证明路由蒸馏能缓解多能力冲突。
- 闭环任务执行成功迁移至模拟具身环境,验证了模型从静态 QA 到动态执行的可迁移性。
与基线对比的深度解读
传统方法通常为每个技能独立优化、使用互不相干的训练目标,导致模型整合时能力漂移或遗忘。Capek 0.5 的“专家—统一”训练框架与之形成鲜明对比:
- 以功能角色而非数据集划分能力,使各专家专注于执行流程中的特定环节,避免数据域的孤立优化。
- 通过权重合并与策略蒸馏而非简单的多任务微调,减少了不同奖励信号之间的干扰,保留专家性能的同时实现统一推理。
- 从静态基准到闭环模拟的评估链路表明,该集成策略产生的模型不仅基准分数提升,更能在物理交互的迭代过程中维持一致的推断与验证行为。
行业影响
落地场景
Capek 0.5 将具身智能的感知-推理-验证闭环压缩为单一 VLM,直接面向需要空间推理、时序理解、动作生成与状态校验的物理交互场景。仓储物流机器人可在动态货架间实时重规划抓取路径;家庭服务机器人能理解“把桌上的马克杯拿到洗碗机”这种多步指令并验证每步完成状态;自动驾驶系统则利用其统一输出接口进行占用预测、目标检测与运动规划,减少多模型拼接的延迟。
商业价值
该模型通过专家权重合并 + 路由策略蒸馏将四种专项能力整合进一个推理时 checkpoint,显著降低多模型部署的硬件成本与工程复杂度(如一板多用的 35B-A3B MoE 架构)。在机器人运维中,统一的 VLM 可避免多模型切换导致的故障点,提高任务成功率和执行效率,直接转化为硬件成本节省与服务可用性提升。验证能力可减少人工复检,适合规模化无人场景。
与现有产品/工作流的接口
模型输出接口标准化为三类 token:坐标(边界框、关键点)、ROS 动作(6-DoF 轨迹)和自然语言验证结果,可直接对接主流机器人中间件与感知栈。例如,在企业智能仓储平台中,可替换原有的专用检测器、策略网络和验证模块,通过单一 gRPC 服务注入 VLM 推理,上下游系统无需修改消息格式。在自动驾驶仿真闭环中,其生成的端到端规划轨迹可直接输入 CARLA 等模拟器进行闭环评估,加速从离线基准到实车部署的迁移。
局限
- - **能力合并中的信息损失**:论文采用先独立训练专家、再通过权重合并及策略蒸馏进行统一,但合并过程可能牺牲某些能力的峰值性能。尽管声称量化了损失,但并未提供每个能力从专家到统一模型的具体下降幅度,也未深入探讨如何最小化这种损失。在实际部署中,单一模型在特定能力上的退化可能成为任务失败的瓶颈,而重新训练专家又需高昂成本。此外,蒸馏过程可能偏好高频动作或常见场景,导致长尾状态下的能力弱化。
- - **从仿真到真实环境的迁移鸿沟**:Capek 0.5 的闭环评估仅在仿真环境中进行,虽然提供了有希望的指标,但未展示在真实机械臂或移动机器人上的表现。具身智能中常见的感知噪声、动力学不确定性、实时性约束等挑战,在仿真中难以完全复现。此外,依赖可验证奖励的训练范式要求环境提供自动化奖励信号,这在真实世界中构建往往困难或昂贵,限制了方法的可扩展性。