优化器即智能体:跨提示、程序和机器学习工作流的推理驱动搜索
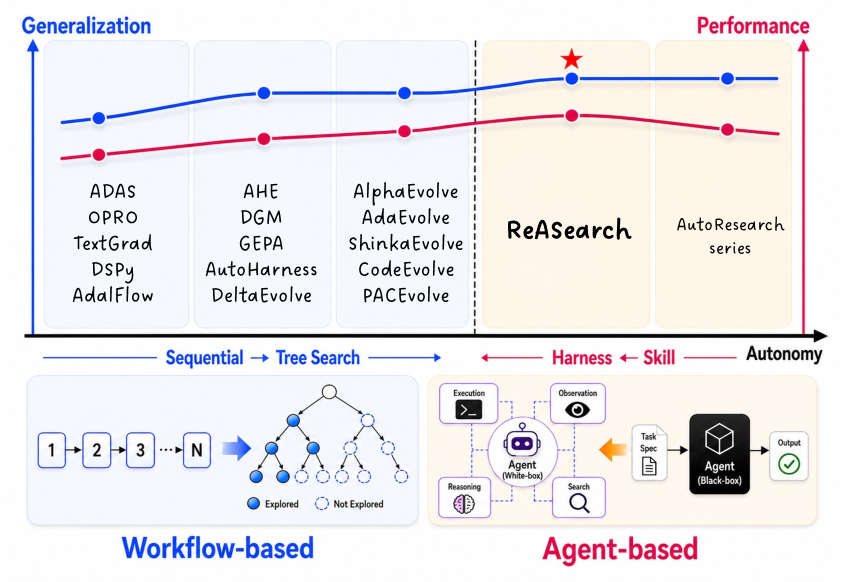
最近面向提示、程序和机器学习工作流的优化系统,通常依赖外部循环控制器,如进化搜索、bandits或文本梯度方法。我们提出一个根本不同的问题:这种搜索策略能在多大程度上被单一的工具使用智能体所内化? 为此我们提出 ReASearch,一个统一的推理驱动优化框架。智能体自主决定评估什么、如何诊断失败、进行哪些编辑,以及何时验证或重启。它不仅是受手工启发式引导的提议生成器,更会主动分析结果、分配预算,并通过持久记忆在长时程范围内持续优化策略。借助共享的智能体循环和领域特定工具,ReASearch 用相同的脚手架优化提示、程序和 ML 工作流。 在14个多样化任务上,该框架与专用优化系统相比具有竞争力,且多数情况下更优,相对强领域特定基线提升了 2% 到 40%;在某些任务中,它还发现了超越人类已知最佳结果的解。关键的观察是:复杂搜索行为(通常由显式控制器实现)会从智能体的推理过程中自然涌现。
论文精读
TL;DR ReASearch 将优化器本身建模为推理型 agent,让 LLM 自主探索、诊断与修正,在 prompt、程序、ML 工作流优化上普遍超越专用基线,甚至发现优于人类最佳记录的解。
问题
问题背景
现代 AI 工程中,提示工程、程序合成与机器学习工作流优化 高度依赖反复试验的外部搜索循环,以自动发现更优的设计或超参组合。
现有方法局限
主流方案采用显式外环控制器(如进化搜索、Bandit 算法、文本梯度方法)来迭代生成候选、评分并选择。这些控制器通常基于手工设计的启发式规则,存在三个关键局限:
- 缺乏诊断能力:它们无法分析失败案例的根本原因,只能盲目推进变异或重试。
- 预算分配僵化:无法根据当前进展动态调整评估预算,导致计算浪费或探索不足。
- 跨域泛化弱:每种优化器针对特定问题域定制(如提示优化用文本梯度,程序进化用遗传算子),无法轻易迁移至新任务。
这使得自动化系统难以达到人类专家的优化深度——后者会从结果中学习、猜测因果、主动回溯并积累领域知识。
为什么这个问题难且重要
让单一 LLM agent 内部化整个搜索策略,面临长上下文规划、探索-利用权衡、跨域工具使用与方差鲁棒性等挑战。若成功,agent 可自主决定何时评估、如何诊断、何时重启,并利用持久记忆长期积累知识,有望统一 prompt、程序、ML 工作流的优化范式,大幅减少人工干预,甚至发现优于人类设计的解决方案。业界对自动化 AutoML、提示优化 及代码智能体的关注度持续升温,该问题正成为 AI 工程化的核心瓶颈。
行业类比
如同 AutoML 将模型选择与超参优化从专家驱动转向数据驱动,ReASearch 试图将优化策略本身从手工设计转向推理驱动,使 agent 成为自己的优化器。
核心洞察
- **优化器即智能体 (The Optimizer Is the Agent)**:ReASearch 让单个工具使用 agent 通过推理自主完成搜索决策,而非依赖进化搜索、bandits 等显式外循环控制器。这意味着优化策略不再是手工设计的启发式规则,而是 agent 基于任务理解、失败诊断和记忆积累动态生成的推理过程,这从根本上改变了自动化优化的设计范式,使系统具备更强的自适应性和长程规划能力。
- **复杂搜索行为从推理中自然涌现**:传统方法需显式实现回溯、多分支探索、预算分配等机制,而 ReASearch 实验表明,agent 在分析结果、验证改进和反思失败时,会自发地产生这些高级搜索策略,无需预设规则。这种**涌现行为** (emergent behavior) 不仅降低了系统设计复杂度,还经常发现超越人类已知最优解的新方案,揭示了 LLM 推理能力在搜索空间探索上的巨大潜力。
方法
输入与问题形式化
给定一个优化目标(例如提示词、程序代码、ML 工作流配置)以及对应的评估函数与任务预算,ReASearch 将其形式化为一个序列决策问题:代理在每一步选择动作(编辑、评估、回退、重启)以最大化最终性能。
核心模块:推理驱动的代理循环
- 通用代理架构:采用统一的 tool-using agent 循环,代理接收观测(评估结果、错误信息),通过内部推理与记忆自主决策下一步动作,而非依赖手工设计的外部控制器。
- 上下文管理与持久记忆:代理维护结构化上下文窗口与长期记忆,记录历史尝试、诊断结论与教训。这种机制支持跨试验的知识积累与策略调整,例如在程序优化中通过“教训积累”(lesson accumulation)避免重复错误。
- 领域专用工具:针对不同优化域提供标准化接口:
- 提示优化工具:支持提示词变异、批量评估与方差稳健的有效验证(variance-robust effective verification),并基于完整优化历史选择最终提示,而非仅依赖单次最高分。
- 程序进化工具:提供代码执行、子程序分析、因果诊断与数学抽象能力。代理遵循“先分析,后编码”模式,通过因果诊断驱动精准修复(causal diagnosis drives surgical fixes)和数学抽象压缩搜索空间,从迭代发现中涌现组合算法。
- ML 工作流优化工具:支持高效探索,包括分阶段搜索(phased search)、约束感知推理(constraint-aware reasoning)与基于失败的诊断学习(diagnostic learning from failure),能够发现协同提升的改进点。
输出
经过自主预算分配与多轮推理,代理输出优化后的实体(提示词、程序或工作流),并在多数任务上超过专用优化系统基线。
与同类方法的差异
ReASearch 将搜索策略完全内化于代理的推理过程,而非依赖外部循环控制器(如进化搜索、bandits 或文本梯度),使复杂的搜索行为(如自主回退、预算分配、过拟合检测)从代理的思考中自然涌现,无需手动设计启发式规则。
实验
实验设计
ReASearch 在 提示优化、程序演化 和 ML 工作流优化 三个场景下评估,覆盖 14 个任务。提示优化使用 AIME、HotpotQA、GSM8K、Terminal‑Bench,程序演化包括 Circle packing、Heilbronn triangle、EPLB、Transaction scheduling 和 ARC‑AGI‑2,ML 工作流优化涉及 NanoGPT、IMG‑100、Atari、MuJoCo 和 DRW 加密货币预测。
- 基线:提示优化与 GEPA 比较;程序演化和工作流优化则对比该领域专门的进化搜索、bandit 或文本梯度系统。
- Agent 使用统一框架,仅更换领域特定工具(如代码执行器、验证器),依赖持久记忆进行多步推理搜索。所有实验基于相同 LLM 骨干(如 GPT‑4),不涉及额外训练。
关键发现
- 自主搜索行为的涌现:Agent 能诊断失败、主动回溯、重新分配预算,这些原本由显式控制器(如进化算法、策略梯度)实现的策略,全部从推理中自然产生。
- 性能突破:在多数任务上超越专门优化系统,提升幅度达 2% 至 40%;在 Heilbronn 三角形、圆包装等任务上甚至发现优于已知人工设计的解。
- 统一性的优势:相同框架跨三个截然不同的领域均有效,证明通用 Agent 的推理能力可替代大量人工编码的搜索策略。
与基线的深度对比
- 范式转变:传统方法将“如何搜索”作为外部控制器手工设计,而 ReASearch 将优化策略内化为 Agent 的认知过程,使探索更灵活,尤其在解空间不规则时优势明显。
- 成本与可靠性:这种灵活性以更高的 token 消耗为代价,且推理的不可控性可能影响复现性。低预算或对稳定性要求极高的场景,专用优化器仍具优势。
- 工程启示:对于需要复杂诊断与长程规划的优化任务(如自动化 ML 实验、代码级调优),部署一个具备工具调用能力的 Agent 可能比维护定制搜索框架更高效,但需设计完善的记忆管理、验证机制和人机交互界面以控制风险。
行业影响
落地场景
ReASearch 可直接嵌入需要频繁实验和迭代的 AI 产品研发管线:
- LLMOps / Prompt 工程平台: 替代人工反复试写 prompt,自动在多个候选间搜索、诊断、校准,输出稳定最优指令。
- ML 流水线自动调优: 覆盖从数据预处理、特征工程到模型选择、超参搜索的全流程,尤其适用于 AutoML 服务和 MLOps 平台。
- 代码与算法迭代: 自动演化程序(如调度算法、数学优化函数),在物流、交易策略等场景中直接发现超出人工设计的实现。
商业价值
- 降本: 大幅减少资深算法工程师在 prompt 调试和流水线调参上的时间投入,预计可将实验周期缩短 50% 以上; 自动化的诊断与验证步骤避免无效尝试,节省计算资源。
- 增收: 通过持续自主优化,模型/系统性能可突破人工经验天花板(论文中部分任务提升 2%–40%),直接转化为推荐点击率、交易收益率等业务指标的增益。
- 体验提升: 稳定的优化过程降低线上“调崩”风险,确保服务一致性; 同时使中小团队也能获得接近大厂的优化能力,加速产品迭代。
与现有产品/工作流的集成
ReASearch 以 agent + 工具 的架构设计,天生适合作为插件嵌入现有 MLOps 栈:
- 通过定义领域专用工具(如代码执行器、评估器、记忆模块),可对接 Weights & Biases, MLflow, Kubeflow 的实验追踪与作业编排。
- 对外提供标准化 API,用户只需指定搜索空间和评估管道,agent 即可异步执行多轮优化并回报结果。
- 与现有 CI/CD 流程结合,在每次模型/系统部署前自动运行优化检查点,实现持续的自动改进。
具体落地 Use Case
- 跨境电商搜索推荐系统: 搜索排序模型的 prompt 和特征工程步骤会因季节、品类、市场而异。使用 ReASearch,运维团队可定义评估指标(如转化率、NDCG),由 agent 自动探索新的 prompt 组合、规则调整甚至底层程序优化,将原本数周的迭代压缩到数小时,并持续适应变化。
- 自动驾驶感知算法迭代: 在 3D 检测或轨迹预测任务中,算法工程师常需手工调整后处理参数、损失函数组合等。通过 ReASearch,只需提供评估基准和搜索空间模板,agent 能自动诊断失败案例,进化出更优的算法配置,甚至提出全新的复合方案,提升 mAP / minADE 等关键指标,缩短从研究到上车的时间。
局限
- 代理的优化能力高度依赖底层大模型(LLM)的推理和工具使用质量,当任务需要严格形式化验证或数学保证时,模型幻觉和推理误差可能导致次优或错误方向,且长上下文交互易发生错误累积,缺乏保证收敛的理论支撑。
- ReASearch 的计算开销显著高于传统外循环优化器。代理每步都需生成大量思考文本和工具调用,产生高额 token 消耗和延迟,在成本敏感或实时场景(如在线超参调优)中难以部署,且资源利用效率远低于专用搜索算法。
- 虽然框架统一,但在极端领域特异性任务上可能不如精心设计的专用优化器精细,代理的自主性和非确定性行为也增加了调试和复现难度,长期记忆和策略演化的不可解释性可能阻碍生产级信任建立。