能量引导的流匹配 (Energy-Guided Flow Matching)
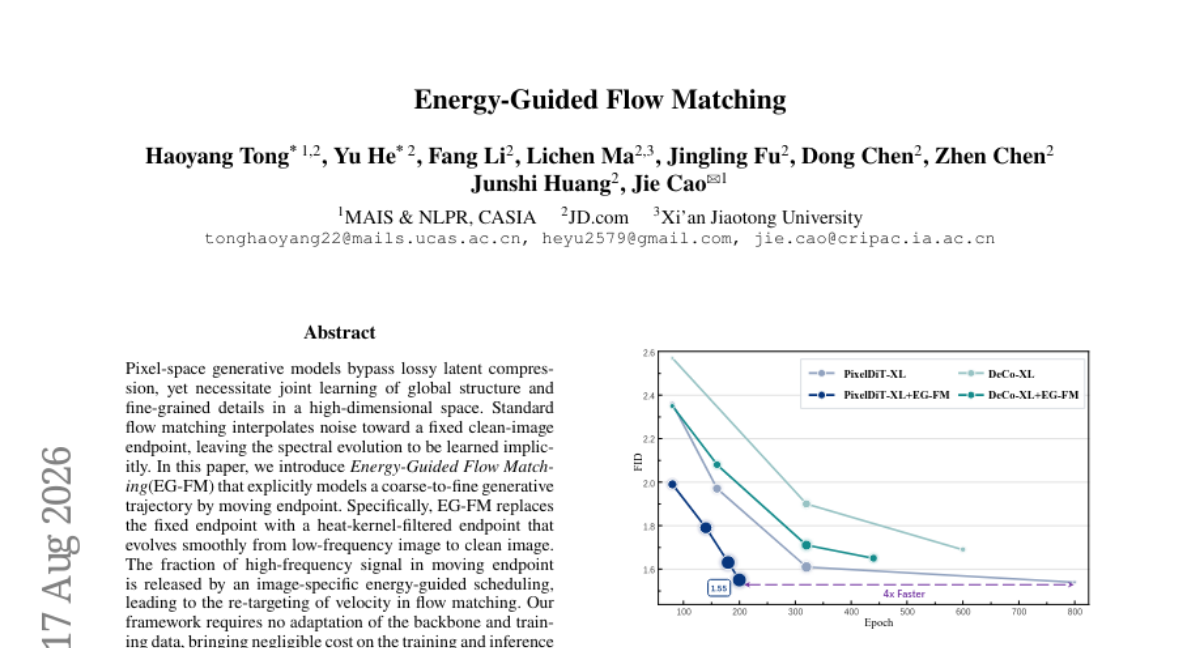
像素空间生成模型虽绕过了有损潜在压缩,却必须在高维空间中联合学习全局结构与细粒度细节。标准流匹配将噪声向固定干净图像端点插值,迫使频谱演化隐式学习,效率受限。为此,我们提出 Energy-Guided Flow Matching (EG-FM),显式建模由粗到细的生成轨迹。 EG-FM 用 热核滤波端点 替代固定端点,使端点从低频图像平滑演化至干净图像;同时通过 图像特定能量引导调度 逐步释放高频信号,实现流匹配中速度场的重定向。该方法无需调整主干网络与训练数据,训练和推理阶段额外成本可忽略。 在 ImageNet 256×256 类条件生成任务上,EG-FM 以更少轮数稳定取得更低 FID:200 轮达到 1.55,600 轮降至 1.45;在 512×512 分辨率下仅用 40 轮高分辨率适应即获得 1.58。迁移至文生图后,GenEval 得分 0.85,DPG-Bench 得分 83.9。代码已开源:https://github.com/ysng123/EG-FM。
论文精读
TL;DR EG-FM 将流匹配的固定干净图像端点替换为热核滤波的移动端点,并用能量引导调度逐步释放高频细节,在 ImageNet 256 上 FID 降至 1.45,且训练/推理开销可忽略。
问题
像素空间生成模型避免潜在空间压缩的信息损失,但必须在高维像素空间中联合学习全局结构和细粒度细节。
标准 Flow Matching 将噪声插值到固定干净图像端点,模型需隐式学习所有频率的演化路径,导致:
- 高频细节的生成时序不可控,缺少显式的 coarse-to-fine 引导,训练收敛慢,需要更多 epoch;
- 固定端点使速度场在所有时间步混合不同频率信息,中间表示可能次优,造成模糊或伪影;
- 已有的分层或残差方法(如 cascaded diffusion)需要修改网络结构或数据管道,增加工程复杂度。
高维像素空间中低频全局结构和高频纹理的联合建模是核心挑战:高频信号对噪声敏感,过早引入会干扰结构学习,过晚引入则细节缺失。业界在追求低 FID 的同时高度关注训练开销和推理成本,因此若能在 Flow Matching 框架内仅通过修改训练目标实现显式 coarse-to-fine 轨迹,将对大规模图像生成(如 ImageNet 类别条件和文本到图像)具有实用价值。
类比 Progressive Growing 在 GAN 中从低分辨率逐步增加高分辨率,但 EG-FM 通过 moving endpoint 在固定分辨率下直接操控频率释放,无需多阶段训练。
核心洞察
- Energy-Guided Flow Matching 的核心是将 flow matching 中固定的干净图像端点替换为热核滤波定义的移动端点,显式地把生成过程建模为从低频到高频的粗到细轨迹。标准 flow matching 要求单一网络在同一时刻学习全局结构和细节,频谱演化完全依靠隐式推断,训练难度大且容易在高维空间产生伪影。EG-FM 通过移动端点逐步释放高频分量,将频谱学习从隐式变为显式,模型只需学习当前尺度对应的速度场变化,降低了高维空间的联合建模难度。这一思路与级联生成或多阶段 coarse-to-fine 方法不同,它不改变网络结构或训练数据,却能直接提升单阶段生成质量。
- 另一个关键设计是图像特定的能量指导调度(energy-guided heat-time scheduling),它为每张训练图像计算一个能量匹配的热时间,从而控制移动端点在何时释放多少高频信号,并对 flow matching 的速度场进行重定向。这解决了固定调度导致的不同图像频谱复杂度差异被忽略的问题:简单图像可能过早进入高频细节,复杂图像则过晚。该调度只需在端点构造时计算一次,训练和推理阶段的开销几乎可忽略,却带来 ImageNet 256 上 200 epoch FID 1.55、512 分辨率 40 epoch FID 1.58 的显著提升。与需要多阶段蒸馏或级联网络的 coarse-to-fine 工作相比,EG-FM 的即插即用属性使其更容易迁移到现有大规模扩散模型或 flow 模型。
方法
EG-FM 在标准 flow matching 框架上引入移动频谱端点和能量引导调度,显式建模从粗到细的生成过程。
输入:随机噪声与条件(类别标签或文本),训练时还需要干净图像样本。
关键模块:
- 热核滤波端点:对每个干净图像 $x_1$ 应用热核(heat kernel)滤波,得到随时间 $\tau$ 演化的模糊版本。$\tau$ 从较小值增至较大值时,滤波强度增大,端点从接近原始图像逐渐退化为仅含低频信息的平滑图像。训练时将此滤波端点作为 flow matching 的终点,使得生成轨迹沿频谱逐步细化。
- 能量引导 heat-time 调度:为每个图像计算高频能量占比,据此确定释放高频信号的时序。具体地,高频能量越高的图像,其高频细节在轨迹中越晚释放,形成图像特定的调度曲线。调度函数引入一个可学习的曲率参数,控制释放时钟的加速或减速。
- 速度重定向:基于移动端点重新计算 flow matching 中的速度场目标。标准 flow matching 的速度指向固定干净图像,而 EG-FM 的速度指向当前 heat-time 下的滤波端点,从而引导模型学习与端点移动一致的速度场。
输出:最终生成的图像。训练和推理中,仅需替换端点构造与速度计算逻辑,无需修改 backbone 架构或数据 pipeline,额外计算开销可忽略。
与同类方法的差异点:相比标准 flow matching 将端点固定为干净图像、让网络隐式学习频谱演化,EG-FM 通过移动端点和能量引导调度显式建模 coarse-to-fine 轨迹,显著提升生成质量并加速收敛。
实验
实验设计
EG-FM 在 ImageNet 256×256 类别条件生成上训练 200 和 600 epochs,评估 FID;然后在 ImageNet 512×512 上进行仅 40 个高分辨率适应 epochs;最后迁移到文本到图像生成,用 GenEval 和 DPG-Bench 评测。EG-FM 无需修改 backbone 和训练数据,训练与推理开销可忽略。
关键发现
- 在 ImageNet 256×256 上,EG-FM 仅用 200 epochs 达到 FID 1.55,600 epochs 降至 1.45。
- ImageNet 512×512 仅 40 适应 epochs 获得 FID 1.58,展示高效分辨率扩展。
- 文本到图像生成迁移后,GenEval 得分 0.85,DPG-Bench 83.9,验证方法通用性。
与基线对比解读
摘要指出 EG-FM “consistently achieves lower FID with fewer epochs”,表明其通过显式 coarse-to-fine 学习路径降低了高维像素空间联合建模的难度。与标准 flow matching 相比,EG-FM 用移动端点和能量引导调度逐步释放高频细节,而非让网络在噪声到干净图像的单一插值中隐式学习频谱演化。这种设计不仅加速收敛,还避免了 latent 压缩的信息损失,为像素级生成提供了一条轻量、可迁移的改进路线,且改动成本极低(无 backbone 改动)使其易于部署。
行业影响
落地场景
EG-FM 适用于 pixel-space 生成模型,尤其在高分辨率图像合成任务中具有直接落地价值。典型场景包括:
- 电商商品图生成:商家提供基础商品照片,模型可生成多角度、多背景的高清图,用于详情页和广告素材。
- 内容平台头图 / 插图生成:根据文章标题或摘要,生成符合品牌调性的定制图片。
- 合成数据增强:在自动驾驶、工业质检等领域,生成稀有场景的训练数据。
商业价值
EG-FM 通过改进 flow matching 训练轨迹,在 ImageNet 类条件生成上以更少 epochs 达到更低 FID(200 epochs 即 1.55),显著降低 GPU 训练成本;同时在 text-to-image 任务上提升 GenEval 至 0.85、DPG-Bench 至 83.9。这意味着企业可以用更少的算力预算训练出高质量的图像生成模型,缩短产品迭代周期。
与现有工作流的接口
EG-FM 是一种轻量级插件,不改变模型 backbone 和训练数据。集成时只需:
- 替换 flow matching 的固定 clean-image endpoint 为 heat-kernel filtered moving endpoint。
- 引入 image-specific energy-guided heat-time scheduling 来控制高频信号释放速度。
- 在现有训练 / 推理代码中增加少量计算,几乎无额外开销。
因此,对于已经使用 Diffusion / Flow Matching 框架的团队,可以快速集成到现有 pipeline,无需重新设计模型或数据加载。
局限
- 论文主要在 ImageNet 类条件生成和文本到图像生成上验证了 EG-FM,但在无条件生成、超分辨率、图像编辑、视频生成等其他生成任务上的表现尚未评估。方法依赖能量引导,而能量函数的定义与任务密切相关,迁移到新任务时需要重新设计能量计算方式,可能引入额外工程成本。此外,论文实验均使用 Pixel-space 模型(如 DiT 系列),对于基于 Latent 空间的 flow matching 模型(如 Stable Diffusion 3 的 rectified flow)是否同样有效,尚缺乏直接证据。
- 虽然论文声称训练和推理阶段开销可忽略,但能量引导需要计算图像的能量(例如采用预训练感知特征或分类器),这本身需要额外的前向传播,并且在训练中需要对每个样本计算能量以确定 heat-time scheduling。在 batch size 较大或能量网络较复杂时,这部分开销可能不可忽略,论文中未给出详细的计算量对比。另外,能量引导的超参数(如 release-clock curvature)需要调节,不同数据集可能需要不同设置,增加了调参负担。
- 论文使用 heat-kernel-filtered 移动端点实现 coarse-to-fine 生成,该设计隐含假设图像的高频细节是在生成后期才逐渐出现,这种假设对于自然图像可能成立,但对于纹理丰富或高频特征占主导的数据(如医学影像、卫星图像、某些工业检测图),强制低频先验可能反而阻碍细节生成。论文未在自然图像之外的领域进行测试,方法的适用范围存在不确定性。