AtlasVLA: 面向视觉-语言-动作模型的持久世界-自我状态建模
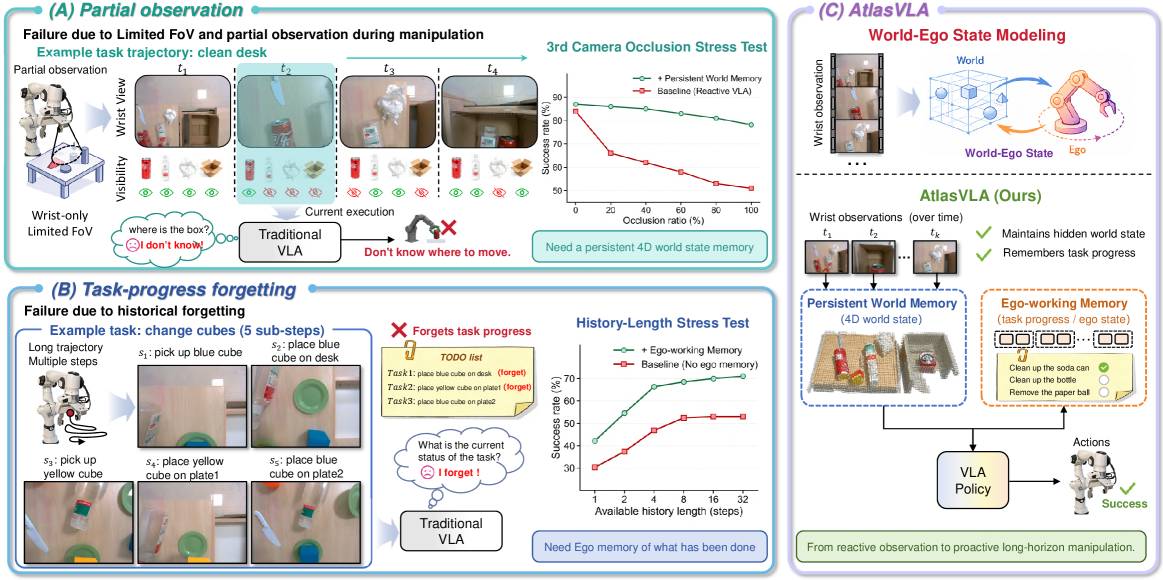
虽然视觉-语言-动作(VLA)模型推动了具身智能的发展,但其固有的反应式范式严重限制了在部分可观测和长时程任务中的表现。当仅使用单目腕载相机时,模型不可避免会遭遇因物体离开视野导致的感知遗忘,以及多步执行过程中的时序任务进度遗忘。 为了克服这些瓶颈,我们提出 AtlasVLA,一个通过持久世界-自我状态从直接反应式操控过渡到主动推理的新框架。AtlasVLA 采用双记忆架构:4D 持久世界状态记忆 将瞬时的二维观测提升为全局更新的体素哈希空间状态,以解决视觉盲区;自我工作状态记忆 则跟踪历史自我状态和任务进度。通过将扩散变换器(DiT)基于联合的世界-自我状态进行条件生成,AtlasVLA 实现了稳健的空间推理。 在 LIBERO、RLBench 和真实世界基准上的广泛评估表明,仅使用腕载相机,AtlasVLA 就达到了最先进的性能。值得注意的是,它显著优于多视角基线,在 LIBERO-Long 上取得了 9.4% 的绝对成功率提升,在真实世界长时程任务上取得了 17.5% 的提升。
论文精读
TL;DR AtlasVLA 用 4D 体素世界记忆 + 自我工作记忆,让 VLA 从腕部单视角持续构建全局场景与任务进度,在长程操控上反超多视角基线(LIBERO-Long 提升 9.4%,真实世界提升 17.5%)。
问题
问题背景
具身智能领域的 VLA(Vision-Language-Action)模型已从直接映射感知到动作的范式,逐步走向长程任务与部分可观测环境。业界主要关注如何在真实机器人上实现稳定、可迁移的操作能力,尤其是仅依赖腕部相机等有限视角时的可靠性。
现有方法局限
当前多数 VLA 采用反应式控制:策略网络将当前帧视觉输入直接回归为动作,缺少对历史信息的显式建模。这带来两类典型失效:
- 感知遗忘:目标物体移出视野后,模型无法利用已观测到的空间结构,导致操作盲目或错误重试。
- 进度遗忘:长程任务中,模型难以区分“已完成子步骤”与“待执行子步骤”,容易重复动作或遗漏关键阶段。
多视角输入虽能缓解盲区,但硬件成本高、标定复杂,且跨视角融合引入额外推理延迟。现有记忆增强方法多局限于粗粒度场景图或稠密特征缓存,缺乏对世界坐标和自身状态的一致性维护。
为什么这个问题难/重要
难点在于时空一致性与实时推理的平衡:机器人需要在毫秒级决策中,将历史 2D 观测增量式融合为可查询的 4D(空间 + 时间)表征,同时持续更新自身位姿与任务进度。这不仅是模型容量问题,更涉及表征效率、内存管理和扩散策略条件化的协同设计。
业界对单视腕部方案的关注度持续上升,因为它直接简化部署、降低成本、提升泛化能力。若能以单目输入达到或超过多视角方法的成功率,将极大推动 VLA 在真实仓储、家庭服务等长程任务中的落地。
行业类比
类似自动驾驶中BEV(鸟瞰视角)感知将多帧单目图像提升为统一空间表征,AtlasVLA 把这一思想迁移到操作任务,用持久世界状态替代对多摄像头的依赖。
核心洞察
- AtlasVLA 的核心贡献是将 VLA 从反应式观测到动作的直接映射,重构为基于持久世界-自我状态的主动推理。以往 VLA 大多以当前帧或少量历史帧作为条件,模型在物体离开视野后无法保持空间记忆;AtlasVLA 通过 4D Persistent World State Memory 将瞬时 2D 观测提升到全局更新的体素哈希空间状态,同时用 Ego-Working State Memory 跟踪历史自我位姿与任务进度,联合条件作用于扩散 Transformer。这一显式持久记忆解决了长程任务中的感知遗忘与进度遗忘,使单手腕相机也能具备跨时刻的空间推理能力。
- AtlasVLA 用单手腕相机在 LIBERO-Long 和真实世界长程任务中超过多视图 baseline,这挑战了“增加相机视角是解决遮挡和视野外物体的必要手段”这一工程假设。现有机器人系统常依赖第三视角或立体相机提高覆盖率,但硬件成本、标定复杂性和部署限制更高。AtlasVLA 表明,通过在世界-自我联合状态中显式累积历史空间信息,单视角的盲区可以被模型内部补偿,甚至在成功率上取得绝对提升。这对实际部署有直接启示:可降低传感器配置要求,同时不失长程操纵鲁棒性。
方法
方法概述
AtlasVLA 的输入为单手腕相机 RGB 观测、语言指令与机器人本体状态(关节角、末端位姿等),输出为低维动作序列。核心是双记忆架构,将瞬态感知与任务进度固化下来,再交由扩散 Transformer (DiT) 生成动作。
1. 4D Persistent World State Memory(持久世界状态记忆)
将逐帧 2D 观测通过深度估计或隐式神经场等方式提升到 3D,并维护一个体素哈希表存储历史空间信息,形成全局一致的 4D 场景表示。即使物体离开视野,模型仍能通过查询过去体素找回方位,解决视觉盲区与感知遗忘。
2. Ego-Working State Memory(自我工作状态记忆)
跟踪历史 ego state(如末端位姿、开合状态)与任务进度(如已完成的子目标),以紧凑时序向量表示。它与世界状态记忆互补:世界记忆回答“物体在哪里”,ego 记忆回答“我做过什么、下一步该做什么”。
3. World-Ego-Guided Action Generation(世界-自我引导动作生成)
将上述联合状态作为条件注入 DiT,通过扩散过程从噪声中恢复动作序列,使动作生成具备空间推理与长期一致性。
与直接映射瞬时观测的 VLA 不同,AtlasVLA 通过显式构建可更新的世界-自我状态,将单目感知变为具备记忆的主动推理,从而仅靠腕关节相机获得超越多视角基线的长程操作能力。
实验
实验设计
AtlasVLA 在三个基准上验证:LIBERO(含长程任务)、RLBench 和真实世界长程操作任务。所有评估仅使用腕部单摄像头,与多视图基线对比。模型基于扩散 Transformer(DiT)条件化于联合世界-自我状态。
关键发现
- 在 LIBERO-Long 上,绝对成功率提升 9.4%。
- 在真实世界长程任务中,绝对成功率提升 17.5%。
- AtlasVLA 仅用单视角即达到 SOTA,证明持久 4D 世界状态与自我工作记忆有效缓解了感知遗忘与任务进度遗忘。
与基线对比解读
传统 VLA 是反应式映射,单视角下物体离开视野即丢失信息;多视图虽可缓解但部署成本高、同步难。AtlasVLA 通过全局更新的体素哈希空间状态 + 历史自我状态追踪,把“看到过”的信息保留下来,使单视角性能反超多视图。对实际工程的启示:单目腕部相机 + 持久记忆方案可显著降低传感硬件成本与标定复杂度,同时提升长程操作鲁棒性,更适合真实机器人部署。
行业影响
落地场景
AtlasVLA 的 单腕部相机 + 持久世界-自我状态 直接适配三类高价值场景:
- 电商仓储拣选:在订单履行中心,机械臂需要从货架抓取多种物品并放入周转箱,物品常因遮挡或移出视野而丢失跟踪。AtlasVLA 通过 4D 持久世界状态记忆 保留物体空间位置,支持连续多步抓取,无需重新搜索。
- 实验室自动化:移液、样本转移等长时程任务中,试剂瓶和孔板位置在操作中可能不可见;Ego-Working State Memory 记录任务进度和本体状态,避免步骤遗漏或重复。
- 家庭服务机器人:从橱柜取食材到烹饪的长序列操作,单相机视野频繁切换,持久记忆让机器人记住锅具、调料位置,连续完成多个子任务。
商业价值
- 降本:省去多视角相机或外部动捕系统,硬件 BOM 成本显著降低;同时减少因感知遗忘导致的任务失败和重复操作,提升设备有效运行时间。
- 增收:成功率绝对值提升 9.4%(LIBERO-Long)和 17.5%(真实长时任务),直接增加自动化系统的单位时间产出,加速投资回报。
- 体验提升:机器人不再频繁停滞或需要人工重置,减少干预频率,增强客户对自动化方案的信任。
跟现有产品/工作流的接口
AtlasVLA 可作为现有 VLA 模型(如 RT-2、OpenVLA)的即插即用增强模块:
- 模型层:替换观察编码器和记忆模块,保留扩散 Transformer 动作头;训练数据可直接复用 LIBERO / RLBench 数据集,微调成本可控。
- 软件层:封装为 ROS 2 节点,订阅单路 RGB 和本体状态,发布关节目标;持久记忆存储于 GPU 显存或嵌入式内存,支持跨会话。
- 部署:与现有机械臂控制栈(如 MoveIt、ROS Control)并行运行,在长时任务前加载 AtlasVLA 作为高层策略,输出子目标给底层控制器。
局限
- **训练与部署开销**:AtlasVLA 引入双记忆架构,需在线维护 **4D 体素哈希世界状态** 与 **Ego-Working State Memory**,训练时依赖额外自监督目标(如体素占用预测、进度回归),推理时逐帧更新全局地图,计算与存储成本高于直接 action mapping 的 VLA。论文虽在附录给出 runtime analysis,但正文未讨论实时性;对于真实机器人 20–50 Hz 高频控制,体素更新与 DiT 条件生成的延迟可能成为瓶颈。此外,体素分辨率与场景尺度强相关,跨场景部署时需要重新标定。
- **任务与场景泛化**:评估集中在 **LIBERO**、**RLBench** 和特定真实世界桌面操作任务,这些环境多为结构化桌面、静态背景、刚体物体,缺乏动态障碍、移动基座或可变形物体(如布料、液体)的测试。单腕部相机虽然硬件成本低,但世界状态建模依赖深度估计与相机位姿,若视觉里程计漂移或物体发生非刚体形变,全局体素地图可能失效,导致动作预测错误。因此,方法在非结构化环境中的鲁棒性尚未验证。
- **对比基线与统计稳健性**:论文重点与多视角 baseline 对比,但未系统比较其他 **memory-based VLA**(如带有外部记忆的 transformer 或 RLBench 上的记忆增强方法),难以确定性能提升完全来自双记忆设计,而非训练数据、策略架构或技巧。此外,报告的主要指标为成功率,缺少多次随机种子下的方差分析,真实世界任务数量有限,统计显著性有待进一步验证。