iFAN: 面向普通掩码 Transformer 的推理感知学习
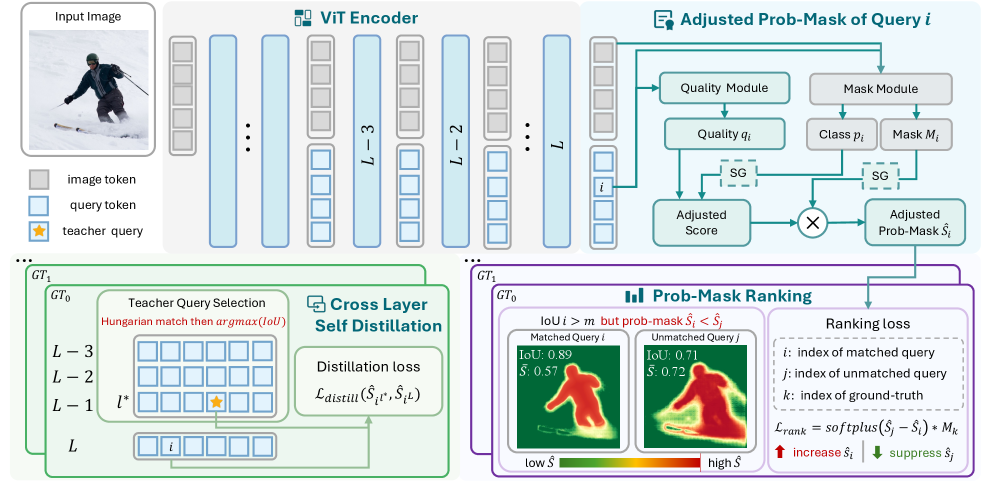
基于查询的掩码 Transformer 通过最终层查询预测的像素级竞争来组装分割结果,但训练时并未显式优化这一推理过程。我们识别出两个关键不匹配:概率-掩码分数 最高的查询未必生成最准确的掩码;最终层解码可能丢弃中间层的更优预测。 为此,我们提出 iFAN(Inference-Aware Learning),一种用于普通掩码 Transformer 的通用训练框架。iFAN 引入 调整概率-掩码排名(APMR),将查询竞争与预测掩码质量对齐,并抑制高置信度但不准确的竞争者;同时采用 跨层自蒸馏(CLSD)将更强的中间层预测迁移至最终层。排名与蒸馏目标仅在训练时生效,推理仍保持高效的最终层解码。 在 COCO、ADE20K 和 Cityscapes 上的实验表明,iFAN 在全景、实例和语义分割,以及不同架构、骨干网络规模和输入分辨率下均带来一致提升。平均改善 1.20 PQ、1.30 AP 和 0.63 mIoU,额外参数、FLOPs 与推理延迟可忽略不计。
论文精读
TL;DR iFAN 解决 plain mask transformer 训练与推理不一致:通过 APMR 对齐 query 竞争与 mask 质量,并用 CLSD 将中间层强预测蒸馏到最终层,训练专用、推理几乎无额外开销,平均提升 1.20 PQ / 1.30 AP / 0.63 mIoU。
问题
问题背景
query-based mask transformers 采用一组可学习 query,每个 query 独立预测类别分布与 mask,最终通过像素级竞争组装分割输出,已成为语义、实例和全景分割的主流范式。
现有方法局限
现有训练通常只优化最终层预测与 ground truth 的损失,但推理时的 query 竞争机制没有被显式建模。具体存在两个关键错位:
- 最高 probability-mask score 的 query 未必产生最准确的 mask,导致竞争排序与 mask 质量脱节。
- 最终层解码可能丢弃中间层的更优预测,中间层虽有更强特征但缺乏有效传递机制。
此外,quality-aware 类方法往往需要修改网络结构或增加额外推理分支,带来参数和延迟开销;中间监督/自蒸馏多用于分类或单层输出,未直接对齐 query 竞争中的 mask 质量。
为什么这个问题难/重要
核心挑战在于推理时的像素级竞争本质上是离散 argmax 操作,不可微,难以直接纳入梯度优化。同时,训练目标需要在不改变推理结构、不增加参数/FLOPs 的前提下,让 query 的竞争分数与 mask 质量一致,并让最终层吸收中间层优势。这对工业部署尤其重要:模型容量受限时,如何通过训练策略而非架构改动提升 mask transformer 精度。iFAN 通过 APMR 和 CLSD 训练目标实现这一点,推理保持高效最终层解码,在 COCO/ADE20K/Cityscapes 上带来稳定提升。
行业类比
类似推荐系统中排序模型优化 CTR 预估分数,但实际业务指标是转化收益,需要对分数进行校准和蒸馏,才能让排序竞争真正服务于目标。
核心洞察
- 训练目标与推理时 query 竞争机制不匹配是限制 plain mask transformer 性能的关键因素。现有方法通常假设 probability-mask score 最高的 query 对应最佳 mask,但实际二者常不一致。iFAN 提出 **APMR**,显式对齐 query 排名与预测 mask 质量,抑制高置信但错误的竞争者,从而在训练阶段优化推理行为。这不同于改进 query 初始化或特征融合,而是直接修正输出组装规则。
- 中间层预测可能优于最终层,利用跨层自蒸馏可将其知识迁移至最终层且保持推理高效。最终层解码可能丢弃中间层的优质预测,iFAN 通过 **CLSD** 让中间层作为教师,将更强预测蒸馏到最终层。该目标仅在训练时使用,推理仍采用最终层解码,不增加参数、FLOPs 和延迟。这种 training-only 设计对实际部署尤其有价值,因为精度提升不牺牲效率。
方法
iFAN 面向 plain mask transformers 的推理机制与训练目标之间的不匹配问题,输入为 query-based mask transformer 的逐层预测结果(每个 query 预测类别分布与掩码 logits),输出为最终层解码得到的精确分割图,训练期间额外引入两个专用模块:Adjusted Probability-Mask Ranking (APMR) 与 Cross-Layer Self-Distillation (CLSD)。
核心流程
- APMR:针对像素级竞争中“高概率分数不等于高质量掩码”的现象,对查询的排名分数进行校准。通过结合预测掩码的质量指标(如 IoU 或 mask score)对原始类别概率进行加权或重排序,使最终竞争更偏向真正准确的查询,同时显式抑制高置信但掩码错误的竞争者。
- CLSD:利用中间层往往能产生更优掩码的特性,将中间层更强大的预测(例如来自更深特征融合或集成)作为软标签,蒸馏到最终层的输出分布上,缩小最终层与中间层的解码差距。
- 训练与推理解耦:APMR 与 CLSD 的损失仅在训练阶段计算,推理时完全移除这些模块,保持原有 final-layer decoding 的高效性,因此不增加参数量、FLOPs 或延迟。
与同类工作的差异在于:现有方法多关注中间监督或后处理精修,而 iFAN 直接优化推理时的查询竞争逻辑本身,通过排名校准与跨层自蒸馏让最终层解码器在无额外开销下逼近更优解。
实验
实验设计
iFAN 在 COCO、ADE20K 和 Cityscapes 三个数据集上验证,覆盖 panoptic、instance、semantic 三类分割任务。实验在多种架构、不同 backbone 规模和输入分辨率下进行,还包含 超参数敏感性、整体消融、APMR 消融、CLSD 消融 和 模型规模影响 等分析。训练目标仅用于训练阶段,推理仍采用高效的 final-layer decoding。
关键发现
iFAN 平均提升 1.20 PQ、1.30 AP、0.63 mIoU,且额外参数、FLOPs 和推理延迟可忽略。消融显示 APMR 和 CLSD 均有贡献,二者联合进一步提升性能。在不同 backbone 和分辨率下稳定性好。
与基线对比的深度解读
相比 plain mask transformers 基线,iFAN 的收益来自两个针对性修复:APMR 将 query 竞争与 mask 真实质量对齐,抑制高置信低质量的竞争;CLSD 将中间层更强的预测蒸馏至最终层,缓解 final-layer decoding 舍优取劣的问题。由于推理过程不变,该方法可作为通用训练框架直接集成到现有 query-based 分割模型中,无需改变部署架构。
行业影响
落地场景
iFAN 作为训练框架可直接嵌入任何 query-based mask transformer 的分割任务训练流程。典型落地包括:
- 自动驾驶:对车载摄像头图像做 panoptic segmentation,提升车道线、行人、可行驶区域边界精度,且不增加推理延迟。
- 电商内容生成:商品图自动抠图与背景替换,需要高精度 instance segmentation;iFAN 可提升 mask 质量,降低人工修图成本。
- 医学影像:器官或病灶分割(如 CT/MRI),边界准确性直接影响诊断辅助。
商业价值
核心是零推理开销的精度提升:不增加参数、FLOPs、延迟,意味着可在现有硬件和部署管线中直接升级模型,无需重新设计推理服务。分割精度提升直接降低下游错误率——例如自动驾驶中的漏检/误检减少,电商抠图人工修正工作量下降,医学分割的标注审核成本降低。对云 API 服务商,同样算力可提供更高质量输出,增强产品竞争力。
与现有产品/工作流的接口
iFAN 仅修改训练目标(APMR 排序损失 + CLSD 跨层蒸馏),推理代码不变,因此集成成本极低:
- 在训练 pipeline 中加两个 loss 项,替换原有损失计算模块。
- 支持多种架构(Mask2Former、Mask DINO 等)和 backbone,无需改动数据加载、评估、部署代码。
- 可结合现有 MLOps 中的分布式训练、混合精度、模型蒸馏等工具链。
具体示例:在电商平台的商品自动分割服务中,可加载 iFAN 训练后的 Mask2Former checkpoint,直接替换线上模型,无需修改 Triton/TorchServe 服务配置;在自动驾驶感知模块中,将 iFAN 损失加入训练脚本,重新训练后导出 ONNX/TensorRT,推理时延不变。
局限
- **适用范围局限在 plain mask transformers**。iFAN 的核心竞争机制依赖于 final-layer 查询预测的逐像素竞争,而 APMR 与 CLSD 的设计也针对这一特定解码流程。对于采用 deformable attention、不同输出组装方式或其他更复杂的 mask transformer 变体,其有效性未经验证,迁移到这类架构时可能需要重新设计排序或蒸馏策略。此外,论文未讨论当查询数量极多或输入分辨率很高时,训练阶段引入的额外排序与蒸馏计算是否会导致显存或时间开销显著增加,尽管推理开销可忽略。
- **CLSD 依赖中间层预测质量**。Cross-Layer Self-Distillation 假设中间层预测通常优于最终层,但这一假设并不总是成立。当中间层训练不充分、产生噪声或过度拟合特定尺度时,将其作为教师信号可能向最终层传播偏差,甚至损害性能。论文在消融中可能显示了默认设定下的正值,但缺乏对中间层可靠性条件的深入分析,例如在不同训练阶段或不同数据集上的动态变化。实际部署时,可能需要额外监控或调整蒸馏权重,增加了调参负担。
- **方法创新组合多于原理突破**。APMR 调整概率-掩膜排序的本质类似于已有的 quality-aware 排序或 mask-aware IoU 修正,CLSD 也接近中间监督或自蒸馏的常见做法。iFAN 的价值在于将它们系统地整合到 plain mask transformer 的训练框架中并验证了多任务一致性,但并未引入全新的理论视角或颠覆性组件。若与更基础的训练范式改进(如 Loss 设计或查询初始化)相比,其提升幅度属于渐进式的稳健增强,可能不足以单独支撑一个全新的研究方向。