UniWorld-View: 基于视频扩散模型的大基线视图合成
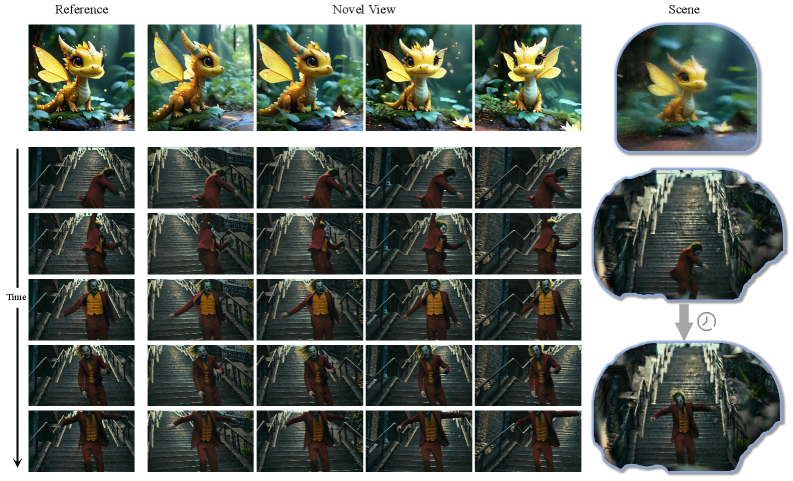
社交媒体上大量随意拍摄的单目视频和图像为沉浸式内容创作提供了宝贵资源,从这些稀疏观测中生成新视角能显著提升用户体验。然而,当输入覆盖极度有限时,生成具有精确相机控制且几何一致的照片级视角仍具挑战。基于重建的方法(如 NeRF 和 3D Gaussian Splatting (3DGS))在稀疏输入下性能严重退化,且无法显式处理遮挡。生成式方法缓解了数据需求,但仍因不准确或隐式的几何引导而难以实现大基线视图合成。 为解决上述限制,我们提出 UniWorld-View,一个从单目输入进行可控大基线新视图合成的统一框架。UniWorld-View 将显式 3D 引导与生成式扩散建模相结合,以实现精确相机控制和几何一致的视图生成。几何引导通过一种遮挡感知的点云渲染策略获得,该策略解决了可见性歧义,并为基于扩散的合成提供准确先验。通过将此渲染策略与强大的视频扩散骨干耦合,UniWorld-View 在极端相机运动和宽基线变化下也能实现高保真新视图生成,并可进一步为下游动态 3DGS 重建提供多视角视频。 在 WorldScore 基准和零样本新视图合成基准上的实验证明了 UniWorld-View 在可控性、几何一致性和视觉保真度方面的有效性。
论文精读
TL;DR UniWorld-View 将遮挡感知的显式点云渲染与视频扩散模型结合,在极稀疏输入和大基线变换下生成几何一致、高保真的多视角视频,并支持动态 3DGS 重建。
问题
问题背景
大基线新视角合成(large-baseline novel view synthesis)致力于从极少输入视图(甚至单目)生成任意相机位姿下的高保真图像,是 VR/AR、3D 内容创作和机器人导航等沉浸式体验的核心技术。
现有方法局限
- 重建式方法(如 NeRF、3D Gaussian Splatting)依赖多视图几何约束,当输入极度稀疏时优化不稳定,细节区域易出现模糊或空洞;它们显式建模常忽视遮挡关系,导致不可见区域渲染失败。
- 生成式方法(如扩散模型)降低了数据需求,但依赖隐式几何先验,在相机大幅位移(大基线)时缺乏精确位姿对齐能力,生成结果常出现多视图不一致、几何扭曲或遮挡边界伪影。
困难与重要性
大基线视角合成需要模型在仅有少量观测时推断广阔未观测空间,这要求同时完成遮挡推断、三维结构保持和高清纹理生成,对场景表示的完备性和几何推理能力提出极高挑战。该问题的突破将直接推动轻量化 3D 内容生产(如仅凭几张照片生成可探索的虚拟场景)和动态 4D 重建,业界对可控且一致的多视图生成需求日益迫切。
行业类比
类似于自动驾驶仿真中从稀疏相机环视图像重建全景 3D 场景用于感知测试,大基线视角合成同样需在严重遮挡和大范围缺失下兼顾几何一致与视觉保真。
核心洞察
- **显式遮挡感知点云渲染作为扩散模型的先验**:UniWorld-View 通过“三重重投影”和“法线过滤”构建遮挡感知的点云渲染,将 3D 结构的可见性信息显式地注入视频扩散模型。这与许多直接依赖隐式几何先验(如深度估计或预训练 NeRF)的生成式新视角合成方法不同,能更可靠地处理大基线移动下的遮挡区域,从而提升几何一致性和相机控制精度。
- **将视频扩散模型用于单目大基线视角合成**:该工作将预训练的视频扩散模型作为生成骨干,通过双流条件注入(CLIP 图像特征与遮挡感知渲染图)实现从单张输入图片到大幅相机运动下的多视角视频生成。相较于传统的基于 3D 重建(NeRF/3DGS)的流水线,这种方法在输入极度稀疏时避免了重建崩溃;相较于逐帧生成的方法,视频模型能更好地保持时序一致性,并可进一步支撑动态 4D 重建。
方法
方法总览
输入为单张参考图像或稀疏的单目视频帧,并附带对应的相机位姿。输出为目标视角下的高保真新视图,可进一步生成多视图视频,用于动态 3DGS 重建。
关键模块
遮挡感知点云渲染:
- 首先,利用现有多视图立体重建或单目深度估计,从输入中构建稀疏 3D 点云。
- 引入三重重投影 (Triple-Reprojection) 机制,将点云分别投影到参考视图、目标视图和中间虚拟视图,通过一致性检验消除遮挡区域的投影歧义。
- 结合法向过滤 (Normal-Filtering),剔除几何表面法向与观察方向偏离较大的点,进一步修正可见性,最终渲染出对齐目标视角的几何引导图(如 RGB 图像或特征图)。
双流条件视频扩散模型:
- 以强大的视频扩散 backbone(如 Stable Video Diffusion)为基础,构建双输入流:一条为噪声潜变量,另一条为来自遮挡感知渲染的几何引导特征。
- 将目标相机参数通过嵌入层注入扩散网络,实现精确的视角控制。训练时,模型学会在几何先验的约束下去噪生成多帧连续的视图序列。
训练与场景生成:
- 数据策展:从大规模视频数据中筛选大基线运动场景,确保训练覆盖极端视角变化。
- 推理时,可按层构建点云(Layer-wise Point Cloud Construction)并迭代生成多视图视频,用于下游动态 4D 重建(如动态 3DGS)。
与同类方法的差异
与 NeRF、3DGS 等重建方法不同,UniWorld-View 不依赖密集的多视图采样,在输入极端稀疏时仍能合成清晰结果;相较于隐式几何引导的生成式新视图合成方法,它通过显式的遮挡感知点云渲染,提供了更精确的几何先验,从而在大基线 (large-baseline) 视角变化下实现更优的几何一致性和视觉保真度。
实验
实验设计
论文在 WorldScore 这一大规模、多场景、覆盖极端相机基线的 benchmark 上进行主实验,同时也在多个 zero-shot 新视角合成 (NVS) 基准上评估泛化能力。输入为单目视频或稀疏图像,目标是从大幅视角变化下生成高保真且几何一致的新视图。对比的基线包括重建式方法(如 NeRF、3DGS)以及生成式方法(如 Zero-1-to-3、SyncDreamer 等),重点考察在稀疏输入和大基线条件下的可控性与视觉质量。
关键发现
- 几何一致性与遮挡处理:引入的 occlusion-aware point cloud rendering 通过三重重投影与法向过滤有效解决了可见性歧义,使扩散模型获得高质量 3D 先验,避免了生成式方法常见的多视图不一致。
- 大基线稳定性:借助视频扩散模型的时序一致性,UniWorld-View 在极端相机运动下仍能保持平滑的视图过渡,显著优于仅依赖单帧生成的方法。
- 下游任务增益:生成的多视角视频可直接用于动态 3DGS 重建,形成从稀疏单目输入到 4D 重建的闭环,展现了作为通用 3D 内容生产组件的潜力。
基线对比深度解读
传统重建方法(NeRF、3DGS)在稀疏输入下会因几何约束不足而崩溃,且不能显式处理遮挡,导致新视图中出现伪影或空洞。生成式方法虽然降低了对数据覆盖的需求,但其隐含的几何引导往往不准确,大基线变化时容易产生身份漂移或几何扭曲。UniWorld-View 通过 显式 3D 点云渲染与扩散模型的耦合,将精确的几何先验注入生成过程,既弥补了重建方法对密度的依赖,又解决了生成方法控制弱的问题。实验表明,该架构在 WorldScore 的大基线场景中实现了可控性与视觉保真度的最佳平衡,且零样本泛化能力优于需要每场景优化的重建管线。
行业影响
核心落地场景
UniWorld-View 以单目视觉输入实现大基线新视角合成,直接赋能 VR/AR 沉浸式内容、游戏资产生成、电商 3D 展示、社交媒体互动创作。特别地,它支持从单目视频生成多视角动态内容,服务于 4D 重建与可编辑动态场景,在短视频特效、虚拟直播、自动驾驶数据增强等场景有明确需求。
商业价值
- 降本:无需多相机阵列或专业扫描设备,仅需普通单目拍摄即可生成高质量多视角素材,大幅降低 3D 内容采集与制作门槛。
- 增效:将传统手工建模或密集拍摄的流程缩短为数秒生成,加速电商 SKU 上线、虚拟场景搭建等环节。
- 体验提升:为用户提供自由视角的沉浸式浏览(如 360° 商品旋转),增强互动性与转化率;视频中新颖运镜效果也能提升用户停留时长与创作趣味性。
与现有工作流的集成
UniWorld-View 可作为 生成式预处理模块 插入现有 3D 重建管线:
- 输出多视图 RGB 及深度先验,无缝对接 NeRF / 3DGS 等重建框架 的稀疏输入需求,提升重建质量。
- 其 遮挡感知点云渲染和视频扩散模型 均基于主流架构,可通过 Hugging Face diffusers 或 PyTorch 导出 ONNX 集成,便于在 MLOps 流水线中编排。
- 可封装为 REST API 或插件,供视频编辑软件、游戏引擎(Unity/Unreal)调用,实现从单张图到可探索场景的自动化生成。
具体应用案例
- 电商 3D 商品展示:卖家上传单张商品照片,系统生成围绕物体的高保真多角度视图,形成丝滑的 360° 旋转视频,降低多角度拍摄成本,提升买家决策信心和店铺转化。
- 社交媒体内容工具:创作者用手机拍摄一段单视角视频,平台自动生成大范围环绕运镜或子弹时间效果,产出电影级多视角动态,增加内容差异化和传播性。
局限
- 显式几何先验的引入依赖单目深度估计或运动恢复结构(SfM)重建的点云质量;若输入图像稀疏、纹理缺失或包含动态元素,初始点云可能不完整或带有噪声,进而影响后续遮挡感知渲染的准确性,导致生成视图出现形变或伪影。工程落地时,前端重建模块的鲁棒性决定了整个管线能力的上限,对输入数据的拍摄条件有隐性要求。
- 模型采用视频扩散模型作为生成主干,推理时需执行多步去噪过程,生成单帧或短视频的计算开销较高,难以满足实时交互或移动端部署需求。尽管可通过蒸馏、步长缩减等手段加速,但当前方案离实用化的低延迟沉浸式内容创作仍有距离,在要求快速反馈的VR/AR场景中面临挑战。
- 动态场景处理仍为两阶段流水线:先由UniWorld-View生成多视图视频,再依赖动态3DGS进行4D重建,并非端到端训练。这导致动态区域的几何一致性与时间稳定性受限于后处理重建算法,若生成的视频帧存在细微的几何跳变,会在动态3DGS中放大闪烁现象,降低沉浸体验。统一的动态视图合成与4D建模框架仍待研究。