当注意力失明:ALiBi 位置编码中的数值失败
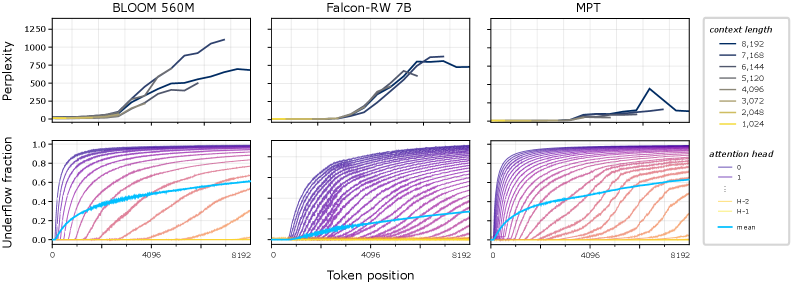
我们识别了 ALiBi 位置编码中一个此前被忽视的失败模式:其线性偏置缩放会下溢浮点精度,导致大量注意力权重归零,使受影响的注意力头部分失明。我们分析了该失败模式,刻画了其影响,并考察了四种缓解策略。我们进一步证明了该现象在基于 ALiBi 的最新预训练模型中的实际发生。通过使用 1.48 亿参数的解码器模型进行全面的预训练实验,我们将其影响与上下文外退化(out-of-context degradation)分离开来。 我们发现,ALiBi 的失败模式会显著损害令牌检索(token retrieval),而对标准解码器基准的影响较小。我们提出了四种训练时的缓解策略,并分别及组合评估了它们的效果,发现对数缩放距离在 passkey 检索中带来最一致的改进。尽管存在该问题,默认的 ALiBi 斜率仍然出人意料地是一个强基线,尤其是在大海捞针(needle-in-a-haystack)检索任务中。基于这些发现,我们为使用 ALiBi 训练模型提供了具体建议。
论文精读
TL;DR 揭示 ALiBi 位置编码因浮点下溢导致远距离 token 注意力权重归零的失效模式,解释其长上下文检索缺陷,并提出对数距离缩放等缓解策略。
问题
问题背景
Transformer 模型依赖位置编码捕捉序列顺序。ALiBi (Attention with Linear Biases) 作为简洁高效的相对位置编码方案,通过给注意力分数加上与距离成正比的偏置项,实现了优异的长序列外推能力,被 BLoom、MPT 等主流开源模型广泛采用。
现有方法局限
ALiBi 的线性偏置公式为 (\text{bias} = -m \cdot |i-j|),其中 (m) 是随头递增的斜率。当序列长度增大或斜率较大时,偏置的绝对值极易超过浮点数的指数范围,导致 softmax 下溢 (underflow):指数函数将极小的输入映射到 0,使对应的注意力权重完全归零。这会令受影响的注意力头在长距离上 “失明”,无法将当前位置与远距离 token 关联。此前该问题未被充分认识,因为常用的语言建模基准(如困惑度)对个别注意力头失效不敏感,但长程检索类任务会严重受影响。
困难与重要性
数值下溢问题极为隐蔽——它不会引发显式的错误或训练崩溃,而是悄然削弱模型长程推理能力。随着业界对 100K+ token 超长上下文模型的追求,ALiBi 的这种失效模式将越来越普遍。深入理解并修复该问题,不仅有助于提升现有 ALiBi 模型的鲁棒性,更为设计下一代数值稳定的位置编码提供了关键洞察。作者在论文中通过 148M 参数的预训练实验将其与分布外退化解耦,证实了问题真实存在且可复现。
行业类比
类似推理引擎中因数值精度导致的静默信息丢失,若不做针对性缓解,在长文档问答、代码理解等依赖长程关联的系统中,模型可能无征兆地漏掉关键片段,造成难以排查的精度下降。
核心洞察
- ALiBi 的线性偏置在长上下文下会发生浮点下溢,使注意力权重清零,导致部分注意力头“失明”,而标准困惑度基准几乎无法反映这一缺陷。该工作首次系统分析了这一数值故障模式,并指出它特异地损害了令牌检索任务(如 passkey retrieval),但未明显影响语言建模损失。这揭示了现有评测对位置编码长程建模能力的盲区,推动工程中对长上下文评估套件多样化的重视。
- 尽管存在精度问题,默认 ALiBi 斜率在干草堆中寻针(needle-in-a-haystack)等检索任务上依然保持强劲基线表现,甚至优于部分修复方案。这种反直觉现象表明 ALiBi 的线性偏置所引入的归纳偏置可能有助于聚焦远程信息,而提出的对数尺度距离(log-scaled distances)缓解策略既纠正了数值缺陷,又保留了检索优势,为实际模型训练提供了稳健、易实施的推荐方案。
方法
方法概述
本研究遵循“现象诊断 → 可控实验 → 缓解评估 → 实践建议”的流程,系统剖析 ALiBi 位置编码的数值失效问题,并探索训练时修复方案。
1. 输入:ALiBi 中的数值下溢
作者首先观察到,ALiBi 通过在注意力分数上叠加线性距离偏置(bias = -m · |i-j|)来注入位置信息。当序列变长时,距离 |i-j| 增大,负偏置的绝对值迅速增长,导致 softmax 输入值下溢(达到 float32 的最小指数级),使大量注意力权重被截断为 0,对应注意力头功能退化,成为“部分盲”的 head。
2. 关键模块与实验设计
- 失效验证:直接检查主流 ALiBi 预训练模型(如 MPT、BLOOM 等),通过可视化注意力权重分布和 token 检索探针(Passkey Retrieval、Needle-in-a-Haystack)量化失效程度。
- 可控预训练实验:为排除训练数据、上下文长度等混淆因素,在 148M 参数的 decoder-only 模型上,从零开始预训练,分别使用默认 ALiBi 斜率与多种缓解配置,在同等条件下对比。
- 缓解策略设计:提出四种训练时修正方案,均着眼于防止偏置过大导致下溢:
- Clamping:将偏置值强制限制在
[-b_max, 0]区间,避免极端负值; - Robust Slopes:自适应调节斜率
m,使最大距离对应的偏置保持在安全范围; - Log-scaled Distances:用
-m · log(1 + |i-j|)替代线性距离,压缩范围; - Soft Capping:在 softmax 前对注意力 logits 进行平滑截断,类似
tanh映射。
- Clamping:将偏置值强制限制在
3. 输出与核心发现
- 性能度量:在标准语言建模困惑度(perplexity)和两类 token 检索任务上评估。结果显示,Log-scaled Distances 在 passkey retrieval 上改进最稳定,而默认 ALiBi 在 needle-in-a-haystack 任务中意外保持强劲。
- 最终建议:尽管存在数值缺陷,默认 ALiBi 斜率在长程检索上仍有竞争力,但结合 log-scaled 偏置 可进一步提升数值稳定性与检索一致性。
差异点
与先前仅关注外推能力的位置编码研究不同,本工作首次从浮点精度极限出发,定位 ALiBi 的内部注意力失效机制,并提供基于训练时修正的系统对比方案。
实验
实验设计
实验分为两个阶段:(1) 在现有基于 ALiBi 的预训练模型上分析注意力权重的数值下溢现象,通过困惑度(perplexity)和关联检索探针(如 passkey retrieval、needle-in-a-haystack)评估其影响;(2) 从零开始预训练 148M 参数的自回归解码器模型,系统比较不同 ALiBi 配置与四种缓解策略:clamping、robust slopes、log-scaled distances、soft capping,并在相同检索任务及标准语言建模基准上验证。
关键发现
ALiBi 的线性偏置在序列长度增加时极易发生 浮点下溢,导致 softmax 前的偏置项变为零,使注意力权重被大量截断——注意力头部分“失明”。该问题显著削弱了 passkey retrieval 等精确 token 检索能力,但对标准语言模型评测(如困惑度)影响较小。在四种缓解策略中,log-scaled distances 在检索任务上表现最稳定,显著提升了 recall,同时保持了语言建模质量。soft capping 效果有限,而 clamping 虽缓解了下溢但未完全消除检索退化。令人惊讶的是,原始 ALiBi 斜率在 needle-in-a-haystack 检索中依旧保持较强竞争力,说明该编码的归纳偏置本身仍具优势。
与基线对比解读
与默认 ALiBi 相比,数值下溢暴露了其长距离注意力失效的隐蔽代价:模型虽然看似收敛良好(困惑度正常),但实际已丧失处理长上下文关键信息的能力。log-scaled distances 本质上将线性偏置转换为对数空间,避免了小数值的精度丢失,无需大幅改动原始结构即可修复这一问题。实验表明,该策略在不损害标准困惑度基线的前提下,使 passkey 检索准确率回复到健康水平,而 robust slopes 等自适应方法在检索上不够鲁棒。这提醒我们,位置编码的数值特性可能成为影响长文本泛化的隐形瓶颈。
行业影响
落地场景
使用 ALiBi 位置编码 的大语言模型(如 MPT、BLOOM 系列),在需要处理 超长上下文 的任务中广泛部署,例如长文档摘要、对话历史理解、代码仓库分析、金融报告审阅等。本文揭示的 浮点下溢失效模式 会导致注意力权重清零,使模型在长距离上部分 “失明”,直接影响需要跨远距离 token 检索的场景(如 Passkey Retrieval)。因此,对于依赖长上下文窗口的产品(如文档问答系统、上下文感知的编码助手),修复该问题至关重要。
商业价值
- 降本:消除注意力盲区可提高长序列推理效率,减少因无效计算导致的算力浪费;对于 API 服务商,更高效的上下文利用意味着在相同硬件下处理更多请求。
- 增收/体验提升:改进后的模型在长上下文任务上准确率更高,能处理更长的输入而不丢失关键信息,从而提升用户体验和产品竞争力,尤其是在面向专业用户的高精度场景(如法律/金融文档分析)中,可靠性直接转化为客户信任和付费意愿。
与现有产品/工作流的接口
论文提出的缓解策略(如 log-scaled distances、soft capping)可直接集成到训练代码中,仅需修改 position bias 计算函数,无需改动模型架构。对于已部署的预训练模型,可通过推理时调整斜率或添加轻量级后处理来缓解。与主流 Transformers 库兼容,可作为训练配置选项或微调策略,对现有 RAG(Retrieval-Augmented Generation)管道、定制化 LLM 微调服务透明,便于运维团队集成。
具体使用场景
- 电商平台商品描述生成:在生成详细商品描述或总结用户评论时,模型需关注早期对话轮次或长产品参数列表,若注意力盲区,可能输出不完整或不准确的信息,影响转化率。采用 log-scaled distances 可确保远距离依赖的捕获。
- 金融智能投研助手:分析上市公司年报、招股说明书等长文档时,需抽取跨页的关键财务数据。注意力盲区会导致漏检重要指标,误导投资决策。通过训练时使用稳健斜率或 log-scaled distances,可提高信息抽取的召回率。
局限
- - **实验规模较小**:论文仅在 148M 参数的 decoder 模型上进行预训练实验,未验证该失效模式及缓解策略在大规模模型(如数十亿参数)下的表现。实际工业级模型通常远大于此,**下溢问题在更宽的维度或更多头数下可能表现不同**,因此结论的泛化性存疑。此外,训练数据规模也较小,可能未充分暴露长尾分布下的失效影响。
- - **缓解策略的实用性与开销权衡未深入分析**:提出的四种训练时缓解策略(例如 **log-scaled distances**)虽然改善了 passkey 检索,但**可能引入额外计算或实现复杂度**。论文未对比这些策略与直接替换为 **RoPE** 等其它位置编码方案的性能差异,也未讨论在推理加速库中的兼容性,导致工程落地选择时缺少参考。
- - **失效模式的影响范围分析有限**:论文聚焦于 **ALiBi** 特有的线性偏置下溢,但未系统探讨其它基于偏置的位置编码(如 **T5 的相对位置偏置**)是否存在类似数值问题。同时,失效主要损害 **token 检索任务**,对语言建模困惑度等标准 benchmark 影响甚微,**实际应用中可能只有在特定长文本任务中才需关注**,局限性较大。