Towards Physics of Multimodal Pretraining: 知识流、模态协同、早期统一与配方
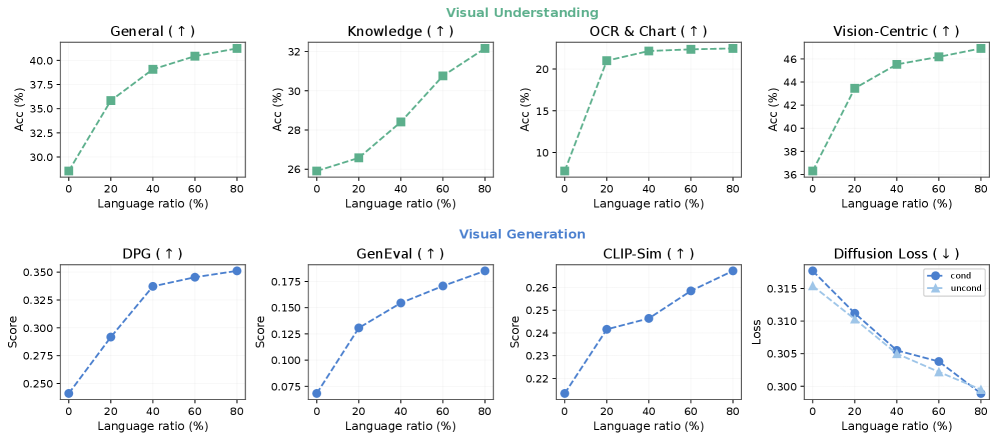
视觉为推进基础模型提供了关键维度,驱动着向原生统一多模态预训练的转变。尽管势头正猛,统一训练中模态交互的设计空间与基本机制仍未得到充分探索。我们通过系统性的多模态预训练探索提供了实证性澄清。在合成数据集和大型真实世界数据集上的受控实验得出了关于多模态预训练物理学的四个关键见解: - 知识流:我们厘清了语言、视觉理解和视觉生成如何在模态间传递知识,揭示了不同的影响模式与不对称性。 - 协同与竞争:我们表明数据“复杂度”在很大程度上决定了模态是否协同,并确定了促进协同的架构选择,例如共享注意力与归一化配合模态特定的前馈层,且发现这些行为可泛化至不同的视觉分词器设计。 - 早期统一:从非常早期阶段统一模态并进行联合训练,比后期对齐或顺序训练更有效。该过程揭示了视觉懒惰现象,即延迟集成会导致模型依赖语言先验。 - 配方:我们推导出高效的预训练配方,仅用5% 的计算预算即可实现强大的生成性能。 这些核心发现随后通过在 2T tokens 上训练多个 13.5B MoE 模型得到大规模验证。我们希望这项研究能为理解和扩展多模态预训练提供有原则的基础。
论文精读
TL;DR 系统揭示多模态预训练中模态交互的底层机制(知识流、协同/竞争、早期统一),并给出仅需 5% 训练量的高效配方,为统一模型设计提供实证基础。
问题
问题背景
多模态基础模型正从分立预训练走向原生统一的多模态预训练,视觉作为关键轴,推动模型同时具备理解与生成能力。
现有方法局限
当前多模态预训练大多采用先单模态预训练、后跨模态对齐的范式(如 CLIP、LLaVA),或在使用冻结的语言模型上嫁接视觉编码器。这些方法对模态间如何交互的底层机制缺乏深入探究,具体表现为:
- 知识流不对称:语言知识向视觉迁移的方向与程度不明确,视觉理解和生成之间的知识共享模式模糊;
- 协同与竞争:在同一损失函数下联合训练时,视觉与语言任务何时相互促进、何时相互干扰,缺乏可泛化的判断标准;
- 统一时机:业界普遍采用晚期融合,但早期统一是否会带来质变,以及为何晚期对齐容易导致模型过度依赖语言先验(视觉懒惰现象)尚未有系统解释。
为什么这个问题难且重要
多模态预训练的计算成本极高,盲目扩大数据与模型规模而不理解模态交互原理,会导致大量的算力浪费。揭示多模态训练的“物理机制”——如知识流动规律、架构设计如何促进协同——能够为设计更高效的预训练策略提供理论依据,是通向更通用、更强大多模态智能的关键。这项研究受到工业界与学术界的广泛关注,因为它直接关系到从对话助手到机器人视觉等一系列应用的底座能力。
行业类比
这就像在自动驾驶感知系统中,摄像头与激光雷达数据的早期与晚期融合抉择,直接决定了模型对环境的鲁棒理解与训练效率,错误的融合策略可能导致信息丢失或产生有害偏置。
核心洞察
- 早期统一 (early unification) 不仅优于晚期对齐,还揭示了 “视觉懒惰” 现象:若视觉模态在训练后期才接入,模型会过度依赖语言先验,削弱视觉理解。这一发现颠覆了先分别训练单模态、再对齐的流行范式,指出从初始阶段就联合训练所有模态才是构建真正统一多模态模型的关键。它对实际工程的启示是,应避免将视觉编码器视为事后插入的组件,而要在架构设计和预训练管道中保障模态从第一刻就平等参与。
- 模态间知识流存在显著不对称性:语言对视觉理解有强迁移效果,但视觉理解向视觉生成的迁移仅限于结构概念 (如位置、计数),语义属性 (如颜色、形状) 几乎不传递;反之,生成对理解的迁移也极弱。这一发现通过合成数据控制实验得到严格验证,打破了以往对多模态任务 “互相受益” 的笼统假设。直接指导预训练数据配比与课程设计:若要提升生成质量,单纯增加图文对未必高效,需要针对性地引入促进特定概念迁移的数据或训练策略。
方法
本工作通过受控实验系统探索多模态预训练的底层机制,而非提出全新模型。整体方法论遵循“输入 → 关键模块 → 输出”线索:
输入与数据设计
- 同时使用文本与图像,覆盖合成概念数据(如 CLEVR 变体,精确控制颜色、形状、结构等属性)和大规模真实世界数据(图文对)。
- 为解析知识流动,精心构造特定概念组合,训练时仅暴露部分概念,测试零样本迁移能力。
关键模块与实验变量
基于 Transformer 的统一模型作为主干,通过控制以下维度展开研究:
- 统一阶段:对比早期统一(from scratch 联合训练所有模态)与晚期对齐(先单独训练语言/视觉再融合),揭示视觉懒惰现象;
- 参数共享策略:在 Transformer 层中,探索共享注意力与归一化 + 模态特定前馈网络的组合,评估对协同的影响;
- 视觉分词器:考察不同设计(离散 vs. 连续 tokenizer)下结论的泛化性;
- 数据复杂度:通过变化 CAPTION 密度、概念多样性等,量化协同 vs. 竞争的转变条件;
- 训练顺序:联合训练 vs. 顺序训练(先语言后视觉),并分析知识转移方向(语言→视觉理解、语言→视觉生成、视觉理解↔生成)。
输出与评估
- 语言评估:通用 NLP 基准;
- 视觉理解:VQA 任务;
- 视觉生成:文本到图像生成质量。
- 从实验规律中提炼高效预训练配方:通过优化数据混合比和早统一策略,仅用 5% 计算量即达到强生成性能,并在 13.5B MoE 模型、2T tokens 规模下验证。
差异点:与多数工作聚焦扩大模型或数据规模不同,该研究首次对多模态预训练的设计空间进行物理级解构,从机制层面揭示知识流、协同条件与早期统一必要性,指引更高效、可解释的下一代多模态基础模型设计。
实验
实验设计围绕两条主线:
- 受控合成实验 使用 CLEVR 环境生成稠密/稀疏 caption 与 VQA 对,控制语义属性(颜色、形状)和结构概念,精确测量跨模态概念迁移。
- 大规模真实数据实验 在统一多模态预训练范式下,系统研究知识流、模态协同/竞争、早期统一策略,并探索数据混合比例与架构选择(共享注意力、模态特定 FFN 等)的影响。
- 最终在 2T tokens 上训练 13.5B MoE 模型,验证可扩展性。
关键发现
- 知识流:语言向视觉理解和生成迁移显著,反之则弱;合成实验中语义属性(颜色/形状)不迁移,结构概念从理解到生成迁移,但反向几乎为零。
- 协同 vs 竞争:数据复杂度决定模态关系;共享注意力与归一化 + 模态特定 FFN 的架构促进协同,泛化于多种视觉 tokenizer 设计。
- 早期统一:极早期模态融合与联合训练优于后期对齐或序列训练;发现“视觉懒惰”——延迟整合使模型过度依赖语言先验。
- 高效食谱:仅用 5% 计算量 达到强生成性能,并通过优化数据混合与架构选择实现。
与基线对比
- 相比后期对齐或序列训练,早期统一在 VQA 和生成指标上提升明显,有效抑制视觉懒惰。
- 相比纯共享参数架构,引入模态特定 FFN 并保持注意力共享,显著提升协同效果,避免竞争。
- 数据混合策略:找到平衡语言、理解、生成的混合比例,相较不对称混合(偏重某一模态),在受限算力下生成质量更优。
行业影响
核心落地场景
该工作揭示了多模态预训练中知识流动、模态协同与早期统一的机理,为构建原生多模态基础模型提供了系统性实证依据。典型落地场景包括:
- 内容创作与编辑平台:结合文本、图像生成与理解能力,实现基于自然语言的高质量视觉内容自动生成与细粒度编辑(如电商商品图生成、广告素材合成)。
- 智能助手与交互系统:原生统一的视觉-语言模型可直接用于多模态对话、屏幕理解、图表分析等场景,支撑更自然的交互体验。
- 自动驾驶与机器人视觉:通过早期融合和高效预训练配方,在有限算力下获得强视觉-语言对齐的感知模型,加速环境理解与指令跟随。
商业价值分析
- 大幅降低预训练成本:论文提出的高效配方仅用 5% 的算力预算即可达到强生成性能,这对算力敏感的团队极具吸引力,直接降低训练 TCO。
- 提升下游任务性能:通过早期统一与共享注意力 + 模态特定 FFN 等架构设计,模型在理解与生成任务上均获得增益,能减少多套模型维护成本,加速产品迭代。
- 改善用户体验:模态协同增强可带来更稳定、更少幻觉的多模态输出,提升内容生成的可靠性和可控性,降低人工后处理成本。
与现有工作流的集成
现有产品多采用后期对齐(如冻结视觉编码器再与 LLM 拼接)或串行训练方式。该工作表明:
- 将视觉与语言从初始层开始统一训练(早期统一)可避免“视觉懒惰”,提升整体融合质量。
- 可将其核心结论转化为模块化集成方案:在现有 transformer 基础上,为视觉 token 引入独立的 FFN 头,与语言共享自注意力层,逐步替换原有视觉编码器。
- 数据混合配比策略可直接用于现有数据管线,优化多模态 SFT 数据的组成,提升生成效果。
具体应用案例
- 电商商品图生成:某电商平台需根据标题和属性生成高质量商品主图。采用本工作的早期统一架构与高效预训练食谱,只需少量算力即可训练出既能理解细粒度属性(颜色、形状)又可生成相应图像的统一模型,替代原有“视觉编码器 + LLM + 扩散模型”的多级流水线,延迟更低且风格更统一。
- 教育内容智能化:在线教育平台需要根据知识点自动生成插图或示意图。利用论文发现的结构性概念从理解到生成的迁移能力,只需提供少量标注该结构的文本,模型即可零样本生成包含正确结构的图像,减少人工绘图成本,加快课程发布速度。
局限
- 研究主要聚焦于视觉和语言模态,未覆盖音频、视频等常见模态,限制了其在更通用多模态场景下的直接适用性。尽管在13.5B MoE模型上验证了核心发现,但扩展到其他模态组合时的“物理规律”是否保持一致仍需探索。
- 合成数据受控实验虽有助于分离变量,但其概念空间相对简单,与真实世界数据的复杂分布存在差距,所发现的知识流非对称性(如视觉理解到生成的弱迁移)可能在复杂数据中呈现不同模式,需要更多验证。
- 架构探索集中于Transformer中的共享注意力和模态特定前馈网络,未深入考察其他流行的多模态融合机制(如交叉注意力、适配器),且固定了视觉tokenizer设计,对连续表示等其他视觉编码方式的泛化性尚不明确。