PAST-Bench: 评测个人智能体中递归自我改进的基础
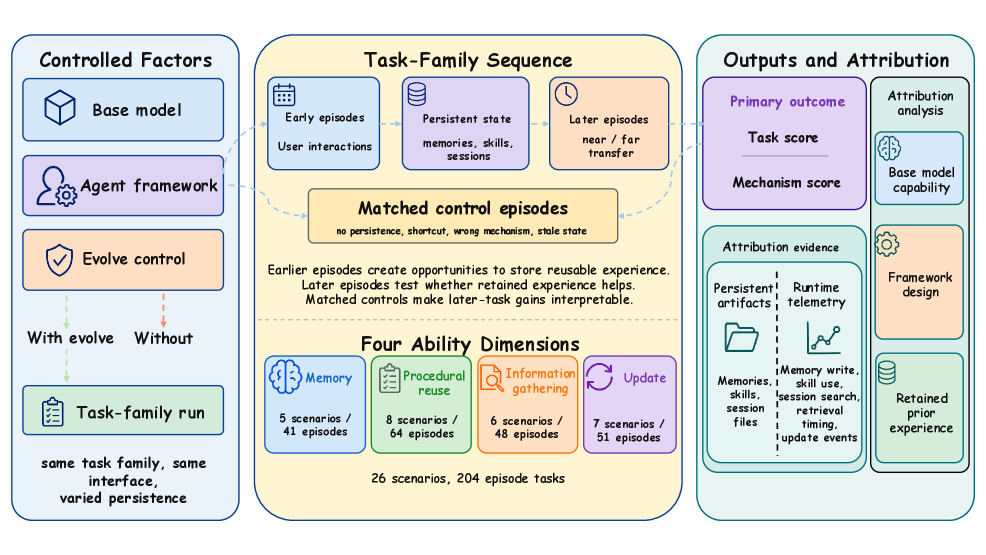
递归自我改进要求智能体将累积经验转化为更好的未来行为。个人 AI 智能体 为此提供了具体研究场景:它们跨会话保留偏好、任务历史、工具例程与习得技能。然而,保留经验是否真的能随时间提升智能体表现,尚未得到系统验证。 我们提出 PAST-Bench 基准,专门隔离并回答这一问题。每个智能体在受控匹配条件下运行有序的全新会话任务序列,通过开关保留经验进行对比。该基准覆盖 26 个场景、204 个 episode,涉及记忆、程序复用、信息收集与更新四类能力。我们不仅报告后期任务的收益,还检验收益是否遵循预期的“保存—检索—更新”路径。 在 7 个基础模型与 4 个智能体框架上,我们发现:改进真实存在但不均衡;即使整体收益相同的智能体,其路径证据也差异显著。基于此,我们开发 Hermes+——在智能体循环各阶段加入 5 项针对性干预。Hermes+ 显著提升保留经验带来的平均收益,并提供更清晰的路径证据,其中对“需替换过时状态”的任务改进最强,但效果仍依赖具体能力与模型。 总之,PAST-Bench 与 Hermes+ 共同为研究持久智能体如何从“保留经验”迈向“系统性改进”提供了评测与诊断基础。代码:https://github.com/Gen-Verse/PAST-Bench
论文精读
TL;DR PAST-Bench 基准首次系统测试个人 AI 代理的递归自我改进能力,通过保留经验前后的对照实验量化提升真实但能力不均,并据此构建 Hermes+ 框架增强改进的可靠性。
问题
问题背景
AI 代理正从单轮任务执行迈向长期自主运行,递归自我改进成为关键能力——代理能否利用历史交互数据持续优化行为。个人代理因跨会话天然保留偏好、工具例程,被视为研究该能力的理想载体。
现有方法局限
当前多数自我进化代理框架仅声明具备记忆机制,但存在三个评估盲区:
- 缺乏配对消融对照:未在同一任务序列下严格对比开启/关闭经验保留时的性能差异,无法量化经验本身的净增益。
- 忽视机制归因:即便整体性能提升,也难以判断是否符合“保存—检索—更新”的正确改进路径,抑或仅源于基础模型的零样本泛化。
- 评测场景静态化:常见基准聚焦一次性任务打分,缺失对代理跨会话、长期经验累积过程的连续追踪。
为什么难/重要
实现可信的递归自我改进面临双重挑战:一是经验提取需在保真度与泛化性间取得平衡,错误的知识更新可能引入混乱甚至能力退化;二是弱信号下的因果归因要求将行为变化与特定的记忆操作准确绑定,在复杂的代理管道中极难实现。业界对该问题的关注持续升温,因为若代理无法稳定地从经验中受益,长期运行将变成高成本的随机试错,严重制约其在个性化助手、自动化运维等场景的实际部署。
行业类比
这类似推荐系统声称越用越准,但若不做严格 A/B 测试,就无法区分收益是源于用户画像的积累还是模型结构升级的红利。
核心洞察
- **仅观测任务增益会掩盖代理自我改进的真实路径。** PAST-Bench 不仅测量性能提升,还通过 **机制证据得分 (Mech Score)** 追踪代理是否真正遵循了预期的保存-检索-更新循环。与传统基准只对比有无记忆的最终得分不同,这一诊断层揭示了相同增益可能源于不同内因,例如有的代理靠环境信息巧合而非记忆复用,这种区分对部署可靠的长程代理至关重要。
- **经验复用的瓶颈并非统一,而是高度依存于任务子类型和模型能力。** 实验发现,即使总体自我进化增益相似,不同代理在记忆、程序复用、信息收集、状态更新等子能力上表现迥异。这表明通用的记忆机制无法平等改善所有场景,实际工程需要按任务剖面分层调优,并针对薄弱环节进行定向干预,而非依赖单一记忆框架。
- **Hermes+ 验证了诊断驱动的设计能系统化提升自我改进质量。** 基于 PAST-Bench 的诊断结果,Hermes+ 在代理循环中引入五项定向干预(如强制状态重置验证、程序路由追踪),显著提升了 Update 类型任务的增益,同时提供更清晰的机制证据。这区别于仅靠扩大模型或记忆容量的思路,展示了一条从评估洞察到架构迭代的闭环路径,为构建真正进化的个人代理提供了工程范式。
方法
基准构建:隔离经验保留的因果效应
PAST-Bench 围绕“个人代理能否通过经验实现递归自我改进”设计。每个任务序列包含 26 个场景、204 个 episode,覆盖 记忆(Memory)、程序复用(Procedural)、信息收集(Information Gathering)、状态更新(Update)四类能力。episode 被赋予明确角色(如设立、查询、更新),确保后续评估能追溯改进路径。
评估管线:配对消融与机制证据
核心消融策略:为每个代理运行 有序新会话任务序列,在匹配条件下开关“经验保留”(persistence)。系统采集两类指标:
- 任务得分(Task Score):后期 episode 的绝对性能及相对未保留经验的 自我演化差距(self-evolution gap)。
- 机制证据得分(Mech Score):通过 LLM 评委自动检查真实输出是否遵循 保存 → 检索 → 更新 的预期通路。该分数逐 episode 计算 artifact 质量,再聚合到家族、能力层。
聚合流程为 Episode → Family → Capability → Overall,确保颗粒度诊断。
Hermes+:诊断驱动的框架增强
基于 PAST-Bench 揭示的能力差异,我们在 Hermes 框架上引入 五项针对性干预,覆盖代理循环各阶段(如记忆检索时机、工具调用路由、状态冲突解决)。Hermes+ 的提升在 Update 类任务最显著,但效果仍依赖基座模型与能力类型。
与同类工作差异:不同于仅看最终成绩的交互式评估,PAST-Bench 通过配对消融与机制归因,区分“碰巧高分”与“靠经验真正改进”,为自演化代理提供了可诊断的评估基础。
实验
实验设计
PAST-Bench 构建了 26 个场景、204 集的有序会话任务,覆盖记忆、程序复用、信息收集和状态更新四类能力。每集在新的空白会话中启动,通过配对消融设计控制“保留经验”的开启与关闭,从而隔离出积累经验对后续任务表现的因果效应。评估指标包含 任务得分 和 机制证据得分:前者衡量增益幅度,后者检测增益是否确实源自保存、检索与更新这一预期路径。实验在 7 个基模型(如 GPT-4、Claude 等)与 4 种代理框架(Agent-Zero、ZeroClaw、nanobot、Hermes)上运行。
关键发现
- 保留经验确实能带来真实但能力不均衡的改进:某些能力(如程序复用)获益明显,其他能力则波动较大。
- 相同整体增益的代理,其机制证据得分可能差异巨大,表明仅看最终任务表现会掩盖实现路径的可靠性。
- 基于诊断结果开发的 Hermes+ 在代理循环各阶段引入五项定向干预,使平均增益提升,尤其对需替换过期状态的任务(Update 类型)改进最显著,同时提供更清晰的路径证据。
- 不同基模型与框架的组合对提升幅度影响明显,说明当前递归自改进仍高度依赖底层模型能力。
与基线对比及解读
以 Hermes 为基线,Hermes+ 在多数基模型上保持或提高了整体任务得分,尤其在 Update 能力上拉开差距。然而这种提升并非均匀覆盖所有能力:在 Procedural 任务中,单一诊断干预甚至暴露了机制交互的复杂性(可能导致下降)。这提示从业者:设计自进化代理时,不能仅依赖端到端指标,必须引入机制归因评估,否则容易将表面提升误判为系统进步。PAST-Bench 的配对消融和机制证据双轨评估,为工程上诊断“经验是否被有效利用”提供了低成本、可复现的模板。
行业影响
落地场景:个人代理的记忆与改进能力将成为产品分水岭
PAST-Bench 基准及其衍生的 Hermes+ 框架直指下一代个人 AI 代理的核心瓶颈:跨会话的持续自我改进。应用场景包括:
- 智能客服与虚拟助理:能记住用户历史工单、偏好,并自动更新解决方案,减少重复提问。
- 个性化教育辅导:跟踪学生薄弱点、学习节奏,动态调整教学策略,让每次交互都建立在过往积累之上。
- 健康管理与慢病跟踪:长期记录饮食、运动、用药反馈,逐渐优化健康建议的准确性和依从性。
- 企业知识库助手:从员工多次查询中提炼高频问题,主动更新知识条目,替代静态 FAQ。
此类系统若无法可靠地从经验中学习,其长期价值将大幅缩水;PAST-Bench 首次为衡量这一能力提供了标准化工具。
商业价值:降低长期维护成本,提升用户留存
- 降本:代理具备 Procedural reuse(流程复用) 和 Update(状态更新) 能力后,可自动修正过时规则与配置,减少人工运维与内容运营的投入。
- 增收与体验:记忆型代理能构建更深层的用户画像,驱动精准推荐与主动服务,提高转化率;同时,连贯的对话体验直接拉高用户满意度和留存。
- 差异化壁垒:拥有可验证的自我改进能力的代理产品,更容易在红海市场中建立技术护城河。
与现有工作流的接口:轻量集成,侧重持久层与诊断
Hermes+ 可在主流 LLM 代理框架(如 LangChain、AutoGPT)中以插件形式嵌入:
- 持久化接口:接入向量数据库或键值存储,保存对话摘要、工具调用链、用户反馈等,作为经验积累的源头。
- 更新路由:在代理循环中增加
save、retrieve、update三个诊断节点,利用 Mechanism-Evidence Score(Mech 指标) 监控是否真正走通“学习通路”,而非虚假相关。 - 评估流水线:将 PAST-Bench 的 ablation 条件(开关持久化)植入 CI/CD,对每个版本代理的自我改进能力进行回归测试,确保迭代不会破坏长期学习特性。
具体落地案例
- 电商购物助手:某全球电商平台的导购机器人通过记忆用户尺码、退货原因、浏览序列,在下一个促销季主动推送尺码合适的清仓商品,并自动更新物流偏好。Hermes+ 的机制证据可确保这些改进来自真实的经验整合,而非偶然的模型涌现,从而降低误导推荐带来的客诉。
- 在线教育平台:自适应学习系统记录每位学生的错题模式、专注时段,在后续课程中动态调整难度与教学节奏。使用 PAST-Bench 的 information gathering(信息收集) 家族任务可诊断代理是否有效利用了累计的学情数据,而非每次从头推理,最终实现辅导效果与完课率的同步提升。
局限
- **模型与框架覆盖有限**:实验仅在七种基础模型和四种智能体框架上进行,且全部基于文本交互。虽然覆盖了主流选择,但递归自我改进的表现可能对模型架构、规模及多模态能力敏感,结论的泛化性有待在更广泛的模型族和更复杂的框架(如包含视觉感知的智能体)中验证。此外,PAST-Bench 本身的任务生态尚不丰富,可能遗漏现实场景中重要的经验积累与迁移模式。
- **机制证据诊断依赖 LLM 评判**:PAST-Bench 通过 LLM 判断智能体是否遵循了save–retrieve–update 的理想路径,这一过程不可避免会引入评判偏差和随机噪声。虽然进行了人工验证,但机评的准确性和鲁棒性在长期、多轮交互中仍可能不足,尤其当智能体表现出隐式经验利用时,机评可能低估真正的改进链条。这限制了将改进严格归因于预期机制的可信度。
- **评估局限于短期循环**:基准中的每个智能体仅在固定长度的任务序列上运行,无法考察超长周期或终身学习设定下的递归自我改进效应,例如经验积累的饱和、旧知识遗忘或策略漂移。此外,消融实验通过开关经验保留来度量增益,但对保留经验的质量变化(如污染或过时信息)缺乏细粒度控制,可能掩盖某些退化模式。Hermes+ 的干预虽提升了性能,但其设计与 PAST-Bench 的诊断逻辑高度耦合,向真实部署的迁移尚需独立验证。