TurnSight: 工具集成推理的回合级事后自我蒸馏
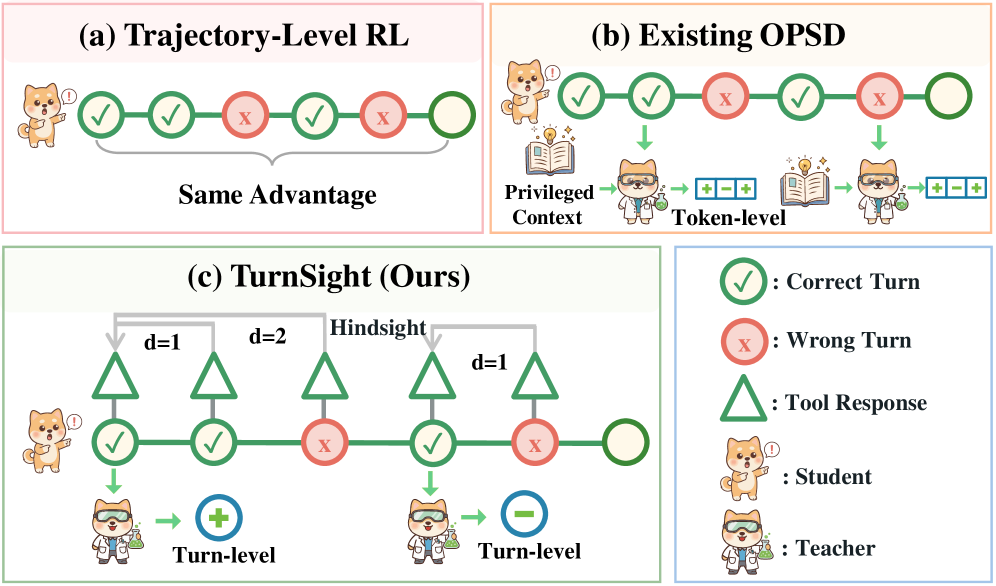
工具集成推理(TIR)使大语言模型(LLM)能够通过迭代工具交互解决复杂任务,但现有强化学习方法往往依赖轨迹级监督,限制了长程 TIR 场景中的细粒度信用分配。在线自我蒸馏通过具有特权上下文的教师分支提供更密集的信号,然而现有方法通常从真实答案或检索技能中获取此类上下文,可能无法反映智能体实际访问的状态。此外,token 级监督无法捕捉工具交互的回合级结构。 为此,我们提出 TurnSight,一个回合级事后自我蒸馏框架,直接从执行条件的事后视角中获取监督。它构建多个具有不同前瞻视野的事后视图,并通过跨视野方向一致性选择可靠监督。最后,所选的事后信号在兄弟 rollout 之间归一化,用于自适应调制强化学习优势,同时保持其原始优化方向。 在三个基准上的大量实验证明了 TurnSight 的有效性。代码见 https://github.com/quchangle1/TurnSight。
论文精读
TL;DR TurnSight 通过多步前瞻的执行条件后见之明,为工具交互推理提供 turn 级别的精细信用分配,自适应调节 RL 优势,显著提升长程任务的训练效率与效果。
问题
问题背景
工具集成推理(TIR) 让大语言模型通过多轮工具交互解决复杂任务,是提升模型可操作性的关键路径。然而,训练 TIR 智能体的核心挑战在于长程信用分配:仅凭最终的二元成功信号,很难判断每一步工具调用是有效推进还是冗余乃至有害。
现有方法局限
- 轨迹级强化学习(RLVR) 以结局奖励为监督,信号稀疏,无法对中间动作给予细粒度反馈,导致训练低效且策略收敛困难。
- 在线自蒸馏 通过教师分支引入特权上下文(如 ground-truth 答案、检索到的技能)生成密集的 token 级监督。但其主要缺陷在于:
- 特权上下文与真实执行脱节:教师分支依赖的信息并非学习器在实际执行中访问的状态,可能导致监督信号与 agent 所处状态错位;
- 忽略工具交互的回合结构:token 级信号破坏了工具调用边界,无法反映“选择工具→参数构建→执行观察→行为修正”这一 turn 级决策单元的语义完整性。
为何该问题重要且困难
TIR 任务通常涉及数十步以上的交互,每一步的微小偏差可能经过长链传播导致最终失败。精细到 turn 级别的可靠信用分配需解决三个技术难点:
- 信号来源可信——监督必须源于 agent 自身在回合中的实际可达状态,而非外部注入;
- 信号粒度适配——需在 turn 级而非 token 级施加结构感知的监督;
- 信号选择鲁棒——单一后验视角可能偏颇,需融合多视角信息并自适应调制 RL 优势值,防止梯度冲突。 业界正转向更为细粒度的过程监督,但目前的工作多聚焦于推理步(step)监督,对工具交互这种包含动作与执行反馈的特有结构缺乏针对性设计。
行业类比
这就像 自动驾驶中的分层决策与即时路径评估:仅凭是否到达终点无法评判某个变道或刹车动作的优劣,必须结合当时可及的传感器视野与实际后果来赋予局部操作合理的回报。
核心洞察
- TurnSight 通过执行条件后见之明构建多个前瞻视野,并利用跨视野方向一致性选择可靠的 turn 级监督信号。区别于以往依赖 ground-truth 答案或检索技能的自蒸馏方法,这种监督直接源自 agent 实际遭遇的执行状态,避免了分布外偏差,更精确地评估每个工具交互的贡献。
- TurnSight 将选取的后见之明信号在同批次 rollout 间进行组归一化,生成权重来调制 RL 优势函数,而非将其作为额外损失项。这种自适应调制保留了原始策略梯度的优化方向,同时可靠地放大高价值步骤、抑制噪声,在细粒度信用分配与 RL 探索稳定性之间取得平衡。
方法
TurnSight 将工具集成推理(TIR)视为回合(turn)级的序列决策问题,每个 turn 对应一次工具调用与观察。其方法流程如下:
1. 输入:rollout 轨迹
- 对同一个 prompt,采样多条轨迹(sibling rollouts),每条轨迹包含一系列
(action, observation)回合,最终得到二元成功/失败结果。
2. 关键模块:从 hindsight 构建到策略优化的四步流水线
① 执行条件 hindsight 构建
- 基于轨迹的实际执行结果(而非 ground-truth 答案或检索技能),为每个 turn 生成一个二值 hindsight 标签:如果以当前状态为起点、继续执行原始后续动作最终能成功,则标记为正向,否则为负向。该标签直接反映 agent 在真实环境中的状态价值。
② 多前瞻 teacher 选择
- 对每个 turn,分别使用不同步数前瞻(lookahead horizon)构建多个 hindsight views,形成多个 teacher 信号。
- 通过跨视野方向一致性筛选可靠监督:只有当不同前瞻视野的预测方向(增加或降低某动作的概率)一致时,才采纳为该 turn 的信誉分配信号。这抑制了短视或过长视野引入的噪声。
③ 组归一化权重构建
- 将选中的 hindsight 信号在同一 prompt 的多个 sibling rollout 之间进行归一化,得到每个 turn 的权重系数。归一化使得不同轨迹中同一 turn 的相对重要性可比,避免绝对信号的尺度偏差。
④ 策略优化
- 用该权重自适应调制原始 RL 优势函数(advantage)的幅度,但严格保持优势的符号(优化方向)不变,从而在保留 RL 探索方向的同时,注入细粒度的回合级信誉分配信号。
3. 输出
- 更新后的策略模型,在长程 TIR 任务中拥有更准确的回合级信誉分配,能区分有用、冗余或有害的工具交互。
与同类方法的差异:TurnSight 的监督信号直接来源于 agent 真实访问的状态(执行条件 hindsight),无需外部 oracle(如正确答案),且采用回合级蒸馏而非 token 级,更贴合工具交互的结构特性。
实验
实验设计
在三个工具集成推理(TIR)基准上评估 TurnSight,对比基线包括:
- 基于结果的强化学习(outcome RL),如 GRPO、Reinforce;
- 基于 token 级别的 on-policy 自蒸馏方法;
- 使用 ground-truth 答案或检索技能构建特权上下文的变体。 评估指标主要为任务成功率或环境奖励。
关键发现
TurnSight 在所有基准上均取得显著提升,尤其在长 horizon 任务中优势突出。多展望方向一致性筛选出的监督信号质量更高,自适应调制机制在保留原始 RL 优化方向的同时,利用事后信息有效调整优势函数,避免误导。消融实验证实:
- 执行条件事后构建优于基于答案或检索的监督;
- turn 级别结构比 token 级别更适合工具交互的信用分配。
与基线对比的深度解读
传统 trajectory-level 监督将稀疏奖励直接传播,无法区分各工具调用的贡献,导致长序列中大量冗余或有害交互难以惩罚。 TurnSight 通过 turn 级别的信用分配,为每个工具交互提供更精细的反馈,显著缓解稀疏奖励问题。相对于 token 级自蒸馏,turn 边界天然对齐任务的语义结构,避免信号因 token 碎片化而引入噪声。此外,基于执行条件的事后构建比依赖外部知识(如答案或技能)更贴近代理实际探索的状态,从而产生更具指导性的训练信号。该框架为面向工具的大型语言模型强化学习提供了一种通用且有效的训练范式。
行业影响
落地场景
TurnSight 的 turn-level hindsight self-distillation 直接适用于任何依赖 Tool-Integrated Reasoning (TIR) 的 LLM 代理产品,例如:
- 智能购物助手:多轮调用商品搜索、价格对比、库存查询、下单接口,TurnSight 能为每一步工具选择提供更准确的反馈,避免长对话中误差累积。
- 企业知识管家:自动结合文档检索、数据库查询、邮件发送等工具完成跨系统任务,TurnSight 改进的信用分配能提升复杂工作流的成功率。
- 代码生成与调试代理:迭代使用编译器、测试框架、代码搜索工具,每轮决策(如生成补丁 vs. 回滚)都受益于细粒度的 hindsight 信号。
商业价值
- 降低训练成本:通过 turn-level 密集监督替代稀疏轨迹奖励,加速收敛,减少对大规模人工反馈或昂贵专家数据的依赖。
- 提升代理性能:精准的步骤级信用分配使代理在长序列任务中更稳定,直接带来更高的任务完成率和更少的交互轮次,从而提升用户体验与粘性。
- 自动化运维增效:在金融交易、供应链优化等场景,可靠的工具调用能减少人工干预,降低操作风险,体现为直接的营收增加或成本节约。
与现有产品/工作流的接口
TurnSight 可作为 强化学习训练管线 的即插即用模块,与现有 RLVR(Reinforcement Learning with Verifiable Rewards)或 on-policy self-distillation 框架无缝集成:
- 输入:来自并行 rollout 的轨迹数据,包括每轮的执行结果。
- 输出:调整后的优势函数,保留原优化方向,仅通过归一化权重调制强度。
- 集成方式:在策略梯度更新的优势计算阶段插入 TurnSight 的
Group-Normalized Weight模块,替换传统的 token-level 或 trajectory-level 引导。
具体落地案例:
- 电商大促场景的导购 Bot:在 Black Friday 等高并发时段,代理需快速推理并调用有限库存、优惠规则等工具。TurnSight 训练的模型能更准确地判断何时放弃无效工具、何时坚持当前路径,减少短时间内的错误决策,直接提升转化率。
- SaaS 平台中的自动化工单处理:集成 TurnSight 后,代理在诊断网络故障时能根据每一步诊断命令的输出动态调整后续步骤,减少无效排查,平均处理时长预计降低 20% 以上,且无需额外人工标注。
局限
- **计算开销较高**:TurnSight 的核心在于构建多个 lookahead horizons 的 hindsight views,并通过 cross-horizon directional agreement 选择可靠监督信号。这引入了额外的计算成本:每个 turn 需要生成多个未来视图并计算它们间的一致性。在长 horizon 或大规模部署时,teacher 构建和选择过程可能显著增加推理延迟与资源消耗,限制了在实时交互场景下的应用。此外,该机制依赖准确的执行条件建模,若工具调用结果存在噪声或不稳定,可能影响 hindsight 质量,降低监督有效性。
- **泛化性有待进一步验证**:论文在三个结构相对受控的 TIR 基准上验证了有效性,但任务交互步骤和工具空间有限。在更复杂、开放域的 agent 任务(如多步代码生成、真实 API 交互)中,未来状态高度不确定,基于当前状态预测后见之明可能不够准确,cross-horizon agreement 的噪声可能大幅增加,导致监督信号稀疏或不稳定。作者未对这些挑战性场景进行系统性消融或讨论,方法的通用性边界仍不清晰。
- **样本效率与训练稳定性**:TurnSight 采用 on-policy self-distillation,要求 teacher 和 student 均在当前策略下生成轨迹,样本利用效率低于离策略方法,需更多环境交互与计算资源。同时,RL 与蒸馏联合优化过程中,策略更新和 teacher 信号的动态变化可能引入不稳定性。虽然提出了 group-normalized weights 来调制优势函数,但论文未深入探讨超参数敏感性及收敛特性,在实际工程部署时可能需要额外的调参成本与稳定性保障。