MatrAIx: 用83亿人格智能体模拟世界
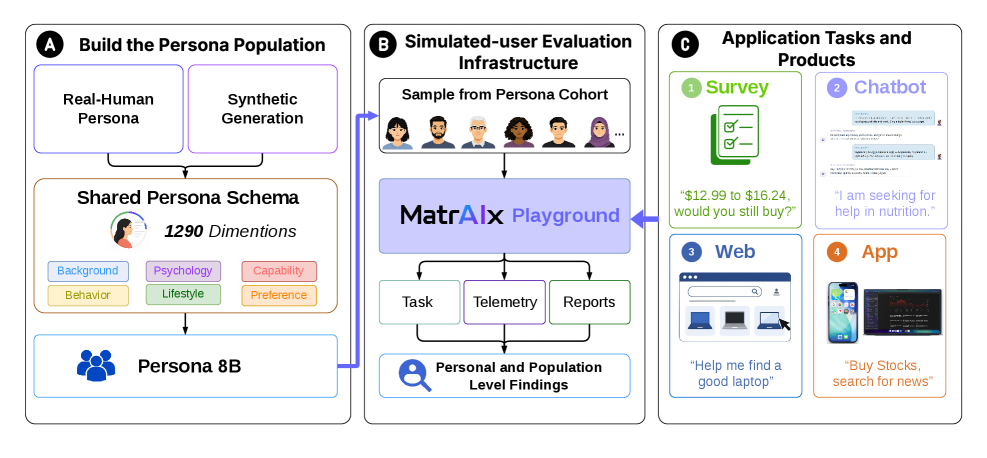
人类对 AI 系统和数字产品的评估成本高昂、速度缓慢且难以规模化。离线评估虽可扩展,但往往忽略了人类多样性和交互行为。为此,我们提出 MatrAIx,一个面向异构用户的大规模模拟用户评估基础设施。 MatrAIx 包含三个核心组件: 1. Persona 8B:包含 83 亿条人格记录,由 1290 个分类维度表示。记录或从保留相关属性的依赖图采样,或源自人类撰写的画像。我们发布约 100 万条质量过滤的核心子集,包括 599,847 条人类真实记录和 400,000 条合成记录。 2. MatrAIx Playground:提供四个评估环境——Survey、AI Chatbot、Web 和 App,供多样化用户评估和交互。 3. 应用任务:提供 1010 个跨 25 个领域的任务,涵盖电商、软件、金融和医疗等。 我们基于三个 LLM(Claude Opus 4.8、GPT 5.5、Claude Haiku 4.5)驱动人格智能体,在 8 个代表性任务上开展了 18,189 次评估试验。反馈捕捉了不同人格背景下的决策与偏好差异,例如价格上调后的犹豫、AI 助手失败后的继续意愿及延迟容忍度等。 验证方面,一项 400 次受控试验评估了十种行为属性的人格遵从度,91.5% 的试验中声明行为被正确表达或抑制。此外,人与 LLM 法官评估了人类真实人格的提取质量。总体而言,MatrAIx 为使用多样化模拟用户评估 AI 系统和数字产品提供了端到端基础设施。
论文精读
TL;DR MatrAIx 用 83 亿人物角色构建大规模模拟评估基础设施,让 AI 系统与数字产品能通过异构用户仿真获得低成本、可扩展的反馈,并公开 100 万核心集及多环境任务集。
问题
问题背景
AI 系统和数字产品的人工评估成本高昂、周期长且难以规模化,而线上 A/B 测试又存在用户流失风险和伦理约束。行业亟需一种既能反映真实用户多样性,又能快速迭代的大规模评估手段。
现有方法局限
- 离线评估(如固定测试集、合成用户)通常将用户视为同质群体,抽象掉关键的人口统计学差异和交互行为,导致评估结果无法体现不同背景用户的偏好分化(例如:价格上涨后的犹豫程度、AI 助手失败后的继续意愿、延迟容忍度)。
- 用户模拟(user simulation)现有工作要么依赖小规模专家规则,要么缺乏与真实世界属性分布的校准,难以覆盖全球人口尺度的异构用户画像。
- 缺少将人口级人格库、多环境交互和应用任务评测统一在一起的端到端基础设施,使得产品团队在发布前无法系统性地探测多样性用户对系统的反应。
为什么这个问题重要且困难
- 技术挑战:构建 83 亿人格需要在保持属性相关性(如收入与消费习惯的依赖)的同时,合成高质量记录并去重;还要设计通用的环境接口(问卷、聊天、Web、App),使同一人格代理能跨环境一致地表达行为。验证模拟真实性(91.5% 的行为符合性)和提取质量本身也是一项杂工作。
- 业界关注:金融、医疗、电商等领域的产品微调可能对特定用户群造成负面体验,大规模预发布评估能提前暴露风险并指导迭代,但迄今缺乏可靠基础设施。
工作相当于“用合成人口做产品压力测试”,类似自动驾驶用仿真场景测试安全,但聚焦于数字产品的用户多样性影响。
核心洞察
- **将人口统计依赖图引入人物画像生成**:MatrAIx 通过 DAG 采样保证 1,290 维分类属性的相关性,而非独立抽样,使生成的 83 亿画像能反映现实世界中年龄、收入、职业等属性的联合分布规律。相比现有工作多使用独立维度或少量模板,这一方法显著提升了合成用户群体的统计保真度,让大规模模拟评估的结论更可信。
- **模拟用户评估覆盖全流程交互闭环**:MatrAIx 不仅提供了画像数据集,还集成了 Survey、Chatbot、Web、App 四种环境与 1,010 个应用任务,使同一个画像主体可在不同数字产品中完成连续、多轮的交互评估。这与多数仅关注单次对话或孤立任务模拟的工作不同,它为观察用户跨场景的行为一致性与偏好迁移提供了可能。
方法
MatrAIx 构建了一个端到端的模拟用户评估基础设施,旨在为 AI 系统与数字产品提供群体规模的异构用户测试。其工作流可概括为:输入任务与产品环境 → 基于 Persona 8B 实例化智能体 → 在 Playground 中执行交互并收集反馈 → 输出行为偏好与产品级指标。
输入与任务定义
系统接受待评估的 数字产品(如 Survey、AI Chatbot、Web、App 四种环境)以及 应用任务规格(来自包含 1010 个任务的库,覆盖 Commerce、Software、Finance、Healthcare 等 25+ 领域)。任务通过声明式契约指定交互流程、评估指标与队列选择策略。
核心组件:Persona 8B 与 Playground
- Persona 8B 数据集:包含 83 亿个由 1290 个分类维度表示的人格记录。合成生成采用 DAG 采样来保持属性间的相关性;真实人格则通过人类撰写档案和志愿者收集提取。公开的 1M coreset 经过质量过滤与分布校准,包含 599,847 个真实背景人格和 400,000 个合成人格。
- MatrAIx Playground:提供四种交互环境,每个环境可接入不同 LLM 后端(实验中使用了 Claude Opus 4.8、GPT-5.5、Claude Haiku 4.5)。
执行流程
- 从 Persona 8B 按任务需求采样一个 队列(cohort) 人格。
- 使用 LLM 为每个人格实例化一个 智能体,该智能体会根据人格属性产生一致的决策、言语与情感反应。
- 在指定 Playground 环境中执行 试次(trial),智能体与产品交互,系统记录遥测数据,包括操作序列、延迟容忍度、犹豫行为等。
- 试次结束后,通过验证契约生成结构化报告,输出产品级指标(如 price sensitivity、conversion rate)和人格级偏好差异。
输出与验证
输出为群体行为分布与产品反馈,例如价格增长后的犹豫率、AI 助手失败后的继续意愿、不同延迟下的放弃率等。两项验证研究确认了有效性:(1) 400 次试次的控制实验显示,91.5% 的试次中智能体成功表达了目标行为属性或正确抑制了无关行为;(2) 人类与 LLM 裁判对真实人格的提取质量进行了评估。
与同类方法的差异
不同于仅聚焦对话模拟或有限画像的评估工具,MatrAIx 提供了首个从 群体规模的人格数据集 到多环境端到端评估基础设施的完整系统,并开源了高质量核心集。
实验
实验设计
MatrAIx 的验证围绕两个核心实验展开。首先,在 18,189 次评估试验中,由三种 LLM(Claude Opus 4.8、GPT 5.5、Claude Haiku 4.5)驱动的 persona agents 在四个环境(Survey、AI Chatbot、Web、App)里执行了 8 个代表性任务(覆盖商业、软件、金融等领域)。随后,进行了一项 400 次对照试验,测试 10 个行为属性(如价格敏感度、延迟容忍度)在不同环境下的 persona adherence;同时,由人类和 LLM 评委对从真实人物提取的 persona 进行质量评分,以评估抽取保真度。
关键发现
Adherence 试验中,91.5% 的实例准确表达或抑制了指定行为,证明 persona agents 能忠实反映预设特征。跨模型和 persona 背景的比较显示,行为偏好呈现显著差异:价格上涨后出现犹豫、AI 助手失败后继续使用的意愿变化、以及对响应延迟的不同容忍度,均被成功捕获。提取质量评估进一步表明,基于真实人物的 persona 与人工基准高度一致。整体上,MatrAIx 实现了对异构用户的端到端模拟,为数字产品评估提供了可扩展的基础设施。
与基线对比解读
传统离线评估通常依赖均匀用户模型或抽象指标,无法体现人口多样性。MatrAIx 通过 83 亿规模的 persona 数据集和多环境、多任务支持,显著超越了以往小规模、单任务的用户模拟系统。其贡献在于将大规模、高保真 persona agents 与严格的行为一致性验证相结合,确保模拟结果的可信度。这为工程实践提供了一种低成本、快速迭代的替代方案,能够在不依赖真实用户的情况下,提前发现产品对不同用户群体的潜在影响。
行业影响
落地场景
MatrAIx 的核心资产是 Persona 8B 人口级用户画像库与模拟评估基础设施,可广泛应用于需要异构用户反馈的 AI 产品测试:
- 对话 AI:用成千上万不同背景的虚拟用户评估聊天机器人、语音助手,覆盖故障恢复、延迟容忍等长尾场景。
- 推荐与搜索:模拟不同偏好和行为的用户群体,量化排序策略的公平性与偏好满足度。
- 价格与订阅:测试动态定价、促销敏感度,捕捉"涨价后犹豫"等真实行为模式。
商业价值
- 降本:传统人类评估成本高、周期长,MatrAIx 将单次实验成本压缩至 API 调用级别,可高频迭代。
- 增收:通过异质化用户模拟,在产品上线前发现转化瓶颈,优化支付流程、推荐逻辑,直接提升留存与付费率。
- 体验提升:覆盖传统 A/B 测试中难以观测的少数群体,减少线上事故和偏见,增强产品包容性。
与现有产品/工作流的接口
- CI/CD 集成:将 MatrAIx Playground 的 Survey、Chatbot、Web、App 环境作为离线评估关卡,通过 SDK 触发大规模模拟,生成结构化报告。
- 数据栈对接:输出的
trial级反馈(如选择、犹豫时长)可直接汇入现有日志平台(如 Databricks、BigQuery),与线上指标关联分析。 - 模型评估扩展:替换传统静态 benchmark,将应用任务(如
meal_planning)封装为 LLM-as-a-Judge 评测的一环,评估模型遵循用户画像的能力。
具体落地 Use Case
- 电商价格敏感度测试:在上线新定价策略前,从 Persona 8B 中抽样不同收入、购物习惯的用户,通过 MatrAIx Web 环境模拟购物决策,测量加价后的犹豫时长与弃购率,辅助定价优化。
- AI 客服失效恢复评估:针对 AI Chatbot 环境,注入故意失败的对话回合,观察虚拟用户是否继续提问或选择转人工,量化助手失效对用户耐心的影响,为灰度发布提供安全阈值。
局限
- **角色代理的逼真度受 LLM 限制**:文中角色行为由 Claude Opus 4.8、GPT 5.5 等 LLM 驱动,这些模型可能存在系统性偏见或与真实人类决策分布不一致。论文仅进行了 91.5% 的行为遵循率验证,但没有与大规模人类参照组对比,模拟结果的生态效度仍存疑。
- **角色覆盖的深度与静态性**:Persona 8B 使用 1,290 个分类维度刻画角色,虽规模庞大,但离散类别难以捕捉人类性格的连续性和动态演化(如情绪、知识更新),且合成角色可能放大生成过程的伪相关,影响对真实人群的推断。
- **评估环境简化现实复杂度**:仅覆盖 Survey、Chatbot、Web、App 四种环境,缺少视觉、语音、物理交互等多模态通道,亦未模拟社交网络影响与长期记忆等现实因素,限制了在高保真产品测试中的直接迁移性。