OneDayAgent:面向自主体的长时程驾驭框架
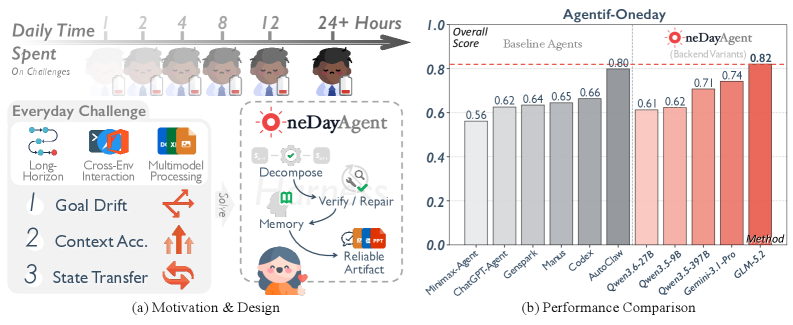
大语言模型(LLM)智能体正日益被用于处理覆盖工作、学习和生活的开放式日常请求。此类任务具有长时程、跨环境和多模态特性,迫使智能体在众多步骤中保持目标与约束,同时驾驭异构工具与附件。已有工作分别针对目标漂移、状态丢失、上下文溢出等失败模式进行了研究,但单一管控框架能否联合处理这些挑战并在不同后端上保持有效,尚缺乏系统研究。 为此,我们提出 OneDayAgent——一个面向自主体的长时程管控框架。OneDayAgent 将开放式请求转化为受管理的执行流程:将任务分解为有界子任务、在上下文压力下维护执行记忆,并对最终交付物进行验证与修复。 我们在 AgentIF-OneDay 基准的 104 个任务上评估了 OneDayAgent。使用 GLM-5.2 作为后端时,OneDayAgent 取得了 0.821 的总体得分,刷新了当前最佳(SOTA)。同一框架在来自三个模型家族的五个后端 LLM 上运行均表现稳定,表明其无需调参即可跨后端泛化,尽管不同模型在同一工作流下会呈现出各异的执行风格。
论文精读
TL;DR OneDayAgent 是一个长时程执行框架,通过任务分解、执行记忆与全局验证修复,统一解决目标漂移、状态丢失和上下文溢出问题,在 AgentIF-OneDay 基准上以 GLM-5.2 后端取得 SOTA,且无需调优即可跨多种大模型后端泛化。
问题
随着大语言模型(LLM)智能体被部署到工作、学习、生活等开放式日常任务中,其面临的请求日益呈现 长周期(long-horizon)、跨环境(cross-environment)和多模态(multimodal)特征。这类任务要求智能体在众多步骤中持续保持目标与约束,同时驾驭异构工具与附件,避免任务漂移、状态丢失或上下文溢出。
现有研究大多聚焦单一失败模式:例如通过显式目标跟踪缓解 目标漂移,利用外部存储应对 状态丢失,或采用压缩技术防止 上下文溢出。然而,这些方法各自为政,缺乏一个统一的 执行框架(harness) 来同时管理这些失败模式,并且很少验证其在不同后端 LLM 上的泛化性。当任务链路拉长、环境切换频繁时,孤立的对策难以协同,往往导致中间步骤失败或最终交付物质量不达标。
这一问题的技术挑战在于:长周期任务天然存在 指数级分支与累积误差,如何在有限的上下文窗口内维护跨步骤的 执行记忆,并在任务完成时进行 全局校验与修复,是当前智能体系统的核心瓶颈。业界对能够自主完成复杂日常任务(如市场调研、报告撰写)的智能体需求迫切,但现有系统在可靠性与泛化性上仍存在明显短板,尤其当后端模型切换时表现不稳定。
类比于自动驾驶需要可靠的长期规划与执行监控,AI 智能体在开放域任务中也亟需一套类似操作系统级的 任务调度、状态管理与交付校验机制,这也是当前研究亟需填补的空白。
核心洞察
- OneDayAgent 通过统一 harness 设计,将开放请求结构化分解为有界子任务,并内嵌执行记忆与全局验证修复,联合应对长周期任务中的目标漂移、上下文过载和状态丢失三大失败模式。与以往仅针对单一问题(如单独做 memory 或规划)的工作不同,这种集成式管理更贴近真实跨环境、多模态日常请求,显著提升了 agent 在长时间运行中的目标一致性与交付物质量。
- 该 harness 无需任何调优即可泛化到 5 种后端 LLM(涉及 3 个模型家族),且不同模型在相同工作流下展现出迥异的执行风格。这表明精心设计的任务分解、记忆管理与验证策略可作为独立于模型能力的“代理流程层”,降低对特定基座模型的依赖,为实际部署中快速切换或升级后端模型提供了重要参考。
方法
输入与整体流程
用户提交一个开放式日常请求(可能包含文本、附件及多模态元素),要求跨越多个工具与环境(如网页搜索、本地文件编辑)生成最终交付物(如报告或演示文稿)。OneDayAgent 将该请求转化为一种受控执行过程,保证长程任务中的目标一致性和状态完整性。
关键模块
任务分解 (Task Decomposition)
将长程请求自动拆分为一系列有界子任务,每个子任务有清晰的目标、输入/输出规范和可执行步骤。分解基于请求的语义结构和可用工具,有效防止目标漂移,并让执行控制在可管理的粒度内。执行记忆 (Execution Memory)
在受上下文窗口限制的条件下,维护跨子任务的执行历史与关键状态。通过摘要、选择性保留或分层存储等机制,将长期上下文压缩为紧凑表示,在需要时注入当前子任务的 prompt 中,从而避免状态丢失和上下文溢出。全局验证与修复 (Global Verification and Repair)
所有子任务完成后,对最终交付物进行全局校验,检查其是否满足初始约束、任务目标和质量标准。若发现缺陷,触发修复流程,重规划或调用相关子任务进行修正,直至输出合格。工具与环境接口 (Tool and Environment Interface)
提供统一的抽象层,将异构工具(搜索引擎、代码执行器、文件编辑器等)封装为标准接口。负责工具选择、参数填充、结果解析和错误处理,使上层执行循环无需感知底层差异。
输出与交付
子任务执行中产生的中间结果被逐步组装,经全局验证后输出最终交付物。整个过程的轨迹和关键决策记录在执行记忆中,可供审计或调试。
差异点:OneDayAgent 首次在单一 harness 中联合应对目标漂移、状态丢失和上下文溢出三种长期 agent 失效模式,且同一套 workflow 在多个后端 LLM 上无需调优即可通用,实现了 harness 与底层模型的解耦。
实验
实验设计
评估在 AgentIF-OneDay 基准上进行,包含 104 个长程、跨环境、多模态任务,覆盖工作、学习与生活场景。任务要求智能体在多个步骤中保持目标与约束,同时处理异构工具和附件。
关键发现
以 GLM-5.2 为后端时,OneDayAgent 取得 0.821 的整体分数,刷新记录。同一 harness 在 5 个来自 3 个模型家族的 LLM 后端上运行,未做任何微调即表现出泛化能力,但不同模型在相同工作流下展现出不同的执行风格。
基线对比解读
此前工作多聚焦单一失败模式(目标漂移、状态丢失、上下文溢出),而 OneDayAgent 作为一个统一 harness,能够同时管理这些挑战并跨后端保持有效。与基线相比,它通过任务分解为有界子任务、上下文压力下的执行记忆以及最终交付物的验证与修复,实现了长程任务的稳定自治,避免了对特定模型的依赖。
行业影响
工业落地前瞻
OneDayAgent 提供了一套可跨后端 LLM 通用运行的长程代理控制框架,为解决开放式、跨环境、多步骤的日常任务提供了工程化基础。
落地场景
- 个人效率与办公自动化:处理“收集资料 + 编辑文档 + 生成汇报”这类组合请求,如自动生成市场分析报告、竞品调研 PPT。
- 内容生产与运营:面向内容平台的跨模态任务,例如依据多条新闻链接生成视频脚本并自动剪辑、发布。
- 企业工作流自动化:IT 运维、客服、合规审计等场景中,将分散的查询、文件操作、第三方 API 调用串联成一个可验证的交付流程。
- 电商与供应链:自动完成商品信息跨平台同步、评论分析、库存预警与采购建议单生成。
商业价值
- 降低人力成本:将原本需要多人协作的长流程任务压缩为单个代理自动执行,减少重复性人工投入。
- 提升任务可靠性与体验:内置的全局验证与修复机制减少目标漂移和状态丢失,交付质量更稳定,用户等待时间缩短。
- 灵活的后端选型:同一套 harness 无需调参即可在不同 LLM 间迁移,企业可根据成本/性能自由切换底层模型,避免供应商锁定。
与现有产品/工作流的接口
OneDayAgent 不绑定特定框架,可作为 Agent 中间件 集成到现有技术栈:
- 通过标准化工具接口接入已有的 API 网关、RPA 工具或内部微服务。
- 可嵌入 LangChain、AutoGPT 等编排层,作为长程任务的执行策略增强模块,替换原有的线性循环。
- 采用无状态的服务化部署,与任务队列系统(如 Celery、Kafka)配合,处理异步批量的代理请求。
典型用例
- 电商运营自动化:运营人员提交“分析本周爆款商品,结合用户评论生成优化方案,并输出为 Google Slides”的指令。代理自动拆解为搜索竞品、提取评论情感、总结趋势、调用 Slides API 生成幻灯片,最后校验幻灯片是否包含所有必要章节,修复缺失图例。
- 金融研报自动生成:分析师输入公司名称和报告模板,代理跨数据源采集财务数据、新闻舆情,生成包含图表的结构化 PDF,并自动检查数据一致性、补充遗漏的免责声明。
原作者论断:同一 harness 可在不同模型下运行并呈现不同执行风格,意味着企业在升级模型时无需重新开发代理逻辑,大幅降低长期维护成本。
局限
- - **验证与修复模块依赖 LLM 内省**:OneDayAgent 的全局验证和修复机制完全建立在后端 LLM 的自我判断能力之上,缺乏结构化的外部验证器(如基于符号规则或知识图谱的检查器)。当面对需要领域专业知识或精确约束(如排版规范、数值容差)的交付物时,LLM 的自我检错可能产生幻觉或误判,导致修复步骤引入新错误。论文未探讨引入外部校验工具(如模板匹配、编译器或数据库查询)的可能性,这在实际工程中有重要价值。
- - **执行记忆的有损压缩可能引入累积风险**:系统在面对上下文压力时采用有损压缩维护执行记忆,但在超长任务(数百步)下,压缩策略的保真度退化未得到量化。论文未报告记忆压缩带来的信息损失如何影响后续子任务的决策质量,也未对比不同压缩粒度的效果。从工程实践看,渐进式的信息丢失可能导致长任务尾部出现目标漂移,但这未被基准测试充分捕捉。
- - **基准 AgentIF-OneDay 的任务多样性与规模有限**:实验仅在 104 个日常任务上进行,虽然覆盖了跨环境要求,但任务类型仍偏向个人助理场景,未包含企业级自动化、安全关键决策或需要精密工具链(如硬件控制、金融交易)的任务。此外,基准规模较小,可能无法稳定区分不同后端模型的能力差异,跨后端泛化的结论仅基于 5 个 LLM,其外部有效性有待更大规模验证。