DataSpace: 面向异构工作空间的可验证分析的数据代理基准
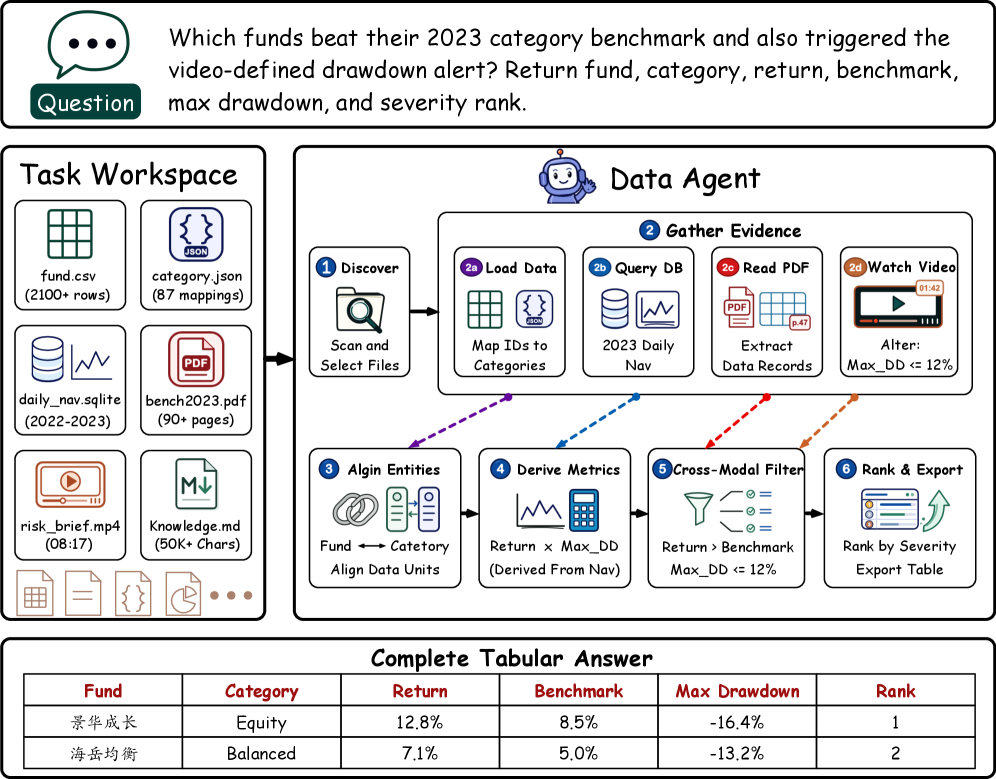
数据代理使自然语言分析成为可能,但相关证据常分散在数据库、结构化文件、长文档和多媒体中。现有基准大多孤立地处理结构化查询、检索或开放式分析,未能统一异构证据发现、完整表格输出和确定性评估。 我们提出 DataSpace,一个数据代理从任务局部异构工作空间中生成可验证表格结果的基准。它包含 410 个跨语言任务和 7,439 个工件,总计 15.01 GB,涵盖 CSV、JSON、SQLite、Markdown、PDF 和视频。DataSpace 还作为 KDD Cup 2026 复杂数据分析数据代理竞赛的官方评估基准。每个代理仅接收问题和工作空间,并返回完整请求的表格结果。我们使用 DataSpace-Builder 构建该基准,这是一个执行落地框架,包含跨语言转换、约束感知关系采样、模态路由和工件渲染,以及 11 位领域专家的人工审查和任务修复。 确定性评估器执行头部不变的列对齐、类型和精度感知归一化,以及顺序感知行比较。在六个近期发布的前沿多模态模型和五个广泛使用的代理框架中,最佳准确率达到 66.34%,而框架选择在固定主干模型下可造成 15.36 个百分点的差异。多模态证据整合和连接一致地降低了所有六个主干模型的准确率。 这些结果表明 DataSpace 尚未饱和,并明确了提高数据代理可靠性的关键挑战。
论文精读
TL;DR DataSpace 是一个基准测试,评估数据代理在异构工作空间中生成可验证表格结果的能力,揭示了多模态证据融合与连接操作对准确率的显著影响。
问题
问题背景
基于自然语言的数据分析正从单数据源转向跨异构工作空间的证据发现。企业环境中,关键信息可能散布在数据库、文件、文档和多媒体中,这就需要能够统一处理 结构化查询、检索 和开放式分析 的 Data Agent。
现有方法局限
现有基准存在明显的技术割裂:
- SPIDER、BIRD 等仅评估结构化 SQL 查询,忽略非结构化数据。
- NQ、HotpotQA 等聚焦文本检索,未要求生成完整表格输出。
- DS-1000、OpenAI Eval 等多针对单轮代码生成,缺乏对多模态证据链的验证。
这些基准无法反映真实场景中 异构证据发现 与 确定性评估 的结合需求,且评价方式过于简化(如单字段匹配),难以衡量 可验证的表格结果 是否完备。
为什么这个问题难/重要
构建统一的数据分析基准面临三重挑战:
- 数据异构性:CSV、JSON、SQLite、Markdown、PDF、视频 等不同格式的语义对齐与推理难度大,模型需要跨模态联接证据。
- 输出确定性:最终答案必须是完整的表格,且与预期结果在列对齐、类型精度、行顺序上完全一致,这对 Agent 的规划与工具使用 提出极高要求。
- 评估严谨性:需要设计能容忍列名变化但保持语义一致的确定性 evaluator,避免基于文本相似度的模糊评分。
KDD Cup 2026 已将其作为官方赛道(Data Agents for Complex Data Analysis),足见业界对 可验证数据分析代理 的高关注度。
行业类比:就像自动驾驶需要统一仿真环境来测试感知-决策-控制全栈,数据分析领域也亟需一个整合多模态、多操作且可复现评估的 DataSpace,才能真正推动 Data Agent 落地。
核心洞察
- **DataSpace 首次将异构多模态证据发现与完整表格输出的确定性评估统一起来,弥补了现有基准仅聚焦单一能力的局限。** 现有工作如 Spider 侧重 SQL 生成,DROP 侧重数值推理,MMLU 等仅测试端到端问答,均无法评估代理在真实企业工作空间中结合数据库、文档、视频等多模态信息生成可验证表格的能力。DataSpace 通过执行基础的构建流程和表头不变且顺序感知的匹配,提供了可复现的严格评测,更贴近产业级数据分析场景。
- **在相同模型骨干下,代理框架的选择造成 15.36 准确率点的巨大差异,揭示了 Agent Harness 设计是决定端到端性能的关键变量。** 这挑战了仅关注模型尺寸或微调的传统优化路径,表明工具调用策略、规划模块、记忆管理及多步交互等框架组件对处理复杂异构分析任务至关重要。该发现为工业界在选型或自研代理系统时提供了量化依据,提示应将框架工程提升至与模型选型同等重要的地位。
- **多模态证据融合与关系连接操作是所有前沿模型的一致弱点,即使最佳系统准确率也仅 66.34%,基准远未饱和。** 视频、PDF 等非结构化数据与结构化表的联合推理导致准确率大幅下降,暴露当前多模态模型在跨模态对齐和复杂推理上的不足。这为下一代模型指明了改进重心,也警示实际部署中应审慎设计人机回路,避免对复杂异构分析任务的过度自动化依赖。
方法
DataSpace 基准的构建方法围绕 DataSpace-Builder 框架展开,遵循“自然语言问题 + 异构工作区 → 规范化任务 → 可验证表格答案”的流水线。输入为用户的自然语言分析问题及包含 CSV、JSON、SQLite、Markdown、PDF、视频等模态的原始数据。框架通过四个关键模块将原始资源转化为标准化的评测样本:
- 跨语言转换 (Cross-Language Transformation):将不同来源的数据库查询、脚本等统一转换为 SQL 中间表示,保持语义不变的同时消除语言差异,确保后续执行的一致性。
- 约束感知的关系抽样 (Constraint-Aware Relational Sampling):在保持主外键约束和值分布的前提下,从真实数据中抽取子集,生成规模可控但关系完整的工作区,避免数据泄露并控制任务难度。
- 模态路由与工件渲染 (Modality Routing & Artifact Rendering):依据问题需求决定证据呈现的模态,将结构化表格渲染为 PDF 文档或嵌入视频帧,同时生成伪文档中的自然语言文本,模拟真实组织中的信息碎片化。
- 人工审核与任务修复 (Human Review & Task Repair):由 11 名领域专家对自动生成的任务进行两阶段盲审,修正事实错误、模糊指令或不可执行的步骤,确保每个任务有唯一且可验证的表格答案。
最终输出 410 个跨语言、跨模态的任务,每个任务包含一个工作区快照和一个隐藏的标准答案表格。评估时采用 确定性评估器,通过标题无关的列对齐、基于类型和精度的值规范化,以及顺序感知的行匹配,严格对比代理生成的表格与标准答案,实现完全可复现的评测。
与 Spider、WikiSQL 等仅关注结构化查询或检索的基准不同,DataSpace 首次在统一的框架下要求代理自主发现异构证据、生成完整表格输出,并通过确定性评估协议量化跨模态推理与表格精度的可靠性差距。
实验
实验设计
DataSpace 基准包含 410 个跨语言任务 与 7,439 个数据工件(CSV, JSON, SQLite, Markdown, PDF, 视频),总大小 15.01 GB。每个任务要求 agent 从异构工作区中提取证据并输出完整的表格结果。评估采用 确定性评测器,通过 列对齐、类型与精度感知的规范化、顺序感知的行比较 来判定正确性。实验覆盖 6 个前沿多模态模型(如 GPT-4o、Gemini 等)与 5 种常用 agent harness(如 LangChain、AutoGen 等),彻底比较不同 backbone 与 harness 组合的性能。
关键发现
- 基准远未饱和:最优模型准确率仅 66.34%,表明异构数据分析仍极具挑战。
- Harness 选择影响巨大:固定 backbone 时,不同 harness 间准确率差距可达 15.36 个百分点,凸显 agent 架构工程的重要性。
- 多模态与 join 是瓶颈:在任何 backbone 上,多模态证据集成 与 关系型连接(join)操作 均会一致地降低准确率,暴露当前模型在跨模态对齐与推理上的短板。
- 效率差异显著:不同 backbone 的推理耗时与 token 消耗差异明显(详见正文),成本-效果权衡是实际部署的关键考虑。
对比与启示
DataSpace 不同于此前只孤立测试检索或 SQL 的基准,它 统一了异构证据发现、完整表格生成和确定性评估。与仅关注单一模态或简单问答的工作相比,该基准更贴近企业数据分析的复杂现实。实验结果表明,单纯提升模型能力不足以保证可靠的结果——agent 架构的设计(工具调用、规划、记忆)对最终表现有决定性影响。同时,多模态融合和复杂分析操作仍然是所有模型的共同弱点,这意味着工程实践中需要引入更稳健的 模态路由、证据对齐 和 增量验证 等机制,才有望将数据代理推向生产级可靠性。
行业影响
落地场景
DataSpace 模拟的异构工作区(CSV、JSON、SQLite、Markdown、PDF、视频)直接映射企业真实数据环境。它可驱动下一代自然语言分析产品,例如:金融尽调中自动从 PDF 年报、SQL 数据库、会议视频抽取指标并生成结构化表格;电商运营跨店铺数据库、产品描述 PDF 和推广视频快速产出竞品报告。此类产品降低非技术用户的取数门槛,让领域专家通过提问直接获得可验证答案。
商业价值
此类 agent 能大幅减少数据工程师在清洗、整合与验证上的重复工作。66.34% 的当前最佳准确率虽需人工复核,但已能在简单任务中替代初级分析员,实现降本;更关键的是将数天的取数流程压缩至分钟级,直接提升业务敏捷性。对软件厂商,DataSpace 作为 KDD Cup 2026 官方基准,提供可复现的评测框架,加速数据代理产品的迭代与差异化竞争。
与现有产品/工作流的接口
DataSpace 的确定性评估协议可无缝嵌入现有数据栈。结构化数据(CSV/JSON/SQLite)通过连接器对接 Databricks 或 Snowflake;非结构化数据(PDF/视频)经 Azure Document Intelligence 或视频理解 API 预处理后输入 agent。AutoGen、LangGraph 等 agent harness 可直接将 DataSpace 任务作为验证集,评估不同 backbone 与编排策略的组合。内置的 header-invariant column alignment 与类型感知比较器可用于持续监测生产环境准确率。
具体用例
- 金融投研助手:从彭博终端导出的 SQL 数据库、PDF 年报、行业分析视频中,自动回答“对比过去三季各科技巨头的研发支出与营收增速”,生成可审计表格。DataSpace 的约束感知采样与人工审核保证答案可追溯。
- 电商全渠道库存分析:跨 ERP 系统的 SQL、各地仓库的 CSV 库存文件、产品说明书 PDF,回答“哪些 SKU 的跨区库存周转天数 > 30 天”,生成预警表。多模态整合与 join 操作正是 DataSpace 揭示的模型短板,促进行业针对性优化。
局限
- **任务规模与生态覆盖仍有限**:尽管 DataSpace 包含 410 个任务和 15 GB 数据,但任务主要围绕表格结果生成,且异构工作空间限定于 CSV、JSON、SQLite、Markdown、PDF 和视频六种模式,未涵盖图像、音频、实时流数据等企业常见源。真实数据分析常涉及更模糊的自然语言指令与部分正确答案,而基准的确定性精确匹配评估可能低估代理的实际效用。与 WikiTableQuestions、Spider 等结构化查询基准相比,DataSpace 在多模态融合上更进一步,但任务多样性仍受限于人工给定的 schema 与证据分布,无法完全模拟动态、开放的探索式分析场景。
- **构建流程依赖大模型与人工审查,存在系统性偏差风险**:DataSpace-Builder 利用 GPT-4 等模型进行跨语言转换、文档渲染与视频生成,虽经 11 位领域专家两轮审核与修复,但初始问答对与工件仍由模型生成,可能继承预训练数据的偏差或产生看似合理但逻辑有误的样本。与基于真实企业数据采集的基准(如 BIRD)相比,模拟构造的数据在难度分布、噪声模式上可能偏离实际,导致排行榜过拟合。此外,跨语言转换虽通过等价性验证,但复杂 SQL 与 Python 的语义保持仍有边界情况,可能引入隐藏的错误源头。
- **代理评测的敏感性与可解释性不足**:实验显示代理框架选择造成最高 15.36 个百分点的准确率差异,却未深入分析框架组件(如规划、记忆、工具调用顺序)对性能的具体影响,仅给出总体消融。错误分析停留在宏观连接、多模态证据类别,缺乏对规划失败、幻觉、检索错误等细粒度根因的量化。这使得从业者难以从中提取可靠的架构设计原则。对比表格理解与代码生成的专项基准(如 TableQA、BIRD),DataSpace 更强调端到端可验证性,但在诊断代理弱点方面提供的信号较弱,可能降低其在学术与工程中的长期参考价值。