多任务多帧视觉钢琴转录
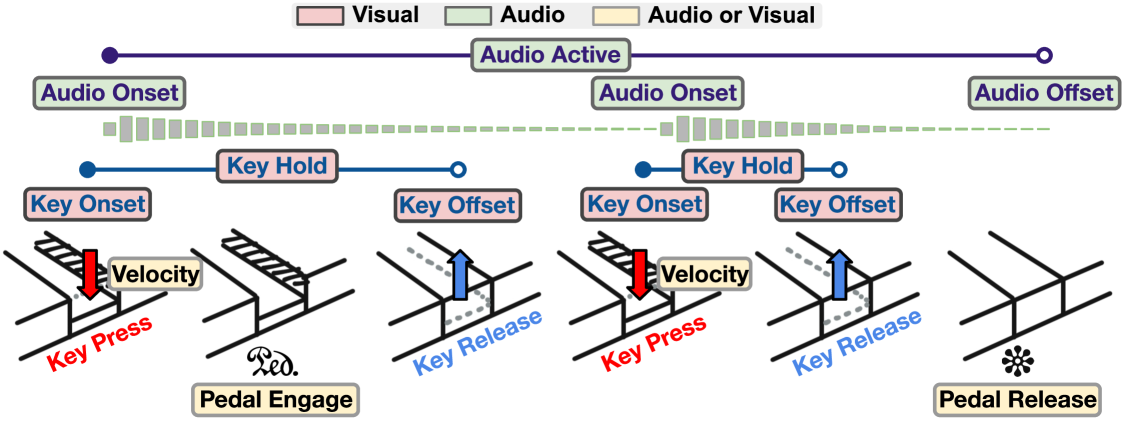
基于音频的钢琴转录在起始(onset)、音高和力度上表现良好,但延音踏板使声音在琴键释放后持续很久,因此音频系统预测的是踏板延长的偏移,而非物理琴键释放。然而,现有的视觉钢琴转录(VPT) 系统主要专注于从短视频窗口检测起始,导致偏移精度远落后于起始,且未见音符级力度的报告。 为弥补这些空白,我们提出 V2N (Video to Notes),这是第一个完整的 VPT 系统:共享的时间主干网络 (backbone) 连接多个任务专属头部,分别预测起始、偏移、按键保持和力度,并通过每帧监督 联合训练,而非仅对窗口中心监督。消融实验表明,多任务监督 不仅能实现偏移和力度预测,还能提升起始精度;更长的时序上下文 带来进一步提升。 V2N 在 PianoVAM 和 R3 数据集上取得了新的最先进结果。
论文精读
TL;DR V2N 是首个完整视觉钢琴转录系统,通过多任务、逐帧监督联合预测音符的起止、持键与力度,解决了踏板干扰导致的偏移不准问题。
问题
问题背景
自动音乐转录(Automatic Music Transcription, AMT)旨在从音频或视觉信号恢复音符的起音(onset)、音高(pitch)、偏移(offset)和速度(velocity)等属性。音频钢琴转录在起音和音高上已较为成熟,但偏移预测长期受延音踏板干扰:声音在键释放后仍持续,导致标注与物理释放时刻偏差可达数秒。
现有方法局限
视觉钢琴转录(Visual Piano Transcription, VPT)通过直接观测键盘状态绕开了踏板混淆,然而现有方法存在明显缺口:
- 仅使用极短视频上下文(≤0.2秒),难以捕获完整的键状态变化;
- 偏移检测精度远低于起音,且缺乏对音符级速度的有效预测;
- 训练监督通常集中在窗口中心帧,未能对每一帧进行充分优化,限制了长时间依赖的建模能力。
现有工作本质上将VPT简化为起音检测,未能提供完整的音符属性输出,制约了其在实际场景中的应用。
难点与重要性
从视频准确预测偏移和力度面临双重挑战:键释放是一个细微动作,需要足够长的视觉上下文来区分释放与短暂抖动;力度估计则要求从低分辨率手部运动中推断击键能量,属于细粒度运动分析。该问题对音乐信息检索、智能教学、档案修复等场景至关重要,尤其在音频缺失或嘈杂环境中,VPT是唯一可行的转录途径。业界对端到端视频到MIDI的需求日益增长,完整的属性预测可显著提高转录可用性。
行业类比
与自动驾驶中的多任务感知系统(同时检测物体、预测运动、分割车道)相似,VPT需要从单一视频流中联合解码多种时序事件,这对模型架构与监督设计提出了更高的多任务融合要求。
核心洞察
- 视觉模态能够直接观测钢琴按键的物理状态,避免了音频转录中因延音踏板导致的声音与琴键动作脱节问题。与其依赖踏板释放来判断偏移的音频系统不同,视觉转录可捕捉到琴键实际回弹的帧,从根本上解决了偏移预测的系统性偏差,使偏移准确率显著提升。
- 多任务、逐帧联合训练是 V2N 首次实现完整视觉钢琴转录的核心设计。通过共享时间骨干网络和四个任务特定头,系统不仅首次在视觉领域报告了音符力度(velocity),还观察到多任务监督能相互促进,甚至提升了 onset 检测精度;更长的时序输入带来的增益,验证了时空建模对于捕捉按键持续状态和释放动作的重要性。
方法
输入与主干
V2N 以 连续 1 秒视频帧(约 25-30 帧)作为输入,先用轻量 CNN 对每帧的钢琴键盘区域提取空间特征,得到逐帧视觉 token;随后送入共享时间主干网络(如时序卷积或 Transformer 编码器)捕获跨帧手指运动、键位变化等长程依赖,生成富含时序上下文的高维表征。
多任务预测头
在共享主干之上并行挂载四个轻量任务头:
- Onset Head:预测每个键在每一帧是否发生起始事件
- Offset Head:预测每个键在每一帧是否发生释放事件
- Key Hold Head:逐帧分类每个键的按下/抬起状态
- Velocity Head:回归键按下时的力度(基于按键速度) 每个头仅由少量全连接层或卷积层构成,共享表征确保跨任务信息流动,同时避免过参数化。
逐帧监督与训练
与现有方法仅在窗口中心帧计算损失不同,V2N 对输入窗口内的每一帧施加像素级监督。训练时,起始、偏移、按键状态、力度四类损失加权求和,联合优化整个网络。该设计强制模型学习精细的时间演化,尤其缓解偏移预测滞后问题。消融实验证实:多任务、逐帧监督不仅使偏移与力度预测可行,还额外提升起始检测准确率;增加时间上下文(从 0.2s 到 1s)进一步带来显著收益。
与同类方法的差异
现有视觉钢琴转录系统仅聚焦短窗口起始检测,偏移精度远低于起始,且未曾汇报音符级力度;V2N 首次通过多帧、多任务、每帧监督范式实现完整转录,同时输出起始、偏移、按键状态与力度,起步即达 SOTA。
实验
实验设计
V2N 在 PianoVAM 与 R3 两个数据集上进行评估,采用联合训练的多任务框架:共享时序 backbone 接四个专用 head,分别预测 onset、offset、key hold 和 velocity。与以往仅对窗口中心帧监督不同,V2N 对所有帧施加逐帧损失(per-frame supervision),输入视频片段扩展至 1 秒 以提供更长时序上下文。消融实验分别考察多任务监督与更长上下文的影响,并测试跨数据集迁移能力。
关键发现
- 多任务监督使 offset 与 velocity 预测成为可能,同时提升 onset 精度(相较于仅训练 onset 的单任务基线)。
- 将时序上下文从常规的 0.2 秒 扩大至 1 秒 可带来进一步增益,证明长程视觉线索对精确捕捉按键状态变化至关重要。
- 首次在该任务上报告 note-level velocity,且 offset 精度大幅缩小与 onset 的差距,实现完整的钢琴音符转录。
基线对比
现有 VPT 方法(如 [12,18,22])普遍使用极其短暂的视频窗口(≤0.2 秒),offset 准确率远低于 onset,且从未在音符级别报告 velocity。V2N 超越这些基线,不仅首次输出完整的四维音符属性,更凭借多任务学习与长时序建模,在 PianoVAM 与 R3 上均取得 state-of-the-art 结果。对比揭示出视频模态相比音频在 offset 检测上的本质优势:视觉可直接观察到物理按键的释放,不受延音踏板干扰,因此 V2N 捕捉的是真实的 MIDI NoteOff 事件,而非踏板延长的声音结束点。这一差异对钢琴演奏分析与自动记谱具有重要工程价值。
行业影响
落地场景
V2N 带来的完整视觉钢琴转录能力可直接嵌入三类产品:
- 音乐教育工具:自动将学生演奏视频转化为带力度、抬起时机的 MIDI 乐谱,用于实时反馈与练习评估。
- 数字音频工作站(DAW)插件:为视频录制提供免音频的高质量钢琴转录,消除踏板造成的 offset 歧义。
- 音乐信息检索(MIR)平台:对海量演奏视频进行精确的全元素转录,支撑搜索、推荐与版权分析。
商业价值
- 降本:自动化替代人工标注,让音乐教育平台和内容平台大幅减少专业记谱的人力成本。
- 体验提升:首次在视觉端同时输出准确 offset 和 velocity,使虚拟陪练、演奏评分、交互式乐谱跟随等功能的精细度达到实用水平,提升用户粘性。
- 增收:为 DAW 厂商提供差异化插件,或为流媒体平台提供高精度演奏元数据,拓展增值服务。
与现有工作流的接口
- 模型部署:V2N 采用纯视觉输入,可直接接在现有视频预处理管道之后,无需音频采集设备,适合低延迟边缘推理或云端大规模批量处理。
- 输出兼容:产出的 MIDI 或 JSON 格式直接对接现有 MIDI 工具链(合成器、记谱软件、DAW),无需改造下游系统。
- 多任务架构:任务特定 head 设计允许单独微调 onset/offset/velocity,方便根据应用场景裁剪模型尺寸。
具体落地用例
- 在线钢琴教学平台:学生用手机摄像头录制练习,V2N 实时生成包含精确琴键释放和力度信息的乐谱,并与标准版本比对,标记错音、错节奏、指法不当,给出量化评分和练习建议,大幅降低教师一对一听评的负担。
- 用户生成内容(UGC)音乐视频自动标签:短视频平台或音乐社区对用户上传的钢琴演奏视频进行离线转录,提取音符序列、力度变化和踏板无关的按键状态,用于自动生成 #古典 / #爵士 / #即兴 等风格标签,改善推荐系统冷启动,同时为演奏者提供可编辑、可混音的 MIDI 副本。
局限
- - **Offset 与 velocity 预测精度仍远低于 onset**:尽管 V2N 首次将 offset 和 velocity 纳入视觉转录,但论文在 abstract 中指出 audio-based 系统 offset 与物理键释放相差可达数秒,视觉虽能直接观察,但从结果看 offset F1 仍大幅落后 onset。velocity 作为连续回归任务更易受标注噪声、相机帧率限制,整体 note-level 速度预测能力有限,可能仅在强标注、固定视角下有效。
- - **1 秒固定窗口限制了实时与流式部署**:模型依赖 1 秒视频上下文进行逐帧监督,但推理时需完整窗口,这对需要低延迟的实时交互或流式转录场景不够友好。此外,引入长上下文虽在 ablation 中证明有益,但计算量随窗口增长,与轻量化需求形成权衡。
- - **跨场景泛化能力未充分验证**:实验仅在 PianoVAM 和 R3 两个固定视角数据集上进行,缺乏对遮挡、极端光照、不同钢琴型号、非正面视角等复杂条件的鲁棒性分析。跨数据集迁移实验结果仅作为初步展示,离实际应用中多样部署环境仍有距离。