Ego2Robot: 从第一人称人类数据进行可扩展的机器人数据合成
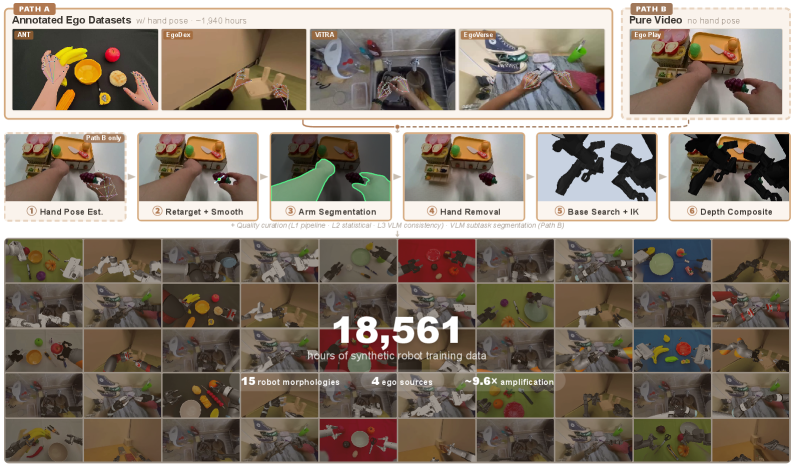
学习通用的机器人操作策略需要大规模且多样化的演示数据。第一人称(egocentric)人类操作视频提供了丰富的场景和任务多样性,先前工作表明,将这些视频重定向并渲染为机器人格式数据,可以在小规模上产生有效的单任务策略。然而,这种方法能否为视觉-语言-动作模型提供规模化预训练收益,仍未探索。 我们提出 Ego2Robot,一个可扩展的流水线,通过动作重定向、机器人手臂视觉合成和多层级质量筛选,将第一人称人类操作视频转换为机器人训练数据。Ego2Robot 支持精选数据集和在野视频,生成了 18,561 小时 的机器人训练数据,涵盖 15 种机器人形态,是迄今最大的 ego-to-robot 数据集。 为了评估泛化能力,我们扩展了 RoboTwin2.0,加入了可解耦的扰动轴,涵盖视觉外观、场景布局、具身形态和任务语义。实验表明,在 Ego2Robot 合成数据与真实机器人数据上联合预训练,能够持续提升跨多种扰动类型的分布外泛化能力,并在真实机器人部署中验证了其收益。
论文精读
TL;DR Ego2Robot 将大规模第一人称人类操作视频转换为 15 种机器人形态的训练数据,通过联合预训练显著提升视觉-语言-动作模型在多种扰动下的泛化能力。
问题
机器人操作策略的通用化 亟需大规模、高多样性的演示数据,但真实机器人遥操作采集成本高昂且场景覆盖有限。
现有方法局限
现有利用人类视频的工作大多止于 视觉表征预训练(如 R3M、VIP),并未直接为动作预测提供监督。少数将人类视频 重定向为机器人数据 的方法(如 Vid2Robot)仅在小规模任务上验证,且存在三个关键局限性:
- 转换 pipeline 不具备可扩展性:动作重定向依赖特定手部模型,视觉渲染无法泛化至 in-the-wild 视频中的复杂背景与光照;
- 合成数据质量参差:缺乏有效的质量筛选机制,动作对齐误差与渲染瑕疵被直接注入训练,损害策略性能;
- 泛化评估维度缺失:现有基准未系统拆解视觉外观、场景布局、硬件形态、任务语义等多种分布偏移,难以量化数据合成对泛化的真实贡献。
为何困难且重要
核心挑战在于弥合 人类自我中心视频与目标机器人平台 之间的巨大域差距:动作空间需精准重定向至不同运动学结构的机器人,视觉输入需将人手替换为机械臂并保持场景一致性,同时还要确保时序动作因果性不被破坏。解决该问题可释放互联网海量人类操作视频的潜力,大幅降低机器人数据门槛,推动 视觉-语言-动作(VLA)模型 的规模化预训练,是具身智能从专精场景走向通用操作的必经之路。
行业类比:犹如视觉领域的 ImageNet 预训练或语言模型的从海量文本预训练,基于人类操作视频的机器人策略预训练有望成为具身基础模型的规模化数据引擎。
核心洞察
- **将自我中心人类视频转化为机器人操控数据的可扩展流水线** Ego2Robot 提供了一种从海量第一人称人类视频中合成机器人演示的方法,通过动作重定向、机器人手臂视觉渲染和多级质量筛选,生成涵盖 15 种机器人形态的 18,561 小时训练数据。不同于以往小规模的单任务重定向工作,这条流水线首次验证了此类合成数据在大规模视觉-语言-动作(VLA)模型预训练中的有效性,为低成本获取多样化具身数据开辟了可行路径,尤其适用于真实机器人数据稀缺的场景。
- **解耦扰动评估框架揭示预训练的泛化增益来源** 作者在 RoboTwin2.0 基础上引入了视觉外观、场景布局、本体形态和任务语义四个独立扰动轴,系统量化模型在分布外(OOD)条件下的性能。实验表明,联合使用 Ego2Robot 合成数据和真实机器人数据进行预训练,能在多种扰动类型上持续提升泛化能力,这为评估机器人基础模型提供了比单纯成功率更细粒度的诊断工具,帮助研究者理解数据配方如何影响不同维度的鲁棒性。
方法
整体流程
Ego2Robot 旨在将第一人称人类操作视频大规模转化为机器人训练数据,其核心 pipeline 包含三个关键模块:动作对齐、视觉对齐和质量筛选,最终输出覆盖 15 种机器人形态、总计 18,561 小时的 robot-formatted 数据。
1. 动作对齐
从视频帧中提取人手关键点,通过**逆运动学(IK)**将人类手部轨迹重定向到目标机器人末端执行器(EEF),生成机器人可执行的动作序列。这一步将人体自然动作转换为对应 embodiment 的关节控制量,同时保留任务语义。
2. 视觉对齐
在动作对齐基础上,使用机器人手臂视觉合成技术,将原视频中的人类手臂替换为指定机器人的外观,并借助域随机化(如颜色扰动)提升视觉多样性,同时保持背景和交互物体不变。合成时还支持相机坐标系调整,使图像视角与机器人常用传感器布局一致。
3. 质量筛选
对合成后的数据进行多级过滤:剔除动作与视频内容不一致的片段、验证物理可行性(如无穿透)、评估任务完成度,仅保留高质量轨迹。该步骤确保生成数据可用于大规模预训练。
关键设计
- 双路径支持:既支持已有标注数据集(如 Ego4D),也兼容野生视频(in-the-wild),通过自动分割和手势估计处理未剪辑长视频。
- 灵活 embodiment:预定义 15 种不同机器人的 URDF 模型,生成数据时可按需切换,使策略能泛化到多种形态。
- 规模化产出:最终数据集规模远超以往工作(如 Roboturk 等),为 VLA 模型预训练提供了前所未有的多样性。
与同类方法(如 R3M、VIP 仅利用人类视频作为对比学习信号)相比,Ego2Robot 直接合成可执行的动作标注数据,并首次证明这种 ego-to-robot 数据能在 VLA 模型预训练阶段带来一致的泛化增益,突破了以往仅在单任务微调中有效的局限。
实验
实验设计
- 评估基准:扩展 RoboTwin2.0,解耦为四个泛化扰动轴:视觉外观(颜色/纹理)、场景布局(物体摆放)、具身形态(不同机器人构型)和任务语义(指令/目标变化)。
- 预训练数据:Ego2Robot 合成管道从自我中心人类视频生成 18,561 小时机器人数据(覆盖 15 种形态),与公开机器人数据集(如 Open X-Embodiment)联合预训练 VLA 模型。
- 下游评估:在多类操作任务上微调后测试分布外(OOD)泛化,并在真实 Franka 机器人平台上进行部署验证。
关键发现
- 联合预训练在所有四个扰动轴上一致提升 OOD 泛化性能,尤其视觉和布局变化下收益显著,表明合成数据覆盖了更丰富的场景多样性。
- 数据多样性与规模同等重要:仅增加机器人数据无法匹敌来自人类视频的多形态、多场景覆盖优势。
- 真实机器人实验证实,仅少量下游监督微调即可将预训练策略迁移至真实硬件,成功率提升明显。
与基线对比解读
- 相较仅用机器人数据预训练(如 Pi0.5),Ego2Robot 预训练模型在多任务泛化上表现更优,这归功于人类视频中蕴含的通用操作先验被有效重定向为机器人动作。
- 该方法展示了一条摆脱遥操作瓶颈的数据扩增路径:从海量“野生”人类视频中低成本合成训练信号,为构建通用机器人基础模型提供了工程上可行的规模化方案。
- 局限性:当前合成依赖手势估计质量,且对精细灵巧操作仍有差距,未来可结合更精准的重定向与仿真环境。
行业影响
落地场景
Ego2Robot 生成的合成机器人数据可直接用于视觉-语言-行动(VLA)模型的预训练,降低对昂贵真实机器人遥操作的依赖。典型应用包括:
- 仓储与物流:利用穿戴式摄像头采集人类分拣、打包视频,自动转化为多种机械臂的抓取-放置轨迹,快速覆盖抛掷、变形物体等长尾场景。
- 家庭服务机器人:从 YouTube 等平台的日常活动视频(如洗碗、整理)提取可执行策略,提升在陌生家居环境下的泛化能力。
- 柔性制造:小批量产线可通过少量人类示教视频合成多机器人类型的操作数据,加快换线速度。
商业价值
核心价值在于大幅降低数据采集成本。一条高质量机器人演示的成本在百美元级,而 Ego2Robot 利用的自我中心视频(如众包、网络视频)几乎零成本。以仓库场景为例,直接省去数万小时的人工示教费用,投资回报周期可从数月缩短至数周。此外,预训练模型在视觉外观、场景布局、本体形态等扰动下泛化能力更强,意味着机器人部署后的故障率更低,运维成本减少,产品的市场接受度提升。
与现有产品/工作流的接口
Ego2Robot 适合作为数据工厂的一环:
- 输入:未经处理的自我中心视频流(可来自智能眼镜、手机或已有数据集如 Ego4D)。
- 输出:统一的 VLA 训练样本(图像-语言-行动三元组),可直接接入 Open X-Embodiment、RT 系列模型或具身大模型的预训练管道。
- 集成方式:作为数据增强插件嵌入模仿学习框架,通过标准的
dataset_dict与现有仿真器(如 Isaac Sim、MuJoCo)或真机数据混合训练。工程上可提供 REST API 供 MLOps 平台调用,实现持续数据刷新。
具体案例:
- 电商仓储自动化:部署在已有机器人的仓库中,工人佩戴轻量级相机进行日常作业,视频经 Ego2Robot 流水线自动化合成多类型机器人的训练数据,用于模型每月迭代,保持对新产品形状和包装的适应能力。
- 在线视频平台:平台方利用海量 cooking / repair 类视频生成通用操作数据,向机器人开发商提供预训练数据集,形成新的数据货币化模式,同时加速整个行业的技能迁移。
局限
- **合成数据的真实度与泛化边界**:Ego2Robot 通过动作重定向与视觉合成生成机器人数据,但合成过程引入的渲染失真、物理不准确(如无接触力反馈)可能造成仿真到现实(sim2real)的鸿沟。虽然论文通过多级质量整理和颜色随机化缓解,但当任务要求精细力控或动态交互时,从自我中心视频提取的动作语义可能丢失关键物理信息,导致策略在真实部署中性能下降。此外,当前支持的 15 种机器人形态仍远少于现实多样性,对未见的末端执行器或非刚性物体的泛化未充分验证。
- **动作对齐对源视频质量的强依赖**:管道中的手部姿态估计与重定向步骤对视频清晰度、视角、遮挡高度敏感。在“野外”(in-the-wild)视频中,手部经常被物体遮挡,或存在快速运动模糊,此时估计的 3D 关键点噪声大,重定向误差会直接污染动作标签,即使经过质量过滤,也可能丢失部分有效数据或引入系统性偏差。论文未量化不同视频质量下的性能降级,以及如何自适应处理极端情况。
- **评估基准的覆盖范围与分布外泛化的局限性**:扩展的 RoboTwin2.0 针对视觉外观、场景布局、具体化形态和任务语义设计了解耦扰动,但这些扰动仍属于近分布(near-OOD)变化。对于更极端的域偏移(如全新物体类别、完全不同的环境背景),联合预训练带来的增益是否持续未知。另外,真实机器人实验仅涉及有限任务,大规模预训练在长序列任务或更复杂操作中的价值缺乏证据。