CAPEval:跨理解与生成的解耦式描述评估
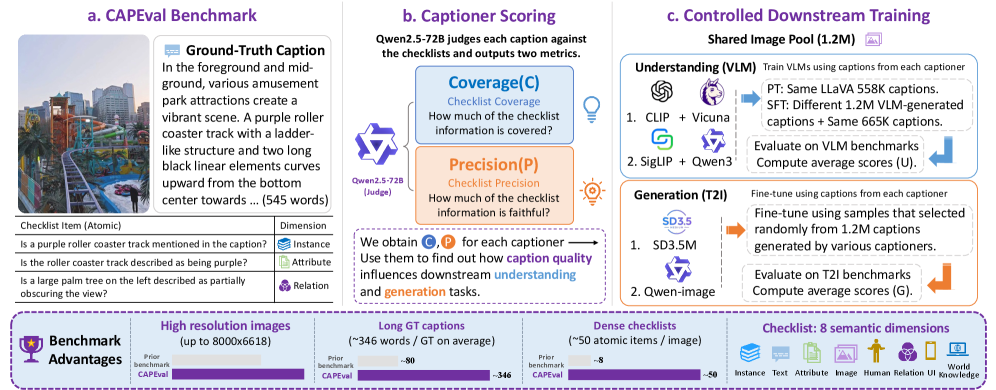
描述是理解多模态和理解生成的主要监督信号。然而,以往评估将描述质量视为单一标量目标,混淆了两个不同属性:(1) 描述覆盖多少视觉信息;(2) 图像支撑其主张的可靠程度。 为此,我们设计了解耦描述评估基准 CAPEval(Coverage And Precision Evaluation),包含人工撰写的真值描述和人工核对的原语清单。CAPEval 将描述质量分解为 覆盖率(Coverage) 与 精确率(Precision):前者量化描述覆盖真值事实内容的充分性,后者反映描述中所有主张的事实正确率。 我们选取 10 个描述器,并利用四类模型族开展受控下游端到端实验,仅改变描述来源。实验发现一致的任务依赖分离:覆盖率 是理解性能的主要相关因子,精确率 是生成性能的主导预测因子。 该解耦评估范式不仅提供更细粒度的诊断,还为不同下游任务选择与优化描述器提供可操作指导。
论文精读
TL;DR 提出 CAPEval 基准,将图像描述质量解耦为 Coverage(覆盖度)与 Precision(精准度),并验证两者分别主导多模态理解与文本到图像生成的下游性能,为任务驱动的描述器选择提供可操作指导。
问题
问题背景
多模态理解与文本到图像生成严重依赖图像标题作为监督信号。当前领域关注如何高效构建大规模、高质量的图文对数据,并评估标题对下游任务的实际效用。
现有方法局限
传统标题评估指标(如 CIDEr、SPICE)将质量视为单一标量,无法区分两个关键维度:Coverage(标题对图像视觉内容的覆盖程度)与 Precision(标题中每个陈述的事实正确性)。这种混同导致:
- 在筛选训练数据时,无法判断一个标题是因为信息不全还是事实错误而得分低;
- 为下游任务选择标题生成模型时,缺乏针对性——理解任务需要高覆盖,生成任务要求高精度,但单一分数无法给出这种差异化的指导。
为什么这个问题难且重要
解耦评估需要构建细粒度的人工标注基准,包括参考标题和原子事实清单,成本高昂。此外,覆盖度与精密度往往存在权衡:更详细的标题可能引入更多幻觉。该问题的解决直接影响:
- 多模态基础模型的数据配比策略:若理解任务为主,应使用高覆盖标注器;若生成任务为主,则应优先高精度标注器;
- 标题质量的可诊断性:开发人员能定位模型是漏掉了重要内容还是编造了虚假信息,从而针对性地优化数据或训练。 业界正从大规模粗暴爬取数据转向精细数据工程,解耦评估提供了关键的量化工具。
行业类比
类似信息检索中的召回率与准确率:视觉问答等理解任务追求“全面捕获”,需高召回;文生图训练要求“图文严格一致”,需高精度。一套解耦指标能像搜索引擎微调一样,让数据标注流水线根据下游场景灵活配置。
核心洞察
- Caption 质量评估不应是单维标量,**覆盖度 (Coverage)** 与 **精确度 (Precision)** 的解耦揭示了‘多不等于准’的根本矛盾。传统评估将 caption 好坏压缩成一个分数,无法区分模型是遗漏了关键信息还是生成了幻觉。CAPEval 通过人工原子级 checklist 将两者分开度量,使得我们能够诊断不同 captioner 的弱项是在信息遗漏还是在事实错误上,为针对性优化提供了清晰方向。
- 下游任务对 caption 质量的敏感维度存在明确任务依赖:**视觉理解任务** 的表现与 Coverage 强相关,而 **文本到图像生成任务** 的表现主要受 Precision 影响。这一发现打破了‘更好的 captioner 对所有任务一视同仁’的假设。工程师可以依据下游任务类型直接选择更匹配的 captioner:做多模态理解时优先提升 Coverage,做图像生成时则需严格控制 Precision,避免模型被不精确的文本描述误导。
方法
CAPEval 提出了一种解耦的图像描述(caption)评价范式,将质量拆解为 Coverage(覆盖度) 与 Precision(精确度) 两个独立维度,思路如下。
输入:一张图像及其对应的一条待评测描述(caption),同时提供人工编写的参考描述(ground-truth caption) 和人工核验的原子化事实检查表(atomic checklist items),检查表中的每一条目对应一个视觉事实。
关键模块:
- 基准构建:基于多源图像,招募标注人员撰写高质量密集参考描述,并从中抽取独立事实单元,形成结构化检查表。检查表覆盖对象、属性、关系等多种维度,每个条目都经过人工双重验证,确保事实正确且原子化。
- Coverage 度量:给定待测描述,通过与参考描述的语义比对或基于检查表的覆盖情况,计算它所涵盖的参考事实的比例。覆盖度衡量描述“漏看了多少”。
- Precision 度量:将待测描述拆解为一组原子声明,对照图像和检查表判断每条声明的真实性,精确度=真实声明的数量 / 总声明数量。精确度衡量描述“说错了多少”。
输出:对每个描述给出 (Coverage, Precision) 二元组,而不是单一总分。评测覆盖 10 个不同模型家族的描述生成器,并在理解(VQA、检索等)和生成(文本到图像)下游任务上进行控制实验,验证解耦指标与任务性能的关联。
差异点:传统描述评价(如 CIDEr、SPICE)将质量压缩为单一标量,CAPEval 首次将“全不全”和“对不对”分离,并系统证明了 Coverage 与理解任务相关性更强,Precision 与生成任务相关性更强,为按下游任务选描述器提供了可操作的诊断工具。
实验
实验设计
CAPEval 构建了一个解耦的 caption 评估基准,包含人工编写的 ground-truth captions 和人类验证的 atomic checklist items。选取了 10 个不同 captioner,覆盖四个模型家族,并在下游任务中保持所有条件不变,仅将 caption 来源作为唯一变量。下游任务分为两类:视觉理解(如 VQA)和文本到图像生成。通过控制变量,直接衡量不同 caption 对下游性能的影响,避免了其他混杂因素。
关键发现
实验发现 Coverage 与 Precision 存在任务依赖的分离:Coverage 与理解任务性能的相关性更强,而 Precision 则与生成任务性能的相关性更强。这一发现表明,传统单一标量评估(如 BLEU、CIDEr)掩盖了 caption 质量的两个维度对不同下游任务的不对称影响。
与基线的对比解读
相较于将 caption 质量视为单一标量的传统评估,CAPEval 的解耦评估提供了更细粒度的诊断能力。例如,高 Precision 但低 Coverage 的 caption 可能适合生成任务,却会损害理解任务。这种洞察为工程实践提供了明确指导:在选择或优化 captioner 时,不应只看排名分数,而应根据目标任务类型侧重匹配 Coverage 或 Precision 能力,从而避免盲目追求单一高分数导致的下游性能受损。
行业影响
落地场景
CAPEval 解耦评估框架直接服务于两大核心 AI 工作负载:多模态理解(如图文检索、VQA、视觉推理)与 文本-图像生成(如 Stable Diffusion、DALL·E 系列)。它可用于:(1) 训练数据管线优化——在自动标注或合成数据集构建时,用 Coverage 筛选信息覆盖率高的描述,提升理解模型对细节的捕获;用 Precision 过滤事实性错误的描述,减少生成模型的幻觉。(2) Captioner 选型与迭代——对比不同视觉-语言模型(如 BLIP-2、LLaVA、CogVLM)输出的描述质量,无需高昂下游 fine-tune 即可预测其在下游任务上的表现。
商业价值
- 降本:传统评估依赖全量下游实验,成本高、周期长。CAPEval 提供 低成本代理指标,单个 captioner 只需一次基准测试即可预测其在多任务上的相对表现,减少试错与计算开销。
- 体验提升:在生成式应用(如 AI 设计工具、广告创意生成)中,用户 prompt 往往依赖图像描述作为正样本。高
Precision的描述能更准确地反映图像内容,使生成的图像更符合预期,降低用户修改率。在搜索与推荐中,高Coverage描述覆盖更多视觉属性,提升召回率与相关性。 - 增收:更精准的描述生成可提升电商商品图的搜索点击率、内容平台图文匹配的广告转化率等。
与现有产品/工作流的集成
CAPEval 以 人类撰写的 ground-truth 描述和原子化 checklist 为基础,可封装为 API 或 CI/CD 检查点,嵌入现有 MLOps 流程:
- 数据平台(如 HuggingFace Datasets、Scale AI):提供 CAPEval 打分卡,标注团队用其审计自动标注质量;
- 模型训练平台(如 Vertex AI、SageMaker):在训练前通过 CAPEval 自动筛选 captioner,将其作为数据预处理节点;
- 生成服务(如 Midjourney、Stable Diffusion API):将
Precision指标作为生成质量的旁路监控,当生成描述与源图像出现事实性偏差时触发告警。
具体落地 Use Case
- 电商商品描述生成:某产品图像需要同时用于搜索和详情页。搜索要求高召回(靠
Coverage),详情页要求高准确(靠Precision)。利用 CAPEval 同时对多个 captioner 打分,可选择Coverage最高者驱动搜索索引,Precision最高者生成详情文案,实现同一个图像源的多用途优化,避免人工反复试错。 - 社交媒体内容审核:平台自动生成用户上传图像的描述,用于安全审核。若描述包含虚假或误导性物体(如将无害物体描述为武器),会触发误报。使用高
Precision的 captioner 生成描述,可直接降低误审率,减少人工复核成本。
局限
- **仅覆盖事实正确性与信息覆盖维度**:CAPEval 将描述质量拆解为 Coverage 和 Precision,着重衡量视觉内容覆盖度和声明的真实性,但未纳入流畅度、多样性、风格、情感等文本质量维度。实际应用中,描述的质量是多维的,仅依赖这两个指标可能不足以全面评估,尤其在需要创意或用户偏好敏感的生成场景。
- **人工标注的主观性与规模限制**:Ground-truth 描述和原子检查项由人工编写和验证,尽管设计严谨,仍不可避免引入标注者偏差,且覆盖的图像域和概念范围有限。目前基准仅包含 200 张来源相对单一的图像,可能不适用于分布外图像或特殊领域,泛化性有待扩展验证。
- **下游任务覆盖局限**:论文中仅选用四个模型家族、10 个描述器,并在受控训练设置下考察了视觉语言理解和文本到图像生成任务,未涉及更广泛的多模态任务(如视频理解、机器人导航)。此外,Coverage 与 Precision 的权衡关系未深入探讨,缺少优化两个目标的联合策略,限制了直接工程指导的实际覆盖率。