GROVE: 从流式视频体验中基于时间分层记忆的成长与推理
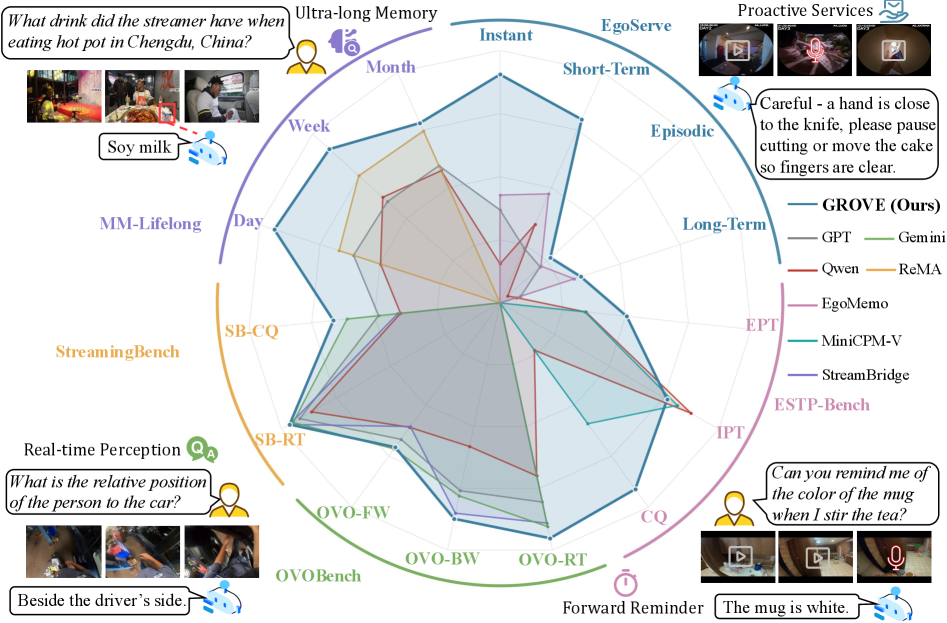
可穿戴助手既要能回答关于视觉历史的问题,也要能识别历史何时对当前情境有用。现有视频记忆系统主要支持基于问题的回忆,而主动助手的记忆与控制机制通常是分离的。我们提出 GROVE,一种免训练框架,用从连续视频流中因果式增长的一个记忆同时支持两种行为。GROVE 保留细粒度的感知证据,并逐步将其整合为带时间戳的时刻、连贯的情节和跨日的重复模式。每个层级搭配一个原生尺度的检索技能,用于定位观察、回放活动或遍历长期规律。被动回答(QA)和主动辅助共享该记忆和访问接口,区别仅在于检索是由用户查询还是当前情境触发。 在包括具有挑战性的 MM-lifelong 和 EgoServe 在内的多项基准上,GROVE 均取得了最佳结果。受控消融实验表明,时间层级及其访问技能是互补的,其中模式在证据跨越多天时带来最大收益。代码将发布于 https://github.com/SitongGong/GROVE。
论文精读
TL;DR GROVE 是一种无需训练的框架,从连续视频流中构建分层时间记忆(时刻、片段、跨日模式),并配备对应检索技能,统一支持反应式问答与主动辅助,在多个基准上达到最佳性能。
问题
可穿戴 AI 助手正从被动问答走向主动服务,视频记忆系统 需要从持续的第一人称视角视频流中提取并组织经历,同时支持回顾性提问和前瞻性提示。现有方法通常将两种能力拆开处理:被动 QA 依赖独立的回忆模块,主动辅助则使用单独的记忆与控制机制。这种分离导致信息冗余、架构复杂,且无法在统一的记忆体系中高效整合跨时间尺度的证据。许多系统在增量构建记忆时,缺乏对细粒度感知细节和长期规律的有效组织——要么丢失关键证据,要么无法抽象出可复用的跨日模式。
此问题的难点在于:流式视频是开放域、多尺度的,记忆必须在线增量更新,同时平衡存储开销与检索精度。一段“昨天把钥匙放哪了”的查询需要回溯特定时刻,而“用户每天下午三点会泡咖啡”这样跨天的规律则需要聚合多日数据才能浮现。传统基于窗口或固定分块的记忆结构难以同时满足这种既要求毫秒级定位又需要语义级总结的混合检索需求。在工业界,如个人智能助理、机器人环境记忆、AR 眼镜应用等场景中,对长时视觉记忆的持续构建与灵活动态访问,已成为决定系统智能程度的关键瓶颈。
打个比方,这就像自动驾驶需要同时拥有实时感知与长期地图构建的能力:可穿戴 AI 既要在当前情景中做出反应,又必须将过往经历结构化凝练成“经验地图”,以驱动无问自答的主动智能。
核心洞察
- **GROVE** 提出单一的分层时间记忆,同时支持反应式问答与主动协助,无需额外训练。与现有系统(如仅支持查询条件回忆或使用分离记忆与控制机制)不同,GROVE 从视频流中因果构建记忆,并为每个时间尺度(时刻、事件、跨日模式)配备尺度原生检索技能。这一设计统一了记忆的存储与访问,使系统能在相同记忆上,根据用户查询或当前情境灵活切换检索触发方式。
- **跨日模式**(recurring cross-day patterns)的引入弥补了长期视频记忆仅记录时刻或事件的不足。消融实验显示,当证据跨越多天时,模式层带来的收益最大,表明提取长期规律对可穿戴助手至关重要。这一发现揭示了高层规律性在流式视频记忆中的互补价值,为未来长期自适应系统提供了清晰的设计方向:应超越临时快照,主动挖掘重复出现的模式以提升辅助质量。
方法
输入与整体流程
GROVE 以穿戴设备采集的连续、第一人称视频流作为输入。系统沿时间顺序(causal)增量处理每一帧,不依赖未来信息,适合流式部署。整个框架无需训练,仅依靠多模态大模型(MLLM)的推理能力完成记忆构建与检索。
关键模块一:增量式时态分层记忆构建(Incremental Memory Construction)
- 细粒度感知证据:首先从原始视频中提取关键视觉事件或对象,保留可检索的底层观察。
- 带时间戳的 Moment:将相邻、连续的感知证据聚合成短时片段,例如“拿起钥匙”这类短暂动作。
- 连贯 Episode:基于语义关联,将多个 Moment 合并为更完整的活动单元,如“出门前整理背包”。
- 跨天重复 Pattern:统计多日间相似 Episode 的时空规律,形成对用户习惯的长期表征,如“每天早上 8 点喝咖啡”。
每一层级的构建都是从细到粗、在线进行的:新证据先被写入 Moment 层,满足条件时触发 Episode 的更新,长期累积则提炼出 Pattern。这种分层方式在保持原始细粒度的同时,提供了多尺度抽象。
关键模块二:尺度原生检索技能(Scale-Native Retrieval Skills)
GROVE 为每一记忆分层匹配一个专用的检索器:
- 定位技能(Locate):在细粒度证据层中查找某一具体观察,如“昨天下午 3 点的钥匙位置”。
- 重放技能(Replay):在 Episode 层将一段连续活动整合成可叙述的回顾。
- 遍历技能(Traverse):利用 Pattern 层跨越数天寻找规律,回答“我通常把钥匙放在哪里”或主动提醒即将发生的错误。
检索技能与记忆层级紧密耦合,不同粒度的查询被路由到最合适的层,避免了单一扁平记忆在长程依赖上的不足。
统一访问接口:反应式 QA 与主动辅助
记忆和检索技能通过同一接口暴露。反应式问答由用户查询触发,将问题转化为对三层记忆的检索调用;主动辅助则将当前实时情境(无需用户提问)作为隐式查询,若检索到风险 Pattern,则主动推送提醒。二者的差异仅在于检索发起方。
实际工程启示
- 训练无关设计便于快速集成到不同设备,无需为每个新场景收集标注数据。
- 分层互补检索解决了长视频流中证据稀疏与检索效率的矛盾,工程师可参照此模式设计自己的记忆系统。
与同类方法的差异
与现有视频记忆系统通常只支持查询驱动的回忆或需独立记忆与控制机制不同,GROVE 首次以单一分层记忆同时服务于被动问答与主动辅助,且完全训练无关,在 MM-lifelong 和 EgoServe 等基准上达到最优。
实验
实验设计
在 MM-lifelong 和 EgoServe 两个流式视频基准上评估 GROVE,覆盖反应式问答与主动协助两种任务。方法以因果在线方式构建分层记忆,评测采用训练无关(training‑free)设置,与现有视频记忆系统及分离式主动助手对比。消融实验逐步移除时刻、片段、模式三层记忆及对应的访问技能,量化各部件贡献。
关键发现
GROVE 在所有对比方法中取得最优结果,证明统一记忆架构可同时胜任被动问答与主动提醒。消融结果显示三层时间抽象及其专属检索技能具有互补性:移除任一层均导致性能下降;当证据跨越多天时,模式层(cross‑day patterns)带来的增益最大,突显长期规律建模对可穿戴助手的核心价值。
与基线对比
现有系统通常将问题驱动的记忆检索与主动协助的记忆和控制分开设计,而 GROVE 用同一个由流式视频因果增量构建的记忆同时服务于两类需求,无需额外训练即可泛化。这一设计减少了架构复杂度,同时在不同任务上具备竞争力,揭示出分层时间抽象与尺度特化检索原语结合的有效性,为统一视频记忆系统设定了新的基线。
行业影响
落地场景
- 可穿戴 AI 助手(智能眼镜 / AR 头盔):记录用户日常视觉历史,支持回顾性问答(如“昨天钥匙放哪了”)与主动提醒(如“即将重复错误操作”)。
- 机器人 / 自动驾驶:长期环境记忆与跨天异常检测,提升任务连贯性。
- 视频监控与安全:跨摄像头、多日模式挖掘,实现主动预警与证据回溯。
- 企业服务:远程协作中记录操作历史,提供上下文感知的实时辅助。
商业价值
- 降本:GROVE 免训练,直接基于现有 VLM 构建,省去标注与模型定制开销,部署成本低。
- 增收:主动辅助功能提升产品差异化,可作为高端 AR 眼镜等硬件的核心卖点,推动设备销量。
- 体验优化:毫秒级记忆检索与分层推理,缩短响应延迟,降低用户错误操作率,提升粘性。
与现有产品 / 工作流接口
- 插件式记忆后端:GROVE 以服务形式接入视频理解流水线,替代传统的帧检索或摘要模块,提供统一查询接口(如
memory.query(text, timestamp_range))。 - VLM 编排集成:记忆构建与检索 prompt 可复用现有 VLM 服务,通过轻量编排层调用,无需额外训练。
- 事件驱动集成:支持流式视频输入,输出结构化记忆与检索结果,可对接 IoT 平台或边缘计算节点。
具体用例
- 电商直播:主播佩戴 AR 眼镜,GROVE 记忆商品展示时序。观众提问“之前红色裙子是什么时候介绍的?”时,系统自动检索对应瞬间并展示信息;同时主动提醒主播“该商品已展示 3 次,建议补充尺码”。
- 工业巡检:工程师头戴设备巡检,GROVE 记忆过往检查点。当当前读数与跨天历史模式不符时,主动告警并检索类似异常的处理记录,辅助现场决策。
局限
- **依赖冻结模型**:GROVE 使用训练无关的冻结 VLM (Vision-Language Model) 提取感知证据并驱动所有检索技能,未引入任何记忆压缩或索引的在线学习环节。这导致记忆构建策略无法根据用户长期行为模式自适应优化,在高度个人化的可穿戴场景下,检索精度和存储效率可能不及可微记忆系统。
- **主动辅助评估尚未标准化**:论文主要依赖 EgoServe 等现有基准衡量主动推送的触发性,但主动辅助的实用性涉及用户意图预测、上下文干扰等复杂因素,当前基准仅模拟部分场景。缺少真实世界部署数据或人工评估,框架在复杂多任务流中的无效推送率与用户接受度仍不明确。
- **跨日模式鲁棒性受限于视觉质量**:GROVE 通过汇总多日观察提炼跨日规律,当视频流中出现严重遮挡、光照突变或无关帧时,感知证据的噪声会被模式层放大,导致规律偏差。论文未讨论异常帧过滤或不确定性量化,在真实穿戴视频稀疏且干扰频繁的条件下,长期记忆的可靠性存在隐患。