InfiniSplat:面向大基线单目视图合成的隐式高斯解码
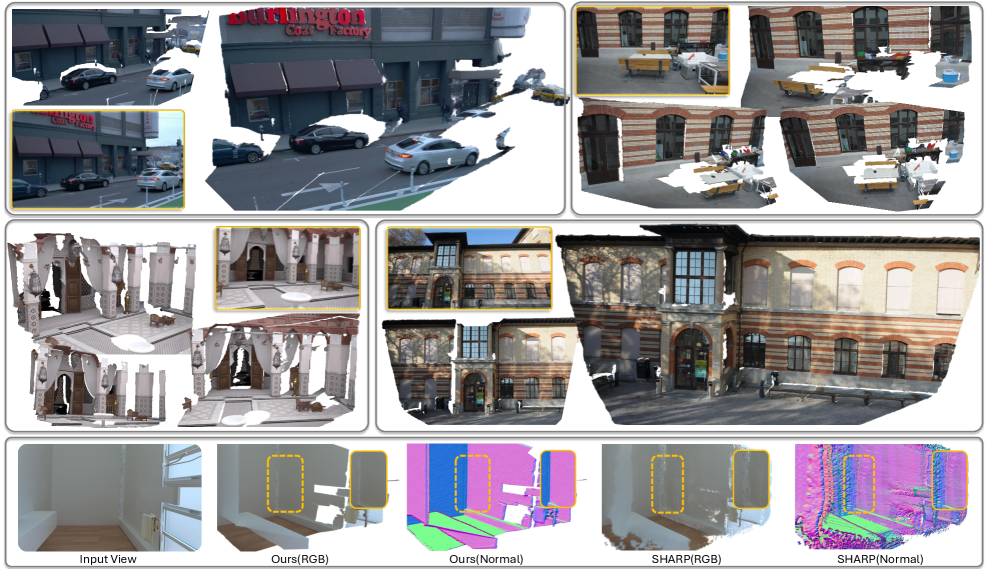
单图前馈 3D 高斯泼溅(3DGS)旨在从单张输入图像直接生成可渲染的 3D 场景表示,避免了多视图采集和逐场景优化的成本。然而,现有方法常受限于像素对齐表示,即高斯从固定图像网格位置预测。这类像素对齐基元能产生不错的近视图渲染,但与底层场景表面耦合较弱,在大视角变化下难以保持连贯结构。 我们提出 InfiniSplat,一种前馈单图 3DGS 框架,从像素对齐表示转向表面对齐表示。InfiniSplat 首先通过几何引导采样,根据深度诱导的局部表面结构放置 2D 支撑点,然后应用查询条件隐式解码器,从这些支撑点查询的图像特征预测高斯属性。通过将支撑点位置锚定在几何上,同时将高斯预测与固定像素中心解耦,InfiniSplat 生成的高斯布局能更好地贴合场景表面,并减少网格离散化造成的散乱基元。 在多个跨数据集 NVS 评估中,InfiniSplat 相比单图前馈基线达到最优性能,并展示了从 Hypersim 室内合成训练到复杂开放世界场景的零样本泛化能力。项目页面:https://zju3dv.github.io/InfiniSplat。
论文精读
TL;DR InfiniSplat 从单张图像前馈生成 3D 高斯场景,通过几何引导采样与隐式解码,将高斯元从像素对齐转为表面对齐,大幅提升大视角变化下的新视图合成质量,实现 SOTA 与零样本泛化。
问题
问题背景
单图像新视角合成(NVS)旨在从单张 RGB 输入直接生成可渲染的 3D 场景表示,省去多视角采集和逐场景优化成本。随着 3D Gaussian Splatting (3DGS) 的兴起,前馈式单图像 3DGS 方法成为高效生成式 3D 重建的热点,尤其追求在大幅基线(viewpoint shift) 下仍保持场景结构一致性。
现有方法局限
目前主流方法采用像素对齐(pixel-aligned)表示:Gaussians 被预测在固定的图像网格位置,每个像素点直接生成一个或多个高斯基元。这种方式在邻近视角渲染中表现尚可,但存在根本缺陷:
- 弱表面耦合:Gaussians 的 3D 位置被图像坐标绑定,导致基元悬浮在空中或穿透表面,难以准确跟随场景几何。
- 大视角断裂:当目标视角偏离输入相机较大时,原本在输入视角下可见的网格点可能无法覆盖新视角所需的表面区域,造成空洞、细节丢失和结构错乱。
- 离散化噪声:网格硬性采样导致 Gaussians 分布存在伪影,如条带或虚假聚集,降低渲染质量。
为什么这个问题难且重要
难点在于从单目 2D 图像解耦出准确的 3D 表面先验。像素对齐本质上是一种 2D 代理,缺乏显式的几何推理;而要实现表面对齐,需要可靠的单目深度估计、跨视角特征融合以及解耦 Gaussians 分布与像素网格的强绑定。此外,该方法必须保持前馈特性,避免逐场景优化,这对模型泛化提出极高要求。
重要性体现在多个 3D 应用前沿:AR/VR 需要从单张图片即时构建可自由巡视的沉浸场景;机器人需要从单次观察推断完整 3D 结构用于操作;电影、游戏等数字内容创作依赖高效的单图转 3D 管线。业界对**“一次拍摄即可 3D 化”** 的需求日益迫切,而表面一致的表示是通向高质量任意视角合成的关键。
行业类比
类似 NeRF 从稠密视图到稀疏视图的演进,将 Gaussians 从像素对齐推向表面对齐,好比让 3D 基元从“贴片”升级为“贴面”,可类比自动驾驶中从 2D 检测框到 3D 占位网络的空间认知跃迁。
核心洞察
- 从像素对齐(pixel-aligned)到表面对齐(surface-aligned)的表示转变是单目新视角合成的关键突破。InfiniSplat 通过深度引导的 2D 支撑点采样,使高斯原语附着于底层表面而非固定图像网格,这显著缓解了像素对齐方法在大基线视角变化下结构断裂和散射伪影的问题,生成了更连贯的场景几何。与传统的 feed-forward 3DGS 方法相比,该设计将单图重建从“图像空间复制”提升为“几何感知生成”。
- 几何引导采样与查询条件隐式解码器的组合解耦了高斯预测与像素坐标。InfiniSplat 不直接回归高斯参数,而是在表面支撑点处查询图像特征,用一个小型 transformer 解码器迭代更新高斯属性。这种隐式解码相比于显式逐像素解码,能更灵活地融合多尺度特征,且避免了网格离散化带来的原语错位,因此在跨数据集泛化和零样本开放世界场景中展现出更强的鲁棒性。
方法
InfiniSplat 从单张 RGB 图像出发,构建表面对齐的 3D 高斯表示,用于大基线新视图合成。
输入与预处理
- 输入:单张任意场景的 RGB 图像。
- 单目深度估计:利用现成的深度预测模型(如 Depth Anything)生成粗略深度图,作为后续几何采样的基础。
核心模块
- 几何引导采样:在深度图的引导下,沿局部表面结构自适应放置一组 2D 支持点。采样策略使得点云更贴合真实表面,而非固定在像素网格上。
- 特征提取与查询:采用双分支图像编码器——一个提取全局上下文,另一个生成密集像素特征。对每个支持点,通过投影到图像平面查询对应位置的特征,并进行多尺度融合,得到每个点的条件特征向量。
- 隐式高斯解码器:一个查询条件的轻量网络(如 MLP 或 Transformer 块)以融合特征为输入,直接预测该点对应的高斯属性:位置偏移、协方差(缩放+旋转)、颜色系数及不透明度。解码过程完全可微,并支持迭代更新以逐步精化参数。
输出与训练
- 输出:一组 3D 高斯基元,可直接送入可微光栅化器渲染任意相机位姿下的图像。
- 训练目标:在已知多视图数据上,采用渲染图像与真值的 L1 损失、LPIPS 感知损失,并结合高斯正则项(如抑制不规则缩放和边缘不透明度)进行端到端优化。
与同类方法的差异
不同于 pixelSplat 等像素对齐方法,直接将每个像素映射为一个高斯,InfiniSplat 解耦高斯生成与固定像素网格,通过几何引导的隐式解码,使高斯分布更贴合表面结构,从而在大视角偏移下保持连贯的几何与纹理。
实验
实验设计
InfiniSplat 在 Hypersim 室内合成数据集上训练,并在多个室外复杂场景数据集上进行零样本跨数据集新视角合成(NVS)评估。基线方法包括单图前馈 3DGS 模型(如 SHARP 等),评估指标为标准图像质量度量(PSNR、SSIM、LPIPS)。
关键发现
- 表面对齐表示 相比像素对齐表示,在大基线视角变化下能保持更连贯的场景结构。
- 几何引导采样 根据深度诱导的局部表面结构放置 2D 支撑点,有效减少离散网格导致的散乱高斯原语。
- 查询条件的隐式解码器 允许从图像特征灵活预测高斯属性,解耦固定像素中心,提升渲染质量。
基线对比深度解读
InfiniSplat 的核心突破在于从 像素对齐 到 表面对齐 的范式转变。像素对齐方法(如 LGM、Flash3D)直接从图像网格回归高斯,近距离视角渲染尚可,但远视角下易出现漂浮伪影和结构断裂,因高斯与表面几何耦合弱。InfiniSplat 通过深度引导的支持点采样和隐式特征解码,使高斯分布更贴合实际表面,从而在 大基线视图合成 中显著优于 SHARP 等基线,并展现从合成室内到真实室外场景的强泛化能力。这一设计对工程实践的启示:在单图 3D 重建中,显式注入几何先验并解耦空间采样与特征预测,是提升几何一致性和泛化性的有效路径。
行业影响
落地场景
InfiniSplat 的单图前馈 3D 重建能力使其天然适配无需多视角采集的实时应用。在电商领域,可用于商品 3D 展示生成——仅凭单张产品图即可产出 3D 模型供用户旋转查看,极大降低 3D 资产制作门槛。在内容平台(如短视频、游戏)中,它能从普通视频帧或照片一键生成可编辑的 3D 场景,支撑虚拟道具放置、背景替换等特效。自动驾驶仿真中,从路测视频的单帧快速生成 3D 高斯表示,可辅助构建高真实感街景,加速仿真数据闭环。
商业价值
该方法的核心价值在于成本侧:传统 3D 重建依赖多视角采集和逐场景优化,人力与硬件成本高昂。InfiniSplat 的 feed-forward 架构直接替代了该环节,对海量内容生产场景(如 UGC 3D 内容平台)可带来数量级的成本缩减。同时,其大基线视角合成能力提升了生成内容的可用视域范围,直接改善交互体验,有望在电商转化率、沉浸式广告点击率等指标上带来增益。
与现有产品/工作流的接口
该方案以输入单图→输出 3D 高斯表示的方式,可轻松嵌入现有渲染引擎(如 Unreal Engine、Blender)的前端处理流程。具体可封装为:
- RESTful API 服务:接收图片,返回
.ply格式的高斯场文件或封装的渲染参数。 - 客户端 SDK:在移动端或 PC 端直接调用模型,实现本地快速重建。
由于其输出为标准 3DGS 表示,可直接与下游渲染器(如 GS-SLAM、实时 Gaussian Splatting 管线)对接,无需重建中间表示。这对已有 3DGS 技术栈的团队而言,集成成本极低。
典型落地用例
- 虚拟试衣/饰品佩戴:用户上传衣物或饰品参考图,系统生成 3D 资产并渲染到人体模型上,实现任意角度的真实佩戴预览。
- 教育/科普中的物体讲解:博物馆或教育机构仅需单张文物照片,即可生成可交互的 3D 展示,无需昂贵的三维扫描设备。
局限
- **依赖深度估计精度**:几何引导采样依赖预训练单目深度模型生成的支持点位置,当面对透明、镜面或弱纹理区域时,深度预测可能不稳定,导致支持点偏离真实表面,从而退化成类似像素对齐的布局,损害大基线视图下的结构连贯性。论文实验虽表明方法对深度噪声有一定鲁棒性,但极端情况下的失效风险仍存在。
- **推理计算开销较高**:相比于纯像素对齐的前馈方法,InfiniSplat 需要对每个支持点进行可学习的隐式解码和特征融合,增加了显存占用和推理延迟。论文未详细报告推理速度,但在高分辨率或大量支持点场景下,实时性可能受限,对部署在边缘设备或需要快速交互的应用场景不够友好。
- **遮挡区域重建能力有限**:单图输入无法直接观测被遮挡表面,大基线视角下,遮挡区域的几何与纹理只能依赖数据驱动的先验填补,容易出现模糊、失真或空洞。论文在跨数据集测试中展现了 zero-shot 泛化,但从合成室内到自然场景的分布偏移仍会导致部分部件细节丢失或结构错位,限制了在开放世界自由视点渲染中的可靠性。