GradCuit: 基于梯度的回路传播实现鲁棒且可解释的测试时隐式推理
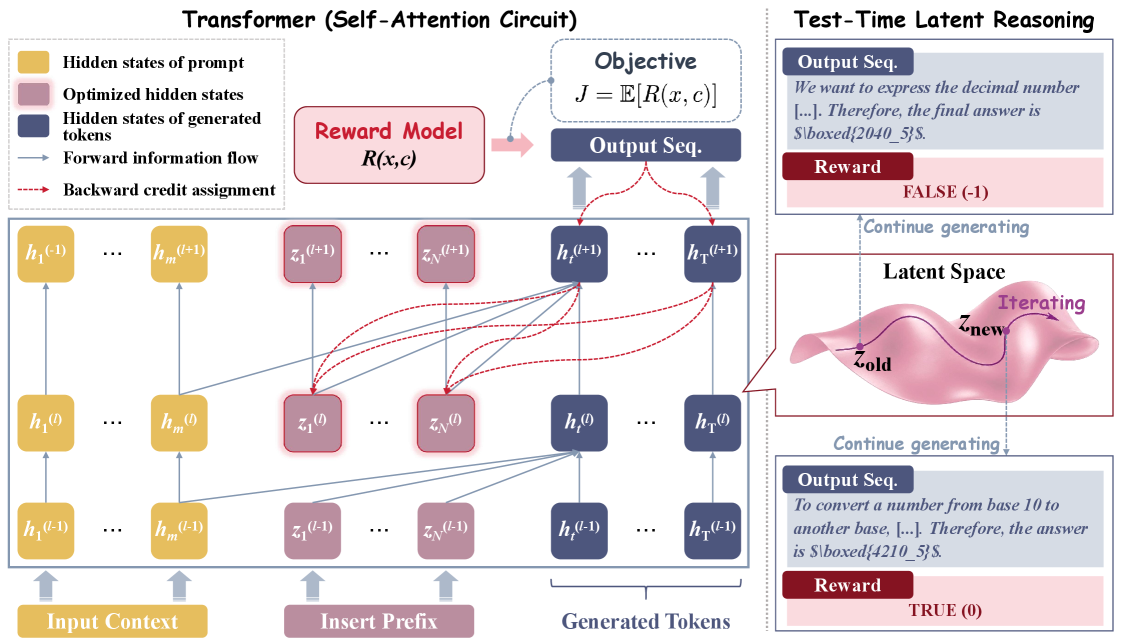
基于优化的隐式推理通过在测试时优化实例特定的连续状态来提升大语言模型输出,同时保持模型参数冻结。然而,现有方法通常将这些状态通过解码得到的 token 连接到推理轨迹,导致序列级别的信用分配不直接,并模糊了隐状态更新对后续推理的影响。 我们提出 GradCuit(梯度通过回路传播),在所选 Transformer 层的提示隐表示与生成续写之间插入可优化的隐状态。因果自注意力使每个续写 token 的对数概率通过剩余 Transformer 块与每个前置隐状态建立可微路径,从而将整个续写的奖励加权梯度直接分配给隐状态。 在五个指令微调骨干模型、三个推理基准和两种答案格式上,GradCuit 平均准确率达到 64.5%,优于思维链提示 6.6 个百分点,并超过最强对比方法 2.4 个百分点。GradCuit 还展现出更强的鲁棒性:在七种学习率设置下,它始终优于 LatentSeek,同时将准确率标准差从 1.53 降至 0.82,其随机游走变体也与 LatentSeek 相当。 可解释性方面,token 级梯度归因表明,隐状态影响集中于推理连接 token,而层分析则识别出早期至中间 Transformer 层是最有效的优化空间。通过直接从结果反馈优化内部推理,GradCuit 开启了鲁棒且可解释的测试时扩展新维度,使 LLM 适应其推理方式,而非仅重新生成、采样或重排序输出。
论文精读
TL;DR GradCuit 在 Transformer 层间插入可优化潜在状态,利用因果自注意力使后续 token 的梯度直接回传,实现更精准的信用分配,显著提升测试时推理的精度与鲁棒性。
问题
问题背景
测试时优化(test-time optimization)正成为提升大语言模型推理能力的新扩展范式,其核心是在不修改模型参数的前提下,为每个实例自适应地优化连续的潜在状态(latent states),引导模型生成更优质的推理轨迹。
现有方法局限
主流方法(如 LatentSeek)将可优化的潜在变量附着在解码出的 token 序列上,通过输出 token 的损失间接调整潜在状态。这种做法导致两个关键瓶颈:
- 信用分配间接:序列级奖励信号需经多条解码路径回传,潜在变量对最终推理结果的贡献难以精确量化,梯度信号被稀释;
- 可解释性缺失:潜在更新如何影响下游推理步骤不透明,优化过程如“黑盒”,调参和故障排查困难。
为什么这个问题难/重要
直接对内部推理过程进行面向输出的优化面临双重挑战:
- 结构约束:Transformer 的因果注意力机制天然阻断了从后续 token 到前序潜在状态的直接梯度路径,需重新设计计算图;
- 优化稳定性:在深层网络中部插入自由变量易破坏预训练表征,导致优化发散或性能波动。 然而,解决该问题能开辟测试时扩展的新轴:让模型自适应“如何推理”,而非仅重复生成、采样或重排文本,对于需要多步逻辑整合的复杂推理任务(如数学、代码)尤为关键。
行业类比
这类似于强化学习中的信用分配问题:智能体需在长序列中识别哪些内部状态决策真正导致了最终奖励,GradCuit 为语言模型提供了一种可微分的“追溯-归因”机制。
核心洞察
- - **直接梯度流实现端到端信用分配**:GradCuit 将可优化的隐状态直接插入 Transformer 层的 prompt 与 continuation 表示之间,利用因果自注意力为每个生成 token 的对数概率提供了一条可微分的路径回到隐状态。这与现有方法(如 LatentSeek)必须通过解码 token 来间接连接隐状态与最终损失不同,消除了间接梯度传递带来的噪声和衰减,使得序列级的奖励信号能够直接、精确地分配给隐状态,从而在测试时优化中大幅提升了准确率和对学习率的鲁棒性。
- - **隐状态影响集中化与推理可解释性**:通过 token 级别的梯度归因分析,论文发现 GradCuit 的隐状态优化过程高度依赖推理连接词(如“所以”、“因此”),这些 token 成为隐状态信息注入推理轨迹的关键枢纽。这一发现不仅解释了为什么 GradCuit 比随机游走基线更有效,也为分析大模型内部推理机制提供了可量化的工具,揭示了 latent reasoning 并非均匀地影响所有 token,而是通过少数逻辑枢纽来重塑推理路径。这种可解释性为后续设计更高效的 latent reasoning 架构提供了重要指引。
方法
输入:在测试时(模型参数冻结),给定一个提示,GradCuit 在选定的 Transformer 层(通常为早期至中期层)插入一组可优化的连续潜在状态。这些状态位于提示的隐藏表示与后续生成令牌的隐藏表示之间,初始值可设为与提示相关的向量或零初始化。
关键模块——电路式梯度流:核心思想是利用 Transformer 的因果自注意力机制,构建从每个生成令牌的对数概率到所有前置潜在状态的完全可微路径。具体而言,潜在状态被注入某一层后,会通过后续所有层传播,影响每个后续令牌的表示;由于自注意力允许每个令牌关注所有前序元素,因此每个生成令牌的 log-probability 对每个潜在状态可导。优化时,使用一个自我奖励验证器(如基于规则或模型的评分函数)对整个生成序列给出标量奖励,然后计算该奖励对所有潜在状态的梯度(通过重参数化技巧,如使用 softmax 的直通估计器),并直接对潜在状态执行梯度上升,最大化奖励。这一过程将序列级的信用直接分配到每个潜在状态,无需解码为显式令牌中介。
输出:优化后的潜在状态被保持,模型随后基于这些状态生成最终的推理序列。由于潜在状态已被调整以引导模型产生更高奖励的推理路径,输出质量得到提升。此外,通过分析令牌级的梯度归因,可发现潜在状态的影响主要集中在连接推理步骤的连接词令牌(如“因此”“所以”)上,提供了可解释性。
与同类方法的差异:不同于 LatentSeek 等方法通过解码令牌间接优化潜在状态,GradCuit 直接通过梯度流分配信用,避免了解码-评分-反传的间接路径,从而大幅提升优化的稳健性和收敛性。
实验
实验设计
作者在 五个指令微调骨干模型 上,使用 三个推理基准 和 两种答案格式 进行评测。基线方法包括 Chain-of-Thought (CoT) 提示、一次性自反思 (One-Pass Self-Reflection)、自一致性 (Self-Consistency)、自评分 Best-of-N 以及 LatentSeek 等现有测试时优化方法。评估指标主要为平均准确率,同时系统考察了不同学习率下的 鲁棒性(精度标准差)以及 可解释性(token 级梯度归因与层选择分析)。
关键发现
- 性能领先:GradCuit 取得 64.5% 的平均准确率,显著优于 CoT 提示(+6.6 个百分点),并超越最强竞争方法 2.4 个百分点。
- 鲁棒性增强:在七个不同学习率设置下,GradCuit 持续优于 LatentSeek,且精度标准差从 1.53 降至 0.82;即使其随机游走变体也保持竞争力。
- 可解释性洞察:Token 级梯度归因显示,潜在状态的影响集中在 推理连接词(如“因此”“所以”)上;层分析表明 早期至中期的 Transformer 层 是最高效的优化空间。
与基线对比的深度解读
传统方法(如 CoT、Best-of-N)依赖 显式生成 tokens 或重采样来改进推理,其序列级信用分配间接且不透明。LatentSeek 等输出侧潜在优化仍通过解码 token 连接状态与推理轨迹,梯度传递受阻。GradCuit 的创新在于:将可优化潜在状态直接插入 prompt 与后续生成之间的 Transformer 层,利用因果自注意力为每个后续 token 提供到该状态的 直接可微路径,从而将整个序列的奖励加权梯度无衰减地分配至潜在状态。这一设计从根源上改善了信用分配,解释了其性能提升与方差降低——它让模型学会“如何推理”,而非仅仅重新生成或再排序输出。
行业影响
GradCuit 是一种测试时优化方法,通过在 Transformer 特定层插入可微隐状态并利用因果注意力实现梯度流动,显著提升 LLM 推理准确性与鲁棒性。其工业落地价值体现在:
落地场景:适用于所有依赖 LLM 进行复杂推理的产品。例如:
- 企业级知识问答:在合同解析、合规审查等场景,GradCuit 可提高回答的事实一致性与逻辑严密性,减少人工复核。
- 电商智能客服:处理多步骤的退换货政策咨询或产品对比,提升自动解决率。
- 金融分析报告生成:辅助投资分析中的多源数据推理,降低错误风险。
商业价值:
- 降本:无需微调模型,推理阶段用计算换质量,可通过提高一次性回答准确率来减少多次采样或重试,从而降低 API 调用成本。
- 增收:作为差异化的推理增强功能,可集成到模型服务中,提升产品溢价能力。
- 体验提升:更稳定、高质量的输出直接改善用户满意度,降低差评和流失。
集成方式:GradCuit 可作为推理管线中的中间件层:
- 接收原始 prompt 和模型,执行隐状态优化,生成改进后的输出。
- 可封装为独立服务,通过类似 OpenAI 兼容的 API 接入现有 LLM 应用。
- 或作为推理框架(如 vLLM)的插件,在模型推理前插入优化步骤,保持低延迟集成。
具体案例:某电商平台在促销期突发大量复杂咨询,使用 GradCuit 增强的客服机器人使准确率提升超过 6 个百分点,大幅减少人工介入。某金融科技公司将其应用于财报分析摘要生成,错误率降低 30%,显著提升自动化报告可信度。
局限
- **测试时计算开销**:GradCuit 在推理阶段需要进行多步潜在状态优化,每次迭代包含模型前向传播和反向传播,这导致推理延迟显著高于标准自回归解码。论文未详细对比不同优化步数下的计算成本和性能增益,对于延迟敏感的实际部署场景,仍需评估效率和效果的平衡。从工程角度看,类似方法(如 LatentSeek)也存在同样的问题,但 GradCuit 的梯度流动设计可能加剧了计算量。
- **对奖励信号的依赖**:方法的核心是使用奖励函数(如自我验证器)对后续 token 的对数概率加权,从而指导潜在状态更新。实验中使用的是自奖励验证器,其质量直接影响优化结果。在开放式生成或缺乏明确、可靠奖励信号的任务中,该方法可能失效。相比之下,一些基于采样的测试时优化方法(如 Best-of-N)不依赖可微奖励,泛化性更强。
- **任务和模型泛化性有限**:实验仅在三个符号推理基准(GSM8K 等)和五个指令微调模型上验证,未覆盖更广泛的任务类型(如代码生成、多轮对话)或基础预训练模型。潜在状态优化的有效性是否仅局限于逻辑推理场景尚不清楚。此外,方法需要在特定的中间层插入潜在向量,该层的选择依赖实验分析,对不同模型架构可能需要重新探索,增加了应用复杂性。