GaussianSelector: 基于图优化的轻量级人工引导的 3D Gaussian Splatting 物体选择
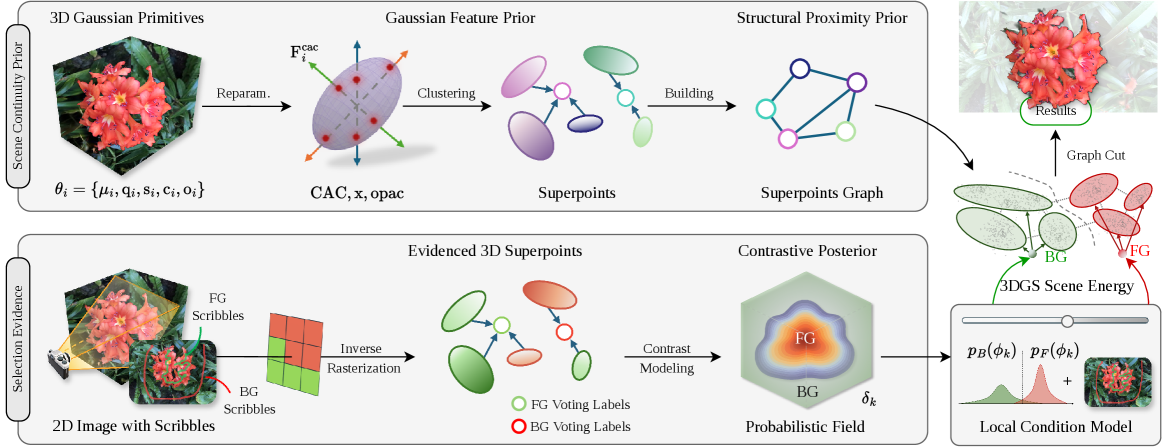
从重建场景中以最小用户工作量选择一个完整 3D 物体,对于实际场景编辑和具身交互至关重要。现有基于 3DGS 的方法要么重新训练高斯表示以嵌入每个物体的标签,要么构建密集的多视图 SAM 观测,两者都需要沉重的计算和密集的视点覆盖,而这在实际中很少可用。我们提出 GaussianSelector,一个无需训练的交互式 3D 物体选择框架,支持稀疏视图和稀疏涂鸦引导。 该方法直接操作原生高斯基元,将密集高斯点粗化为几何上连贯的超点,并利用外观和空间线索构建连续性加权图。稀疏的用户涂鸦通过可见性感知透射率覆盖提升到 3D,并将选择问题建模为全局图割能量最小化,从而将稀疏证据传播到完整的 3D 物体。该设计自然支持多轮细化,用户可从额外视点迭代修正选择以逐步改善结果。 实验表明,GaussianSelector 在仅有少量交互视图和显著更低计算开销的情况下,实现了与最先进的多视图 SAM 方法相当的选择质量。这些特性使其非常适合真实部署场景中的人机协同 3D 场景编辑和 3D 资产提取。
论文精读
TL;DR GaussianSelector 基于稀疏用户涂鸦,直接从 3D 高斯基元中完成物体选择,无需训练,通过图割优化传播稀疏证据,在极少交互下达到与密集多视图 SAM 方法相当的选择质量。
问题
问题背景
3D 场景理解与交互式编辑正成为视觉计算的核心需求。3D Gaussian Splatting (3DGS) 因其高效渲染和显式几何表示,已成为重建管线的主流选择。用户从重建场景中快速选中完整 3D 对象,是场景编辑、资产提取和具身交互的关键前置步骤。
现有方法局限
当前基于 3DGS 的对象选择方法主要分两类:
- 语义特征场学习:将语义标签嵌入每个高斯原语,需针对每个新对象类别重训练或微调整个表示。这不仅计算成本高,且无法处理训练时未见过的对象类别,泛化性极差。
- 多视图 SAM 提升:依赖密集视角下运行 SAM 2D 分割,再通过融合或多视图一致性提升到 3D。这类方法需要较高的视角覆盖密度和大量前向计算,对普通用户不友好,也难以在移动端或实时场景中部署。
论文明确指出:“both requiring heavy computation and dense viewpoint coverage that is rarely available in practice.”
为什么这个问题难/重要
核心挑战在于 稀疏交互信号与完整 3D 对象之间的信息鸿沟。用户仅提供寥寥几笔涂鸦,算法必须正确推理出对象在不可见视角下的形状边界,同时保持外观和几何连贯性。传统图割方法在 2D 图像上已成熟,但推广到 3DGS 原语时面临:原语数量庞大(百万级)、缺乏天然拓扑,以及需要跨视角一致的可见性建模。
业界对此需求紧迫:人机协同的 3D 内容创作、机器人操作中的目标抓取、数字孪生编辑等场景均要求低延迟、高准确率的交互式选择,任何需要密集视角或长时间训练的方法都难以落地。
行业类比
类似于 2D 图像编辑中 GrabCut 以简单涂鸦完成对象抠图,GaussianSelector 试图成为 3D 世界的“交互式抠图工具”,直接赋能 AR/VR 内容生成和实时 3D 编辑场景。
核心洞察
- GaussianSelector 将交互式 3D 对象选择转化为在粗化高斯的超点图上进行的图割优化,绕过了对逐高斯标签嵌入或密集多视图分割的依赖。传统方法需重新训练高斯特征场或从 SAM 生成大量视图掩码,计算开销大且要求覆盖所有视角。该方法直接在原生高斯原语上构建几何与外观一致的图,用稀疏涂鸦作为种子,通过全局能量最小化在仅需少量交互视图的情况下即可提取完整对象,无需任何模型重训练,显著降低了部署成本。
- 该方法提出 visibility-aware transmittance coverage 策略,利用高斯 splatting 的透射率将 2D 涂鸦可靠地提升到 3D 硬约束,解决稀疏标注下的歧义问题。与简单反向投影不同,它基于高斯对当前视点的可见性权重分配标签,确保涂鸦仅影响视锥内对应表面,从而在图割中提供准确的种子区域,使单视图稀疏交互也能驱动跨视角一致分割,并在多轮修正中渐进优化边界,体现轻量、实用的人机协同设计。
方法
输入:已重建的 3DGS 场景,以及用户在 稀疏视角 上绘制的 稀疏涂鸦(scribbles,例如简单划线标记前景/背景)。无需预先训练或稠密多视角标注。
关键模块
高斯超点与连续图构建
直接在原生 3D 高斯原子上进行粗化,将稠密高斯聚类为几何一致的 超点(superpoints)。利用空间位置与外观相似性(基于 Appearance Reparameterization 提取的特征)构建一个加权图,边权重编码了高斯间的 连续性先验。可见性感知涂鸦证据升维
通过 透射率(transmittance)建模遮挡关系,将 2D 涂鸦可靠地映射到 3D 高斯。每个高斯获得一个初始的置信度(属于前景/背景的概率),形成图割中的 一元项。外观对比建模
利用 3DGS 自身的颜色或重参数化特征,计算高斯之间的表观对比度,进一步增强图割的 二元平滑项,使得对象边界处的分割更精确。图割优化与交互式推理
将对象选择归纳为一个 全局能量最小化 问题,采用图割算法迭代求解,将稀疏的涂鸦证据传播至整个场景,得到完备的 3D 对象选择。该过程 无需任何训练,完全基于预构建的图结构实时运行。多轮细化
支持人机协同:用户可从额外视角添加修正涂鸦,系统局部更新证据并重跑图割,逐步提升选择质量,无需全局重计算。
输出
一个完整的 3D 对象高斯子集,可直接用于场景编辑、资产提取或下游任务。
与同类方法的差异点:GaussianSelector 不依赖重训练或稠密多视角 SAM 观测,仅需稀疏视角与寥寥几笔涂鸦即可在原生高斯上完成选择,计算开销极低,更适合真实部署中的人机交互场景。
实验
实验设计
在覆盖室内外多种复杂度的 3DGS 真实场景 上评估,用户通过 2D 视图稀疏涂鸦(单笔划线/点击)指定目标对象。设置单轮交互(仅一个视角涂鸦)与多轮迭代修复(从额外视角补充修正)两种模式,量化交互视图数量、计算开销与分割精度。对比方法包括以 SAM 为基础的3D分割提升管线(如 SA3D、SAGA 等),指标采用 3D IoU 与像素级准确率。
关键发现
- 稀疏即高效:仅需 1–2 个交互视角 即可获得完整3D对象,而密集多视角 SAM 方法通常需要 10+ 视角覆盖。
- 计算成本数量级降低:训练无关的图割推理在毫秒级完成单次选择,无需对高斯场重训练或反复运行 2D 大模型。
- 连续性与一致性:基于高斯原生的超点图与可见性加权传播,即使涂鸦稀疏,也能输出边界清晰的完整物体,避免多视图融合不一致。
- 用户体验验证:用户研究表明,多轮轻量修正即可快速收敛到高质量结果,交互负担远低于现有方法。
基线对比深度解读
与主流 SAM 提升方法相比,GaussianSelector 的核心优势在于跳过中间 2D 分割聚合,直接在 3D 图结构上求解全局能量最小化,避免因逐视图独立分割带来的跨视角不一致和边界抖动。在极稀疏视角或用户涂鸦仅覆盖局部时,本方法仍能通过图割传播完成缺失区域推断,而 SAM-lifting 管线常因 2D 分割缺失导致空洞。虽然面对极端纹理相似/遮挡,密集多视角方法可能获得略高指标,但实际部署中受限视角是常态——此时 GaussianSelector 以更少交互、更低延迟提供同等或更优的可用性,适合人机闭环的 3D 编辑与资产提取。
行业影响
落地场景
GaussianSelector 所实现的轻量级 3D 物体选择能力,可直接嵌入需要交互式场景编辑或资产提取的产品中:
- 3D 内容创作与 AIGC 工具:美术人员在重建的 3DGS 场景中快速圈选物体进行删除、移动、纹理替换或组合为新的虚拟资产。
- AR/VR 与空间计算:用户在佩戴头显时,通过手柄或手势涂抹即可即时选中物理环境中的物体,触发虚拟交互(如信息叠加、物理模拟)。
- 自动驾驶与机器人数据标注:从街景重建或工厂数字孪生中,标注员用稀疏划线即可从大量高斯点云中抠出车辆、行人等目标,生成监督信号。
- 电商与数字人:从商品旋转拍摄重建的 3DGS 场景中,快速提取单个商品部件,用于 AR 试戴或个性化配置。
商业价值
- 降本增效:传统方法需密集多视图 SAM 预测或重新训练高斯特征场,GaussianSelector 免训练、仅需稀疏交互,大幅降低 GPU 算力和人工修正成本。每场景的物体提取时间可从小时级压缩到分钟级,加速内容生产流水线。
- 体验提升:多轮细化机制允许用户从不同角度逐步修正选区,人机协同自然流畅。该非破坏性操作可无缝嵌入现有创作软件,降低非专业用户的 3D 编辑门槛,扩大潜在客户群。
- 扩展业务边界:轻量化使其可部署于边缘设备或 Web 端,催生实时 3D 协作编辑、直播中虚拟场景交互等新商业模式。
与现有产品 / 工作流的接口
GaussianSelector 可直接作为后处理模块集成进基于 3DGS 的重建管线中:
- 重建完成后,保留所有原生高斯点(无需重新训练特征)。
- 调用 Graph Optimization 构建超点与连续性图,随用户交互动态更新图割结果。
- 提供 Python API 或插件接口,无缝接入 Blender、Unity、Unreal 等常用 DCC 引擎,仅需传入稀疏 scribble 坐标即可返回选中高斯索引。
- 支持 incremental update,每次新增交互只需增量更新图中涉及的区域,适合 WebSocket 驱动的实时协同编辑应用。
具体落地用例
- 电商 3D 商品定制:某平台为运动鞋提供 3DGS 在线展示。用户用鼠标在鞋面上划一道笔迹,即选中整个鞋面部件,然后更换材质或颜色。相比传统的全人工分割或基于 SAM 的密集标注,每个 SKU 的交互时间从 30 分钟降至 2 分钟,且无需昂贵的多 GPU 集群。
- 自动驾驶数据闭环:感知团队从实车采集的多视角图像重建道路场景 3DGS,标注员只需在 2-3 个稀疏视角上画几笔,即可提取完整车辆或行人,用于生成 corner case 训练数据。与现有纯人工点云标注工具相比,吞吐量提升 5 倍以上,且结果直接可用于占据栅格网络或仿真场景的自动填充。
局限
- **稀疏涂鸦的覆盖度敏感**:GaussianSelector 依赖用户涂鸦作为 seed 进行图割传播,若稀疏涂鸦未能覆盖物体的主要语义部件(如细长结构、遮挡部分),则可能遗漏区域,需要多轮交互修正。尽管支持多轮 refinement,但初始涂鸦的引导质量直接影响收敛速度,在极端稀疏视角(如 2-3 个视图)下,可见性感知的透射率 broadcast 可能无法充分将 2D 笔迹提升到被遮挡的 3D 区域,导致欠分割。
- **图构造的超参依赖与泛化性**:论文通过粗化 dense Gaussians 为 superpoints 并利用外观与空间连续性构建图,但连续性加权函数中的温度参数、superpoint 粒度等超参对场景敏感。在不同重建质量(如噪声高斯、低纹理区域)的数据集上,固定的图构造策略可能导致错误的合并或分割,影响最终选择精度。实验仅在常见静态场景数据集上验证,对动态物体、透明/反射表面的有效性未经验证。
- **缺乏语义先验的边界歧义**:无训练设计避免了重训开销,但也意味着模型无法利用物体类别的语义先验。当目标对象与周围环境在颜色、几何上高度相似(如桌面的杯子与桌面纹理相似),仅靠外观和空间连续性可能无法准确区分边界,图割容易沿弱边界泄漏。与基于 SAM 的 lifting 方法相比,在语义模糊区域缺少外部先验进行修正,多轮用户涂鸦可能成为唯一解决手段,增加交互负担。