Motion Beyond Morphology: 超越形态的运动——从抽象运动表示引导跨类别运动迁移
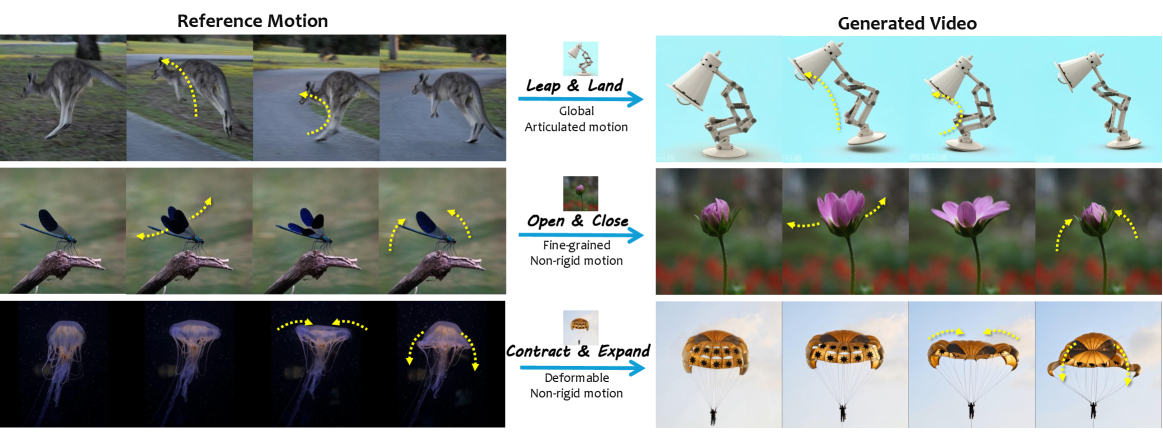
视频运动迁移旨在利用参考视频的动态来驱动目标对象。现有方法大多依赖固定的结构对应,当参考与目标对象在形态、关节或变形机制上差异显著时,这种对应变得不明确。我们提出 Motion Beyond Morphology 视角,旨在超越固定结构对应,保留跨不同目标形态仍有意义的动态。 为此,我们提出两阶段框架。阶段 I 学习互补的多粒度抽象运动视图,并利用它们引导跨类别视频对,保留跨多样形态的可迁移动态。阶段 II 将该监督内化为直接的参考视频条件生成,移除推理时显式运动提取的需求。 我们进一步推出 OpenVMT-Dataset 和 OpenVMT-Bench,用于训练和评估跨 Same、Near、Far 类别差距的图像与文本条件运动迁移,并计划在接收后发布。大量实验表明,方法在运动保真度和目标保留方面达到最先进水平。
论文精读
TL;DR 突破固定结构对应,利用多粒度抽象运动表示自举跨类别运动迁移,实现无需显式运动提取的端到端生成,性能达 SOTA。
问题
问题背景
视频运动迁移旨在将源视频中的动态赋予目标对象,同时保持目标的外观与场景。随着扩散模型在视频生成领域的发展,可控且精准的运动迁移成为研究热点,但当前方法大多局限于同类别或相似形态的对象之间。
现有方法的局限
主流方法可分为基于结构对应的动画和基于参考视频的运动迁移。前者依赖显式结构先验(如人体骨骼、面部关键点),仅适用同拓扑对象;后者通过光流或点轨迹引导生成,但光流是稠密像素位移,点轨迹需长序列可追踪,两者均假设源与目标存在明确的几何对应。当源与目标在形态、关节、变形机制上差异显著时(如从狗游泳迁移到窗帘飘动),固定结构对应变得无定义,导致运动失真或外观崩溃。稀疏关键点方法面对非刚体与显著形变时泛化不足,密集对应方法计算开销大且跨类别能力弱。
挑战与重要性
跨类别运动迁移的核心难点在于,需从参考视频提取与形态无关的通用运动表征,它应捕捉动态的本质(如节奏、方向、形变模式),又能适配任意目标几何。这要求模型解耦运动与外观,建立高层语义运动空间。业界对通用运动迁移需求强烈:影视特效、虚拟角色驱动、机器人仿真数据生成等场景,常需将一种运动赋予完全不同的物体。现有视频生成模型虽性能强大,但运动控制仍依赖文本提示,难以精确移植参考运动。
行业类比
这与图像风格迁移从纹理合成过渡到语义级风格迁移类似;跨类别运动迁移可视为“运动风格迁移”,将运动的抽象模式从一种形态剥离,应用到另一种形态,有望成为视频编辑领域的通用基础能力。
核心洞察
- 运动迁移的形态无关性:传统方法依赖关键点或骨架等固定结构对应,导致源与目标形态差异较大时运动迁移失效。本文提出从原始视频中学习互补的多粒度抽象运动表示(语义运动学、深度轨迹、稠密点跟踪、6-DoF 轴、边缘等),以描述与物体形态无关的运动本质,从而支持跨类别(如从四足动物到台灯)的运动迁移,突破了结构先验的限制。
- 自举式跨类别监督生成:由于缺乏跨类别运动迁移配对的标注数据,论文设计了两阶段框架:第一阶段利用抽象运动编码器从单类别视频中自动生成合成跨类别视频对,第二阶段将其内部化为直接以参考视频为条件的生成模型,推理时不再需要显式运动提取模块。这种自举策略绕过了昂贵的手工标注,同时将运动解耦与生成一体化,简化了实际部署流程。
方法
输入与总体流程
Motion Beyond Morphology 是一个两阶段框架,用于跨类别视频运动迁移。输入包含一段参考视频(提供运动动态)和一个目标条件(可以是图像或文本),输出为目标对象按照参考运动动态生成的视频。核心挑战在于参考与目标可能属于完全不同的类别(如猫和机器人),两者在形态、关节和变形机制上差异巨大,传统基于固定结构对应的方法会失效。
Stage I:抽象运动引导的跨类数据自举
Stage I 的关键是从参考视频中提取多粒度抽象运动视图(Multi-Granularity Abstract Motion Views),作为形态无关的运动表征。这些视图包括:
- 语义运动学:捕捉对象部位的语义级运动(如“摆动”);
- 深度感知全局轨迹:场景级三维全局运动;
- 稠密点轨迹:像素级长期运动对应;
- 6-DoF 轴:刚体变换的六自由度参数;
- 边缘:轮廓形状随时间的变化。
这些互补视图共同构成对“运动本质”的刻画,剥离了具体纹理和形状。随后进行抽象运动接地(Abstract Motion Grounding),利用这些运动表征在大量无配对数据中搜索并生成跨类别运动-目标对(cross-category video pairs),例如“一只猫跳起”的运动对应“一个玩具汽车弹跳”。生成过程通过运动一致性筛选(cross-category pair filtering)保证迁移的动态在目标形态下仍然合理。此阶段实际上自动构建了跨形态的运动迁移训练监督。
Stage II:跨类别运动内部化生成
Stage II 采用一个条件视频生成模型(如基于扩散模型),直接在 Stage I 产出的跨类别数据上进行端到端训练。模型输入为参考视频和目标条件(图像/文本),通过内部隐式学习将参考视频中的抽象运动模式映射到目标对象的视觉空间,无需在推理时显式提取任何运动表示。这种设计使得推理阶段可以直接进行参考视频条件生成,避免了运动提取模块的误差累积和跨类别适配难题。
与同类方法的差异
现有方法大多依赖结构对应(如关键点、骨骼或光流),当参考与目标类别差距较大时,结构对应难以建立或定义模糊。本工作则绕过显式对应,从数据层面自举出跨类别的运动迁移监督,并利用多粒度抽象运动作为中介,实现了真正意义上的跨形态运动保持。
实验
实验设计
作者构建了 OpenVMT-Dataset 和 OpenVMT-Bench,分别用于训练和评估。数据集与基准按形态差距划分为 Same(同类)、Near(近类)和 Far(远类)三个层次,覆盖图像和文本两种条件模式下的运动迁移任务。基线方法包括基于结构关键点的传统动画技术和基于参考视频的运动迁移方法。评估指标主要围绕运动保真度和目标外观保持。
关键发现
- 跨类别运动迁移可行性:通过 Stage I 学习的多粒度抽象运动视图(语义运动学、深度全局轨迹、稠密点轨迹、6-DoF 轴、边缘),模型成功提取了与具体形态解耦的可转移运动表征,并在跨类别视频对生成中实现运动引导自举。
- 端到端生成简化:Stage II 将 Stage I 的监督信号内部化至生成模型,使推理阶段直接以参考视频为条件,无需显式运动提取模块。
- 性能优势:在 Same、Near、Far 三种差距设定下,本文方法均取得了最优的运动保真度和目标外观保持,消融实验验证了多粒度视图的互补性及两阶段训练的必要性。
与基线的深度对比
传统运动迁移依赖固定结构对应(如关键点、骨架),当参考与目标对象在形态、关节或形变机制上差异显著时,这种对应失效,导致运动失真或目标外观破坏。本文从“运动超越形态”视角出发,不要求结构对应,而是利用抽象运动表征保留有意义的动力学信息。通过自举生成的跨类别配对数据,模型学到了跨形态的运动先验,显著提升了大形态差距下的生成质量,这是现有方法无法实现的突破。
行业影响
落地场景
Motion Beyond Morphology 打破了传统 motion transfer 对源物体与目标物体的形态、关节结构一致性的依赖,能将任意参考视频的运动动态迁移至差异巨大的目标对象上(如动物、植物、人造物)。这意味着该技术可广泛应用于:
- 内容创作工具:低门槛生成“让任意图片动起来”的视频素材,用于社交媒体、广告、影视预演。
- 虚拟试穿与交互式展示:将模特走秀动作迁移到服装平铺图、3D 模型或甚至静物产品上,实现非人形商品的动态展示。
- 教育/科普可视化:让静态图表、示意图、解剖模型按指定运动序列动态演示过程。
- 电商与营销:将爆款视频的运镜/主体动态直接套用到不同品类商品图,批量生成多样化短视频广告。
商业价值
- 降本:无需为每个新品类/新形态物体重新训练适配模型或手工制作骨架对应,减少了跨类别 motion transfer 的定制开发成本。Stage II 的 internalization 免去了推理时的显式运动提取,进一步降低计算开销。
- 增收:提升内容生产速度和多样性,使平台能够快速响应热点、批量生成广告变体,直接拉动广告消耗与转化。
- 体验提升:在 UGC 工具中,用户仅需提供一张图片和一段参考视频,即可生成动态效果,大幅降低创作门槛,增强用户黏性。
与现有工作流的接口
该框架可封装为推理 API 或 SDK 集成进现有视频生成管线:
- 输入:一张目标图像(或文本描述)加一段参考运动视频。
- 内部:Stage II 模型直接基于参考视频生成运动一致的视频,无需额外运动估计模块。
- 输出:动态视频,可被下游编辑工具(如 After Effects、剪映)或自动化投放系统直接消费。 训练阶段使用的 OpenVMT-Dataset 和评估基准 OpenVMT-Bench 也可作为企业内部数据引擎的标准,用于持续迭代。
具体落地 Use Case
- 电商视频生成:某时尚平台需为上万款服饰生成走秀短视频。通过本技术,可用同一条专业模特走秀参考视频,将运动迁移到不同服装的平铺图或衣架图,生成逼真的动态效果,无需为每件衣服单独聘请模特拍摄。
- 社交媒体滤镜与特效:内容平台推出“任意图像变身舞者”功能,用户上传个人照片或宠物照,选择流行舞蹈参考视频,即可生成跟随节奏律动的个性化短视频,驱动病毒式传播与日活跃度增长。
局限
- **抽象运动表示对非刚性 / 流体运动的泛化受限**:论文提出的多粒度抽象运动视图(语义运动学、深度轨迹、点跟踪、6-DoF 轴、边缘等)主要针对可明确定义关键点或轮廓的刚性 / 铰接物体设计,对于烟雾、水流、毛发等高度变形或拓扑变化的非刚性运动,这些表示难以完整刻画其动力学本质,导致在跨类别迁移时出现伪影或运动语义丢失。实验部分虽然覆盖了 Same、Near、Far 类别间隙,但未见对流体、粒子系统等极端形态差异的评估,实际部署时需要针对特定运动域重新设计抽象视图。
- **远类别间隙下运动保真度与目标保留的折中不足**:尽管 Stage I 通过抽象运动自举生成跨类别视频对来弥合形态差异,但在 Far category gap(如人类动作迁移至机械臂)场景中,抽象运动表示与目标外观之间的矛盾仍可能导致形变扭曲或细节模糊。论文的消融实验和量化指标表明,随着类别间隙增大,运动迁移精度(如 FVD、Motion Fidelity)和目标保留度(如 LPIPS)呈下降趋势,说明框架对极端形态差异的鲁棒性仍有提升空间,后续可能需要引入更强的语义解耦或适应性形变模型。
- **两阶段训练流程复杂且依赖参考视频,推理灵活性受限**:该方法要求提供显式的参考运动视频,无法从文本描述或其他弱条件直接生成运动,限制了其在创意生成、无监督编辑等场景的适用性。Stage I 的自举过程需要从大量未标注视频中挖掘跨类别运动对,涉及多粒度运动提取、配对与过滤,训练成本高且数据质量依赖人工设计的启发式规则;Stage II 的内部化虽然避免了推理时的运动提取,但整个流程仍然需要额外的参考视频输入,与端到端的文本驱动生成模型相比,部署和交互效率较低。这些设计选择使得该方法在工程落地时需要权衡运动控制精度与使用便捷性。