SG-WAM: 几何感知策略空间中的自引导世界建模
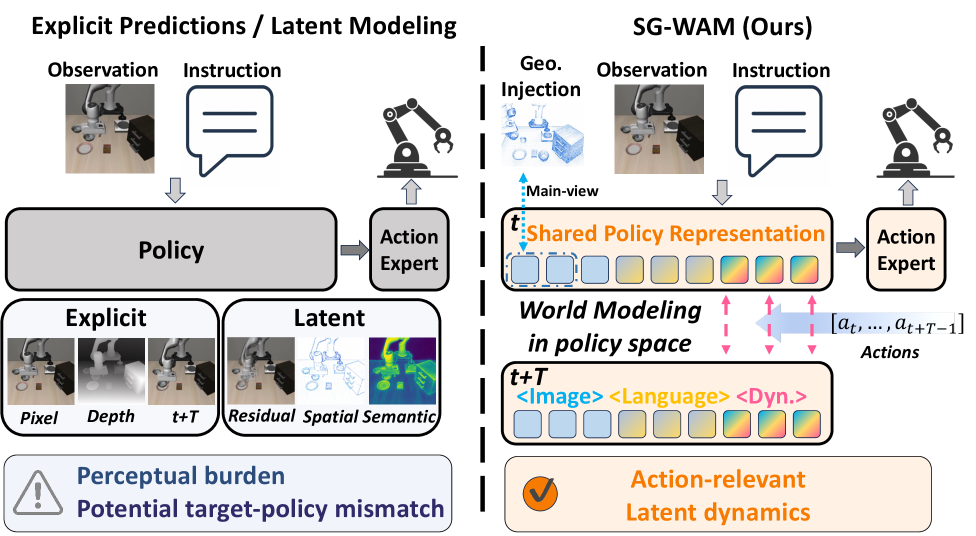
World Action Models (WAMs) 将动作生成与未来状态预测耦合。其有效性取决于未来动态是否在与动作生成对齐且充分几何感知的空间中建模,以捕捉动作在何处以及如何改变场景。现有 WAM 通常只满足部分要求,依赖感知开销大的观测空间目标或辅助潜空间,这些潜空间未针对动作相关性和几何结构进行联合构建。 我们提出 SG-WAM,一种自引导框架,直接在策略导出的表示空间中学习几何感知的动作条件动态。SG-WAM 引入可学习动态令牌和 Self-Guided World Predictor,预测受机器人动作条件影响的未来潜状态。预测目标由同一策略主干的指数移动平均副本生成,在动作专家使用的表示族内提供稳定监督。几何监督进一步结构化策略图像令牌表示,为动态令牌提供空间上下文化,产生与动作相关且几何感知的未来对齐空间。潜未来预测、几何基础和流匹配动作生成在统一框架中端到端联合优化。 基于 0.9B 模型,无需大规模具身预训练,SG-WAM 在 LIBERO 上平均成功率 98.5%,在 LIBERO-Plus 上 73%,在分布内和分布外真实世界评估中均优于强基线。
论文精读
TL;DR SG-WAM 在策略表示空间内自引导学习几何感知的世界模型,用动态令牌和 EMA 预测未来状态,联合流匹配动作生成,在 LIBERO 达 98.5% 成功率。
问题
问题背景
机器人操作领域正积极探索 World Action Models (WAMs),这类模型将动作生成与未来状态预测相耦合,期望通过学习“行动会如何改变世界”来提升策略的物理理解和鲁棒性。
现有方法局限
现有 WAMs 主要沿两条路线构建未来建模空间,但均存在明显短板:
- 观察空间预测 (observation-space WAMs):直接预测未来图像、深度图等,提供密集监督,却迫使模型耗费大量容量去重建纹理、光照、背景等与操控无关的感知细节,导致关键动作动态的建模效率低下。
- 隐空间预测 (latent WAMs):在潜空间建模以避免感知重建负担,但多数方法仅简单预测未来视觉特征,或使用未与 动作相关性 和 几何结构 联合优化的辅助潜空间。这类空间往往缺乏对物体位置、形状和空间关系的显式编码,使得模型难以理解“在哪里交互”和“如何改变场景”。
难点与重要性
设计一个同时满足 动作相关性 与 几何感知 的表征空间极其困难:前者要求表征突出被动作改变的物理状态,抑制无关外观;后者则要求嵌入空间能捕捉位置、形状及接触约束,以支持精确操控推理。传统策略学习中这两个目标是分离的:策略网络专注控制特征,几何信息需额外任务(如深度预测)注入。将它们融合到统一的策略空间,并基于此进行未来预测,不仅能极大提升模型对有限数据的利用效率,还可不依赖大规模具身预训练就获得对环境动态的深刻理解。当前,工业界和学术界高度关注如何将“世界模型”融入策略,以在数据稀缺的真实场景中达到泛化与鲁棒。
这类似于 自监督表征学习 中,若预训练目标仅是重建像素或对比样本,模型可能学到表面统计量;但若加入几何或结构感知的监督(如深度、视图一致性),就能获得更具物理可解释性的表征——WAMs 的未来建模空间也需要类似的精巧设计。
核心洞察
- 自引导世界建模在策略表示空间内直接预测未来状态,通过 EMA 目标提供稳定、动作对齐的监督,避免了观测重建的冗余。与现有 WAMs 不同,它不依赖感知重建或独立潜在空间,而是利用策略自身演化出的表示家族,确保预测与动作生成高度耦合,从而更高效地利用模型容量专注于操控相关动态。
- 几何感知的策略状态通过引入点云或深度等几何监督,结构化策略的图像令牌表示,使动态令牌具备空间背景,进而让未来预测不仅能回答“做什么”也能捕捉“在哪里改变”。这种几何-动作联合优化超越了仅有外观或独立潜在空间的 WAMs,提高了空间推理和泛化能力。
方法
方法详解:SG-WAM
输入:一段观测序列(多视角 RGB 图像)以及对应的机器人动作序列,不依赖大规模具身预训练。
关键模块与处理流程:
几何感知策略状态提取:视觉 Transformer 骨干网络将观测图像编码为图像 token 序列。为赋予策略对三维场景结构的理解,引入几何监督(如深度或三维点云一致性约束)直接优化图像 token 的表示空间,使 token 携带空间位置信息,形成几何感知策略状态。
自指导世界预测器:在策略骨干的潜空间内,插入一组可学习的动力学 token(learnable dynamics tokens)。预测器以当前图像 token、动力学 token 和过往机器人动作为条件,预测未来时刻动力学 token 的潜状态。其预测目标由策略骨干的指数移动平均(EMA)副本生成,提供稳定且与动作分布对齐的自监督信号,避免引入额外的未来观测编码器。
条件流匹配动作专家:将当前几何感知状态与预测的未来动力学 token 拼接,作为动作生成的条件。通过条件流匹配(conditional flow matching)学习从简单先验分布到目标动作分布的变换,直接生成机器人末端执行器的位姿或关节命令。
输出:给定当前观测和历史动作,模型输出实时操控动作,同时内部维护对未来场景演变的隐式预测。
训练目标:端到端联合优化三个目标——动力学 token 的未来预测损失(EMA 自监督)、几何结构损失(如深度回归或对比约束)和动作流匹配损失。
与同类方法的差异:不同于现有 WAM 在繁重的观测空间(如像素或视频)预测未来,或使用与动作生成解耦的辅助潜空间,SG-WAM 直接在策略自身的几何感知潜空间中进行动作条件的世界建模,使未来预测与动作生成共享一致的表征结构,大幅降低感知冗余,集中建模操控相关的场景动力学变化。
实验
实验设计
SG-WAM 在模拟基准 LIBERO 和 LIBERO-Plus 以及真实世界机器人操作任务上进行评估。模拟实验涵盖分布内(in-distribution)评估,真实世界实验额外测试分布外(OOD)泛化。对比基线涵盖现有 World Action Models (WAMs) 中显式未来建模与隐式潜变量方法,具体包括观察空间预测(如视频预测)和潜空间对齐(如特征提取)等代表性工作。评估指标为任务成功率,通过多个随机种子和场景计算平均性能。
关键发现
- 模拟性能:基于 0.9B 参数模型,未使用大规模具身预训练,SG-WAM 在 LIBERO 上达到 98.5% 平均成功率,在更具挑战的 LIBERO-Plus 上达到 73%,显著超越现有 WAM 基线。
- 真实世界泛化:在分布内和分布外真实机器人测试中,SG-WAM 均表现出比强基线更优的操控稳健性,证明其几何感知策略空间世界建模的有效性。
- 消融分析:自引导世界预测(Self-Guided World Predictor)、几何监督(geometry-aware supervision)和条件流匹配动作生成模块的联合优化是性能关键,移除任何组件均导致显著下降。
与基线对比解读
传统 WAM 或依赖感知密集的观察空间预测(如生成未来 RGB 图像),耗费大量容量在操控无关的纹理、背景变化上;或在辅助潜空间建模未来,但未显式约束其与动作生成空间的结构对齐。SG-WAM 直接在策略导出的表征空间中引入可学习动态 token,并通过指数移动平均(EMA)副本提供稳定监督,使得未来预测与动作专家共享表征家族,从根本上保证空间既动作相关又几何可感。这一设计避免了对大规模预训练或冗余外观建模的依赖,在同等模型规模下实现了更高的样本效率与泛化能力,为轻量化具身世界模型提供了一条可落地的技术路线。
行业影响
落地场景
SG-WAM 瞄准机器人操作 (robot manipulation) 的核心难题——让策略在动态环境中理解行动对场景的几何影响。可以直接应用于:
- 工业/仓储自动化:分拣、插装、精密装配等长程任务,尤其适合小批量多品种 (high-mix low-volume) 产线的快速换线。
- 服务机器人:居家/商用环境下的物体移交、桌面清理、抽屉开合等需要感知几何约束的操作。
- 自动驾驶 与移动操作:端到端规划中结合几何感知的行为生成,如自主充电对接、户外物体搬运。
商业价值
- 降本:无需大规模具身预训练 (仅 0.9B 模型),训练数据效率高,可减少对昂贵遥操作采集和标注的依赖,降低机器人技能开发成本。
- 提效:在 LIBERO 基准上平均成功率 98.5%,LIBERO-Plus 达 73%,并展现出优异的分布外泛化 (real-world OOD 测试优于强基线)。这意味着模型更鲁棒、重部署重训频率下降,直接提升机器人有效作业时间 (uptime)。
- 体验:统一端到端优化 (
flow-matching动作生成 + 几何监督 + 潜在未来预测) 使机器人行为更连贯、更具解释性,可支撑人机协作场景的安全信任。
与现有产品/工作流的接口
SG-WAM 可集成进现有模仿学习 或 offline RL 管道:
- 将感知编码器替换为带几何监督的视觉 backbone,输出策略状态和 dynamics tokens。
- 在原有的动作预测模块之上,加入
Self-Guided World Predictor作为辅助任务,采用 EMA 目标稳定训练。 - 动作解码器沿用
Conditional Flow Matching,与现有实时推理栈兼容。 对于使用 ROS/ROS2 的系统,可将 SG-WAM 封装为独立节点,接收传感器流、输出关节/末端执行器指令,与运动规划、力控等模块松耦合。
具体落地 use case
- 电商仓储分拣:面对每日变化的 SKU 和容器位姿,机器人需泛化抓取策略。SG-WAM 的几何感知世界模型能在少量示范数据后,稳健处理未见过的物体形状和堆叠关系,降低因频繁重训导致的停线成本。
- 3C 精密组装:手机/可穿戴设备装配中,细小零件的插接需要理解空间约束。模型通过自引导预测动力学 token,可提前验证动作可行性,避免刚性碰撞,提高首次成功率。
局限
- 几何监督的有效性高度依赖深度信息或预训练特征的质量。在纹理稀疏、反光或透明物体场景中,几何线索可能不准确,导致策略表示空间中的空间结构弱化,影响动态 token 对场景几何的建模。论文在真实世界实验中使用了多种物体,但未明确分析此类极端材质下的性能边界。
- 自引导世界预测器依赖 EMA 副本生成预测目标,当策略网络更新较快时,EMA 目标可能产生滞后,使得动态预测与当前策略表示之间存在分布漂移。虽然联合训练与流匹配动作生成可能缓解该问题,但在长时间训练或高非平稳环境下的稳定性仍缺少实验验证。
- 模型容量受限:SG-WAM 基于 0.9B 参数的单一网络,未进行大规模预训练,在 LIBERO-Plus 上成功率降至 73%,且在真实世界 OOD 场景中可能表现出对特定视觉背景或操作模式的过拟合。此外,动态 token 数量固定,难以自适应地调整对场景不同区域的关注,在复杂多物体交互或长周期任务中可能面临表征瓶颈。