可解释的感知言语 MEG 解码:皮层源与驱动检索的刺激特征
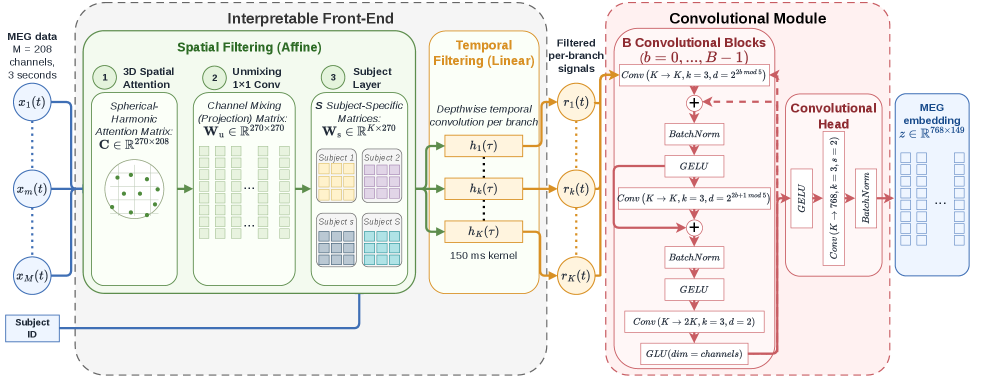
我们基于高性能 MEG-音频检索架构 重新设计了前端和解码器。原空间注意力基于扁平传感器布局,现替换为定义在三维 MEG 头盔几何上的 球谐函数。将每受试者表征从 270 分支减至 25 分支,为每个分支添加时间滤波器以匹配空间和时间上的神经源,并让卷积解码器更浅。训练前移除眼动和心电成分,降低刺激锁定捷径的风险。 在 MEG-MASC 数据集上,模型在 1005 个候选中达到 39.75 ± 0.34% 的 Top-1 准确率(六次训练),解码器参数约减少 20 倍。权重可映射到源空间,恢复与言语感知网络一致的生成器,左侧化分支携带右侧不明显的高频节律成分。配对 MEG 遮挡显示 19 个刺激特征中 15 个有贡献,其中沉默、声音强度、元音和声学起始影响最大。随机词表表现相反:将叙事 MEG 替换进去反而提升检索,表明无叙事结构的活动携带的可恢复信息更少。 wav2vec 目标可缩减至约 12 个学习特征维度而不损失准确率,而强时间压缩则导致明显损失。源映射与输入干预共同揭示了什么驱动检索。
论文精读
TL;DR 利用球谐函数与源定位构建可解释的 MEG 语音检索模型,参数缩减 20 倍,并首次系统揭示静音、元音等声学特征驱动解码。
问题
问题背景
非侵入式神经解码领域正致力于从脑磁图(MEG)等信号中重建感知内容,尤其是从自然语音中检索出短片段。这类技术有望为脑机接口(BCI)和语音神经假体提供关键驱动,因而备受关注。
现有方法局限
主流方案采用深度网络,以 CLIP 式对比学习 将 MEG 信号与 wav2vec 2.0 音频嵌入对齐,实现端到端检索。然而,这类模型存在明显局限:
- 可解释性缺失:网络权重无法映射到电生理学中常用的源空间概念,无法揭示哪些神经源参与了感知,也无法解释驱动检索的关键语音特征。
- 空间建模粗糙:前端空间注意力操作于扁平化的传感器布局,忽略了 MEG 头盔的三维几何结构,限制了源定位的精度。
- 参数量与噪声风险:解码器参数冗余,且未充分抑制眼动、心电等刺激锁时伪迹,模型可能学到与听觉处理无关的“捷径”。
为什么这个问题难且重要
- 技术挑战:MEG 信号具有毫秒级时间分辨率,但空间分辨率有限,且个体差异显著。构建一个既能保持高检索准确率,又能将权重与神经生理约束(如源空间分布、时间滤波器)紧密结合的模型,需要在网络架构中硬编码物理和生理先验,并在归因分析上做创新。
- 业界关注度:随着语音神经假体从侵入式向非侵入式迈进,可解释性是安全有效部署的前提。研究人员和产品经理亟需了解模型究竟利用了哪些刺激特征(如静音、元音、起始点等),以优化刺激范式和信号处理流程。
行业类比
类似于语音识别中需要将注意力权重对齐到语言学特征,大脑解码模型也亟需打开黑箱,解释频谱、韵律、音素等声学特征如何驱动检索,从而为更稳健的脑机交互设计提供依据。
核心洞察
- **源空间可解释的 MEG 解码前端**:本研究用球谐函数和时域滤波器将 MEG 传感器信号直接映射到皮层源活动,替代了以往方法中的黑箱空间注意力。与二维平面注意力相比,这种基于物理测量的三维建模不仅使权重具备神经解剖学意义,还能揭示左右半球在语音节律处理上的不对称性,同时将参数量减少约 20 倍。这为零样本泛化和神经反馈应用提供了更紧凑、更生理合理的特征空间,避免了繁琐的源重建步骤。
- **成对 MEG 遮挡实验揭示语音特征贡献谱系**:通过系统性地屏蔽刺激特征并替换控制条件,研究发现静音、声音强度、元音和声学起始等 15 个特征对检索有显著贡献,而随机词表的叙事结构缺失会削弱可恢复信息。这与以往仅依赖总体解码精度的分析不同,它量化了特定声学-语言特征的因果效用,表明叙事连贯性可能通过高层预测编码增强神经表征,为理解语音感知的层级加工提供了新视角。
- **wav2vec 目标的维度与时间压缩权衡**:实验表明 wav2vec 2.0 嵌入在保留约 12 个学习维度的条件下即可维持高检索准确率,但对时间维度的压缩却导致性能显著下降。这暗示语音神经编码对高频时序信息高度敏感,而频域存在大量冗余。与简单采用完整 wav2vec 表示的方法相比,这一发现为设计延迟敏感型语音脑机接口的压缩策略提供了直接指导:应优先保留时间细粒度,而非盲目使用预训练模型的全维特征。
方法
模型架构与可解释前端
输入为经过独立成分分析(ICA) 去除眼电、心电伪迹后的多通道 MEG 记录,对应被试聆听自然语音的短暂片段。
关键模块:
- 三维空间注意力层 区别于先前工作中在二维展平传感器布局上应用傅里叶特征的空间注意力 [16],本方法使用基于 球谐函数(spherical harmonics) 的参数化层。它直接在 三维 MEG 头盔几何 上定义各个传感器位置的空间滤波器,使模型先天匹配物理测量过程与潜在的皮层源分布。
- 因子化时空前端 将受试者特有的表示从原来的 270 个分支大幅缩减至 25 个分支,每个分支内嵌可学习的 时间滤波器。此举显式地分解为“空间模式(电流源在皮层上的静态分布)”与“时间动态(该源随时间的活动曲线)”,一方面极大降低了参数量,另一方面使每个分支对应于一个时空上可分离的“虚拟电极”或神经源。
- 浅层卷积解码器 从 25 个分支提取的时空特征输入一个更浅的非线性卷积解码器,映射到与 wav2vec 2.0 音频嵌入 对齐的共享表示空间。
训练与优化
模型采用 CLIP 风格的对比学习目标:最大化同一段语音的 MEG 嵌入与对应 wav2vec 2.0 音频嵌入之间的余弦相似度,同时推开批次内所有非匹配对。训练前用 ICA 去除伪迹 以减少与刺激锁时相关、但无关语音特征的生理捷径(如心跳、眨眼)。解码器参数相比之前工作减少约 20 倍。
输出与检索
在测试时,给定一段新的 MEG,模型提取其嵌入后,在包含 1005 个候选音频片段(含正确的与迷惑项)的嵌入库中检索最相似者,以 Top-1 准确率 衡量检索性能。
差异点
相比 Defossez 等 [16] 直接在展平传感器上操作且不可溯源至皮层源的架构,本方法通过 球谐空间层 + 因子化时空分支 + 源空间映射,实现了与经典电生理概念一致的可解释性,在不牺牲精度的前提下大幅压缩参数并揭示了哪些语音特征驱动了神经解码。
实验
实验设计
本研究重新设计了MEG 到语音检索的前端与解码器。基线为 Defossez 等提出的 CLIP 式架构,其空间注意力作用于扁平化传感器布局;本文改用基于三维 MEG 头盔几何的球谐函数层,将受试者特定分支从 270 个压缩至 25 个,并为每个分支配备时空匹配滤波器以对应神经元源。训练前剔除眼动与心电伪迹,降低刺激锁定的虚假捷径。模型在 MEG-MASC 数据集上以对比目标学习,将 MEG 片段映射到 wav2vec 2.0 音频嵌入空间,最终实现检索。此外,通过配对 MEG 遮挡、特征维度压缩及时间分辨率压缩等干预实验,系统分析驱动检索的声学特征与神经表征。
关键发现
- 解码器参数减少约 20 倍,Top-1 检索准确率仍达 39.75±0.34%(1005 候选)。
- 权重可直接映射至皮层源空间,恢复出与语音感知网络一致的源分布,且左侧分支携带更高频节律成分,呈现左偏侧化。
- 配对遮挡表明 19 个声学特征中 15 个有显著贡献,效应量最大者为静音段、声强、元音及声学起始。
- 随机词表出现反向结果:将叙事 MEG 替换后检索提升,提示缺乏叙事结构的神经活动所含语音信息更少。
- wav2vec 目标可压缩至约 12 个可学习特征维度而无精度损失,但较强的时间压缩会造成性能下降。
基线对比与解读
原有架构虽检索性能高,但权重不可解释,且参数量大。本文通过物理与生理约束的前端设计,在维持相当 Top-1 准确率的前提下,大幅压缩参数,并首次实现了从传感器到源空间的可解释映射。这一设计不仅揭示了皮层源的时间动态,还通过遮挡实验量化了不同声学特征的相对重要性——静音和元音等对检索的驱动作用最大,颠覆了过去笼统认为各种特征贡献均等的假设。从工程角度看,这种轻量、可定位的架构为实时脑机接口和临床言语解码提供了更可行的路线,同时展示了如何在黑盒深度学习中注入领域知识以换取可解释性,而不牺牲性能。
行业影响
可解释 MEG 语音解码的工业落地前景
落地场景
- 辅助通信与神经假体:面向失语症或闭锁综合征患者,通过非侵入式脑磁图实时解码想象或感知的语音,驱动文本转语音或屏幕输出。结合便携式 MEG 系统(如基于光学泵浦磁强计的 OPM-MEG),有望在康复中心、ICU 场景部署。
- 人机交互与内容消费分析:对用户聆听内容时的神经响应进行细粒度解码,可用于语音助手主动感知(在用户发声前预判意图)、播客/有声读物平台的内容推荐优化(基于实时脑反应调整推荐),以及广告创意评估(评估听众对特定语音特征的潜意识偏好)。
商业价值
- 降低通信障碍辅助成本:现有侵入式 BCI 手术风险高、维护复杂,基于 OPM-MEG 的可解释解码方案可将终端成本降至消费级,覆盖更广人群,开辟数十亿美元的神经康复市场。
- 提升内容平台的用户粘性:通过神经信号反馈优化语音内容片段,提升用户留存,直接带来广告收入增长。模型的高度可解释性允许平台快速定位哪些语音特征(如元音、强度、起始)驱动注意力,指导创作者生产高沉浸感内容。
- 解码器参数减少约 20 倍:大幅降低推理延迟与能耗,使云端到边缘端部署成为可能,适配移动脑电设备。
与现有产品/工作流的接口
- MEG/EEG 采集硬件:LISA 的前端球谐空间注意力天然适配 OPM-MEG 的三维几何,可集成到现有数据采集管线(如 Brain Products、CTF 系统)的后处理步骤。
- 语音分析流水线:解码器目标 wav2vec 2.0 嵌入与主流 ASR/NLU 系统对齐,输出的特征维度可压缩至约 12 维而不损失检索精度,无缝对接边缘语音助手(如 Amazon Alexa、Google Assistant)的音频理解模块。
- 神经分析平台:权重到源空间的映射可被开源工具(如 MNE-Python)直接可视化,便于神经科学团队与 AI 工程师协同迭代。
典型 use case
- 有声内容平台的 A/B 神经测试:流媒体平台在推出新播客前,采集少量被试的 MEG 数据,利用 LISA 的配对遮挡分析获知哪些语音特征(音高、韵律、词频)最能驱动解码准确率,进而优化后期制作,无需依赖主观问卷。
- 医疗辅助设备中的实时意图解码:用户佩戴 OPM-MEG 头盔,无需发声,仅通过想象自然语音,系统即输出对应文本,供在嘈杂环境或会议中无声交流——显著区别于肌电或侵入式方案,兼具可解释性以保证安全合规。
局限
- **受试者特异性限制**:模型仍需为每个受试者独立训练空间与时间滤波器,无法跨人共享表征。虽然前端分支从 270 降至 25,大大减少了参数,但非即插即用,增大了新用户上线成本。与近年来在 EEG/MEG 解码中涌现的受试者无关(subject-agnostic)元学习或预训练范式相比,该方法未探索群体层级知识迁移,制约了大规模快速部署的潜力。
- **解码性能与场景泛化不足**:在 **MEG-MASC** 上 1005 选 1 的 Top-1 准确率约 40%,远未达到实用交互水平。实验全部基于连贯叙述性语音,作者也指出随机词列表的 MEG 活动几乎无法检索对应语音,说明模型隐含依赖高层叙事结构。对于孤立词、多说话人、噪声等非理想条件的鲁棒性未经检验,实际应用中的性能可能大幅退化。
- **可解释性受限于逆问题与特征先验**:空间权重映射到皮层源依赖偏逆向求解(如 MNE)的正向模型精度与正则化假设,且仅分析了预定义的 **19 种声学特征**(静音、强度、元音等),未涵盖语义、音系或注意力等高阶变量,可能遗漏对检索至关重要的信息维度。消融框架本身虽控制充分,但结论难以外推至特征集之外。