DAPD: 双锚定策略蒸馏
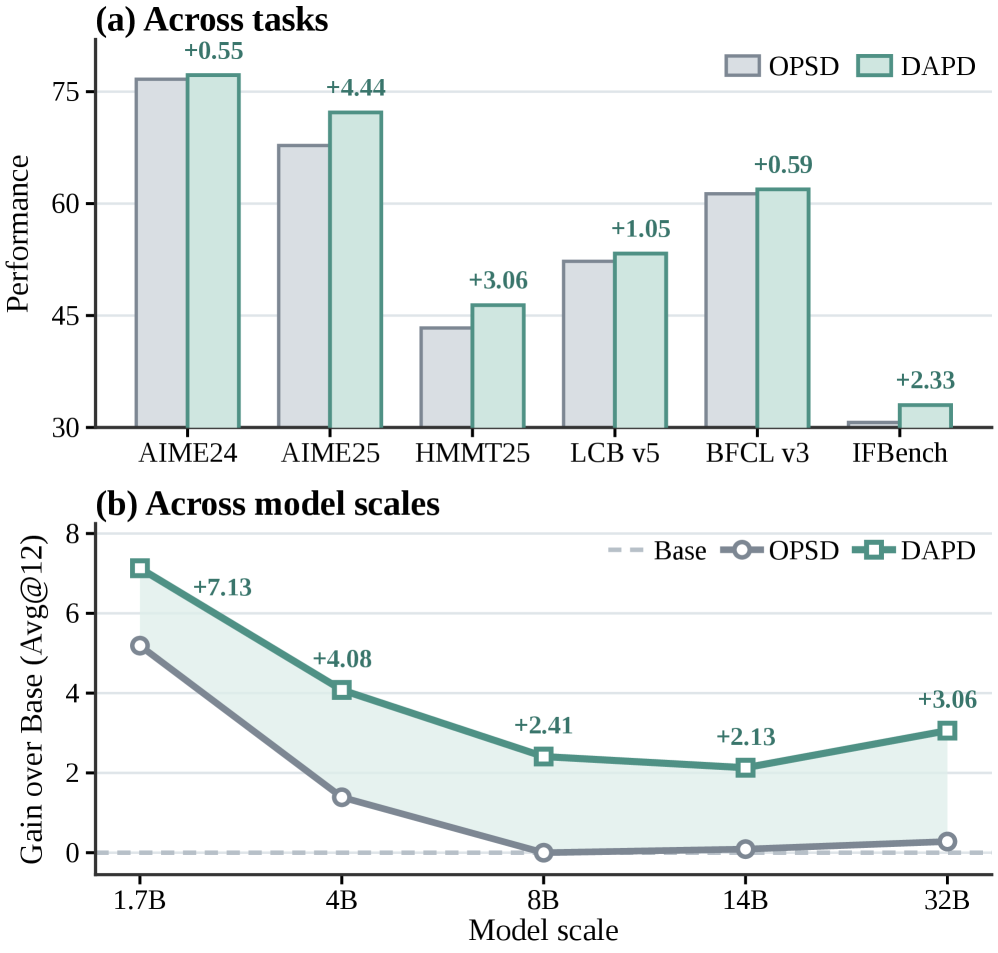
on-policy (self) distillation (OPSD) 越来越多地用于语言模型后训练。它通过特权信息增强教师模型,但可能诱发 特权幻觉: 学生模型学会了依赖特权信息的不可复现行为,在推理时该信息不可用,却表现得仿佛训练时的特权信息仍然存在,最终损害性能。本文指出,特权教师与学生模型在推理时的信息不对称是 OPSD 失败的根源。 为解决该不对称,我们提出 DAPD (Dual-Anchored Policy Distillation),一个具有两层锚定的统一框架。双路径锚定 (DPA) 引入自条件桥梁,沿两条匹配信息路径对齐参考与 rollout 行为,防止特权相关行为迁移到推理时的学生。双源锚定 (DSA) 在参考到 rollout 与 rollout 到参考两个方向应用这些路径,减少对特权参考指导的依赖,同时保留正确性监督。 大量实验表明,DAPD 显著缓解特权幻觉,在 Qwen3-4B 上平均超过 OPSD +2.00 分;增益跨规模保持,4B 上 +2.69,32B 上 +2.78。
论文精读
TL;DR **DAPD** 通过双锚定策略蒸馏消除 on-policy 自蒸馏中的特权幻觉,在 Qwen3-4B 上平均提升 +2.00 点,且效果随模型规模扩展。
问题
问题背景
大模型后训练中,On-policy Self Distillation (OPSD) 通过引入特权信息(如 ground-truth 答案、额外上下文)增强教师模型,再蒸馏至学生,已成为提升推理能力的主流范式。研究者关注如何在不泄露未来信息的条件下,安全地向学生传递决策策略。
现有方法局限
OPSD 会造成特权幻觉(privilege illusion):学生模型在训练时习得了深度依赖教师特权信息的行为,但在推理时无法获取这些信息,导致策略崩溃。具体局限包括:
- 信息不对称:教师使用特权信息生成 rollout,学生仅从提问端观察,二者观察空间不匹配。
- 错误行为固化:Behavioral Probe 实验表明,学生甚至会“假装”拥有特权信息,输入同样的问题但拒绝修正,输出带有特权依赖的错误策略。
- 传统蒸馏损失(如 KL 散度)未对信息差异做任何约束,直接传递被污染的 teacher-forced 分布。
为什么这个问题难/重要
- 技术挑战:需要在无特权信息的条件分布和特权条件分布之间建立合理联系,同时保证学生不学习任何不可复现的依赖。仅依靠单一路径的参考模型无法切断这种依赖。
- 业界关注度:随着 RLHF、自我对弈微调 等大量应用 on-policy 蒸馏,特权幻觉直接导致真实部署中可靠性骤降,影响模型在数学推理、代码生成等任务上的泛化能力。
- 可扩展性风险:该问题会随模型规模增大而放大,论文显示在 4B 和 32B 上 OPSD 退化更明显,阻碍大模型后训练的实用化。
行业类比
类似于自动驾驶中,训练时车辆依赖高精度地图(特权信息),但实际行驶只能靠车载传感器;若模型过度拟合地图信息,在未知路段会做出危险决策,必须通过感知-决策双锚定框架消除信息差。
核心洞察
- 信息不对称是 OPSD 特权幻觉的根本原因:本文首次明确将 OPSD 失效归因于推理时教师(拥有特权信息)与学生(仅访问上下文)之间的信息不对称,而非训练过程的蒸馏损失。这一角度区别于过往仅关注损失函数设计或教师增强策略的工作,直接揭示了学生无法重现特权依赖行为的本质矛盾,为后续锚定框架提供了清晰的理论靶点。
- 双路径与双源锚定实现特权依赖的隔离与转移:DAPD 提出自条件桥接,沿无特权路径对齐参考与 rollout 行为,避免特权依赖行为迁移至推理时学生;同时通过双向应用路径(参考→rollout 和 rollout→参考)减少对特权参考的过度依赖,在维持正确性监督的同时降低特权幻觉。该框架与简单分布匹配或数据增广相比,提供了更细粒度的信息流控制,从机制上解耦特权信息与模型行为。
方法
在 On-Policy Self-Distillation (OPSD) 中,教师借助训练时的特权信息(如 ground-truth 答案、检索片段)生成高质量 rollout,学生模仿后却会习得特权幻觉 (privilege illusion):推理时无法获取同等信息,却表现得如同特权仍可用,最终导致性能退化。Dual-Anchored Policy Distillation (DAPD) 提出一种双锚定框架,核心思路是利用学生模型自身的无条件分布作为桥梁,消除信息不对称。
输入
- 学生模型(推理时不访问特权信息)
- 教师模型(可访问特权信息)
- 训练问题及其对应的特权上下文
关键模块
- 自分布桥接锚点:学生在无特权条件下生成的分布,作为对齐的参考基线。
- 双路径锚定 (Dual-Path Anchoring, DPA):构建两条路径——无条件路径(学生仅依赖自身上下文生成行为分布)和特权路径(教师利用特权信息生成教师分布)。DPA 通过最小化这两条路径下分布的距离(如 KL 散度),强制学生学到的行为不依赖于特权信息,从而阻断特权依赖向推理阶段传递。
- 双源锚定 (Dual-Source Anchoring, DSA):在 DPA 基础上引入双向监督,既对齐教师分布到学生分布(参考 → rollout),也对齐学生分布到教师分布(rollout → 参考)。这降低了对单向特权指导的过度依赖,并在特权信息有噪声时仍能保持正确性监督。
输出
蒸馏后的学生模型,其策略行为与特权教师对齐,但解耦了特权依赖,推理时不会出现特权幻觉,性能稳定提升。
与同类方法的差异
传统 OPSD 直接最小化学生与特权教师分布的距离,全盘接收特权依赖;DAPD 通过将学生自身的无条件分布作为锚点,在蒸馏过程中主动分离特权因素,从根本上解决了信息不对称问题。实际部署时,推理管线无需再维护昂贵的特权信息管道,显著降低了工程复杂度和推理成本。
实验
实验设计
DAPD 在 Qwen3-4B 等不同尺度的语言模型上进行后训练评估,并与基于 OPSD 的基线对比。通过多个推理任务衡量模型性能提升,并设计了消融实验以隔离 双路径锚定(DPA) 与 双源锚定(DSA) 的各自贡献。实验还考察了方法在不同模型规模(4B、32B)下的可扩展性,以及参考模型配置的鲁棒性。
关键发现
- DAPD 在 4B 模型上平均提升 +2.00 分,且在更大模型上收益递增:32B 模型达到 +2.78。
- 特权错觉行为在 DAPD 下显著减少,学生模型不再依赖无法从推理上下文获取的教师特权信息。
- 消融显示:单独移除 DPA 或 DSA 均会导致性能下降,证明两组锚定机制对缓解信息不对称均不可或缺。
- 定性分析表明,DAPD 生成的输出更贴合学生自身分布,避免了 OPSD 中常见的“自信但错误”模式。
与基线对比解读
OPSD 因教师享有的特权信息而产生 信息不对称,导致学生习得特权依赖行为,而在无特权推理时性能骤降。DAPD 通过引入自条件桥接与双向路径对齐,从根本上切断了特权行为向推理学生的传递,同时保留了必要的正确性监督。因此,DAPD 不仅在同等条件下反超 OPSD,且增益随着模型规模放大而进一步扩大,揭示了解决信息不对称比单纯扩大模型或数据更关键。这一结果对工业级推理模型部署具有直接指导意义:蒸馏策略必须保证训练与推理的信息分布一致,否则性能收益不可靠。
行业影响
落地场景
DAPD 可无缝嵌入任何依赖在线策略蒸馏(OPSD)进行语言模型后训练的产品线,尤其适用于需要推理增强或带参考信息生成的场景。典型落地包括:
- 智能对话与客服:如电商售后问答、金融顾问助手,利用特权知识(产品手册、交易规则)对模型进行蒸馏,但需要避免推理时对不可见信息的幻觉依赖。
- 内容审核与结构化提取:如内容平台对UGC进行合规检测,或从非结构化文本中提取医疗/法律实体,常以带标注的少数案例作为特权信号。
- 代码生成与数学推理:工具增强型LLM在训练时利用外部执行器或验证器作为特权信息,DAPD可使学生模型在无访问权限的推理阶段仍保持高正确率。
商业价值
- 直接降本:减少因特权幻觉导致的错误输出,从而降低人工审核与纠错的开销。在客服场景中,幻觉率每降低1%可能对应数十万级别的工单减少。
- 体验与信任提升:模型在可见上下文中行为更一致,避免出现“回答看似合理但无法溯源”的情况,这对金融、医疗等高风险行业至关重要。
- 规模化收益:DAPD的增益随模型规模增大而保持甚至上升(4B模型+2.69,32B模型+2.78),意味着模型升级时无需放弃蒸馏方案,保护了技术投资。
与现有工作流的集成
DAPD 保持了与 OPSD 相同的数据流形状,只需将蒸馏目标从传统 OPSD 替换为 DAPD 的双锚定损失,无需改动训练数据或模型架构。集成路径:
- 在现有 RLHF 或偏好优化的蒸馏阶段,引入 DPA 双路径锚定 和 DSA 双源锚定 模块。
- 保留原有的特权教师网络和在线采样管道,仅对蒸馏损失计算部分进行替换(约数十行代码量)。
- 可逐步淘汰对特权参考策略的强依赖,向 无参考 DAPD 演进,进一步简化部署栈。
具体用例:
- 电商平台智能导购:训练时享受商品知识库、用户画像等特权信息,推理时仅基于对话历史回答。DAPD 可使模型在无知识库注入时仍遵守产品事实,避免编造功能,减少退货纠纷。
- 在线教育口语陪练:教师模型利用标准发音与语法纠错信号,学生模型(手机端)无法获取实时信号,通过 DAPD 将纠错行为固化为上下文可复现的策略,显著提升离线场景下的发音诊断准确率。
局限
- **特权信息依赖与可移植性**:DAPD 的性能增益依赖于预定义的**特权信息**(如推理链、中间步骤),构造方式由任务决定,通用性受限。当特权信息难以定义或获取时(如开放式生成),DAPD 的优势会减弱。论文也承认当前仅探索了基于 CoT 的特权形式,未来需扩展至更广义的偏好信号,否则在实用中需额外标注成本。
- **训练开销与多路径复杂度**:DAPD 引入**双路径锚定**和**双源锚定**,训练时需维护两个行为路径(无条件路径和特权路径)并分别对齐,这增加了前向 / 反向传播的计算量。与标准 OPSD 相比,训练吞吐量有所下降,对资源受限环境不够友好。论文未详细汇报训练耗时或 wall-clock 对比,实际部署时可能成为瓶颈。
- **无参考模型的限制**:当前 DAPD 框架仍依赖一个**参考策略**作为锚点,无法完全脱离初始模型(如 SFT 模型)独立运行。论文在结论中提及“走向无参考 DAPD”作为未来方向,但现有设计在迁移到零参考场景时需重新架构,限制了其在全自我提升类 post-training 管道中的即插即用性。