Round-Trip Consistency: 双向扩散模型可预测自身展开误差
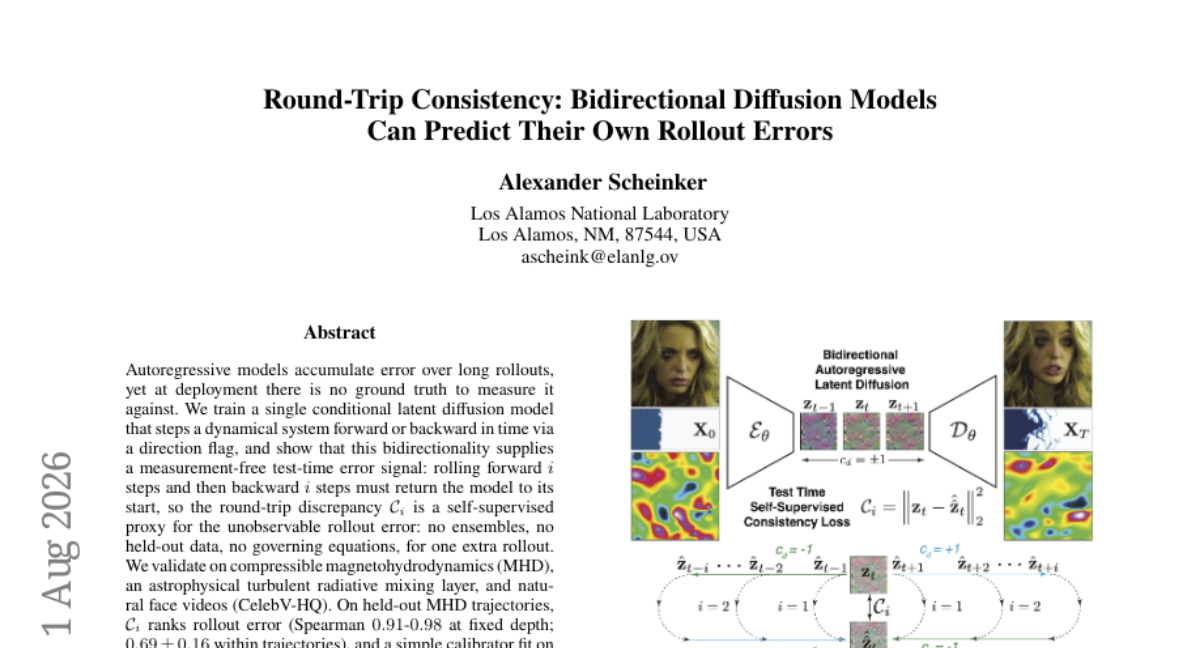
自回归模型在长展开中累积误差,但部署时无真值可对比。我们训练单一条件潜扩散模型,通过方向标志让动力系统前向或后向步进,并提出往返一致性:前向 i 步再后向 i 步必须返回起点,因此往返差异 Ci 可作为不可观测展开误差的自监督代理——无需集成、无留出数据、无控制方程,仅需一次额外展开。 在可压缩磁流体动力学(MHD)、天体物理湍流辐射混合层和自然人脸视频(CelebV-HQ) 上验证。在留出的 MHD 轨迹上,Ci 对展开误差排序(Spearman 0.91–0.98 固定深度;轨迹内 0.69±0.16),简单校准器预测误差幅度在 1.14 倍(68%) 和 1.29 倍(95%) 内,近标称覆盖率。 同一信号标记分布外 Orszag-Tang 涡(AUROC 0.98;深度 10 时 1.0),在采样离散基线失效处生效;80% 覆盖率下削减 15% 累积误差,是仅深度基线的三倍。双向训练为负成本,双向均优于方向专家,后向方向兼作快速逆求解器。 在 LE-PDE-UQ 湍流 Navier-Stokes 基准上,单一双向模型达到其十模型集成精度的 1.3 倍以内,训练成本十分之一,具有最佳免训练像素级校准。往返一致性将可逆性转化为生成模型实用的信任信号。
论文精读
TL;DR 双向潜空间扩散模型通过前向再后向的往返一致性,在无真值部署时自行评估 rollout 误差,无需集成或物理方程,即可实现误差预测、校准与 OOD 检测。
问题
问题背景
科学计算与生成式 AI 中,自回归模型 被广泛用于预测动态系统(物理场演化、视频帧生成等),但长时序 rollout 会累积误差,而部署阶段缺乏地面真值,无法直接测量误差。业界亟需一种无需真值、测试时可用的误差估计方法,以量化模型预测的不确定性。
现有方法局限
- 集成与贝叶斯方法:需要训练多个模型,计算成本高,且模型数量直接影响估计质量。
- 基于验证集的校准:依赖留出数据训练误差预测器,当部署数据分布外(OOD)时校准失效,泛化性差。
- 基于物理的误差界:要求已知控制方程,而多数实际系统(如湍流、天体物理)方程未知或不完整,无法通用。 这些方法均依赖外部信息(额外模型、留出数据或先验物理),无法实现完全自监督、零额外数据的测试时误差监测。
技术挑战与重要性
核心挑战在于:在没有任何真实信号的情况下,如何让模型自我感知累积误差?动态系统往往不可逆,但通过同时学习前向与反向演化,可利用 Round-Trip Consistency(向前 i 步再向后 i 步必须返回起点)构造一个可证明的误差代理。这相当于为生成模型内置了一个“信任信号”,无需集成或留出数据,即可在测试时直接输出误差估计。在安全关键应用(如医学视频预测、物理模拟辅助决策)中,这种无真值误差检测能力直接决定模型能否实际落地。
行业类比
类似 自动驾驶轨迹预测 中,通过前向模拟与反向一致性验证来检测模型不确定性,避免因误判导致决策失误,提升系统安全性。
核心洞察
- 双向扩散模型通过强制时间反演对称性,将自身 rollout 的累积误差转化为可测量的往返不一致性,从而在推理时无需真实标签即可评估模型可靠性。这与现有方案形成鲜明对比:集成方法需要多次前向计算且缺乏 self-check 机制,而基于控制方程或预留数据的检验则需要领域知识或数据划分,破坏了自监督属性。该方法的独到之处在于,误差信号的获取对模型而言是“零成本”的——仅需多跑一次反向 rollout,且双向训练甚至提升了单向性能,实现了性能与误差感知的双赢。
- 往返一致性信号 C_i 不仅能排序 rollout 误差,还可通过简单校准器直接预测误差幅度,并在分布外检测中展现出高 AUROC,而传统基于采样分散的基线在此场景下完全失效。这揭示了一个深刻的性质:对于生成式动力学模型,内在的时间反演约束比外部统计量(如预测方差)更能捕捉模型的知识边界。在实际部署中,该特性允许系统自动识别并拒绝对陌生输入的可疑预测,显著降低由模型幻觉引发的风险,特别是对高维物理系统或视频生成等安全敏感应用。
方法
该方法基于条件潜在扩散模型(LDM),通过双向训练赋予模型前向演化与反向求解的能力,并利用**往返一致性(Round-Trip Consistency)**在测试时无监督地评估 rollout 误差。
核心流程:输入 → 关键模块 → 输出
输入:动态系统的状态序列(如物理场快照或视频帧),不依赖控制方程。首先由自编码器将高维状态压缩为潜在表示 $z$。
关键模块:
- 条件扩散模型:采用 Diffusion Transformer (DiT) 架构,以方向标志(forward/backward)和当前状态 $z_t$ 为条件,通过 adaLN-Zero 注入条件信息。模型在潜在空间执行去噪过程,生成下一时刻或前一时刻的状态。
- 双向联合训练:训练时,模型同时学习 $p(z_{t+1} \mid z_t, \text{forward})$ 和 $p(z_t \mid z_{t+1}, \text{backward})$,参数完全共享。损失函数为两个方向的扩散去噪损失之和。实验表明,这种双向训练不仅未损害单方向精度,反而优于独立训练的方向专用模型(实现“负成本”提升)。
- 往返一致性信号:测试时,从起点 $z_0$ 出发,利用前向 rollout $i$ 步得到 $z_i$,再立即从 $z_i$ 反向 rollout $i$ 步回到 $z_0'$。计算往返差异 $\mathcal{C}_i = |z_0 - z_0'|$。该过程仅需一次额外反向 rollout,无需集成、留出数据或真实标签,$\mathcal{C}_i$ 即可作为未观测前向误差的可靠代理。
输出:
- 无监督误差代理 $\mathcal{C}_i$:可用于误差排序(Spearman 相关系数达 0.91–0.98)、误差幅度校准(经简单标定后,预测值与真实值的比率在 1.14 倍以内覆盖 68% 样本)以及选择性预测(按 $\mathcal{C}_i$ 截断后,误差可下降 15%,覆盖率 80%)。
- 分布外检测:$\mathcal{C}_i$ 能准确标记未知系统状态(如 Orszag–Tang 涡,AUROC 0.98),且比基于采样方差的基线更敏感。
- 快速反向求解器:训练好的模型可直接用于从目标状态反向推断初始条件,相当于一个高效的逆动力学求解器。
与同类方法的差异点:相较于依赖多模型集成(如 LE-PDE-UQ 用 10 个模型)、需要保留验证集或预知控制方程的 UQ 方法,本方法仅需单个双向模型和一次往返计算,即能以更低训练成本(1/10)达到可比精度,且误差代理源于模型自身的可逆性约束,无需外部监督。
实验
实验设计
- 核心设置:训练单一条件潜扩散模型,通过方向标志实现时间正向/反向步进。对动态系统进行正向 i 步、再反向 i 步的往返(round-trip),其往返差异
C_i作为无监督的 rollout 误差代理信号。 - 评估维度:分别在已知物理系统(MHD 湍流、辐射混合层)、真实人脸视频(CelebV-HQ)及外部 Navier-Stokes 基准(LE-PDE-UQ)上检验代理与真实误差的相关性、误差幅值校准、选择性预测与 OOD 检测能力,并测试反向 rollout 作为逆求解器的性能。
- 基线对比:对比 depth-only 预测器、单向专家模型、集成不确定性方法(如采样方差)以及 LE-PDE-UQ 的 10 模型集成。
关键发现
- 代理强相关:
C_i在固定 rollout 深度下与真实误差的 Spearman 相关系数达 0.91--0.98,能可靠排序误差;在校准后,误差幅值预测准确度达到 1.14 倍(68% 置信)和 1.29 倍(95% 置信)。 - OOD 检测出色:对未见的 Orszag-Tang 涡旋,AUROC 高达 0.98,深度 10 处完美标记分布外样本,而传统采样方差基线则完全失效。
- 选择性预测有效:在 80% 覆盖率下削减 15% 的累积误差,改善幅度是 depth-only 基线的 3 倍。
- 负成本双向优势:双向训练以无额外成本(甚至略优)同时提升正向与反向精度,反向 rollout 更可直接作为快速逆求解器。
- 外部基准竞争力:在 Navier-Stokes 上,单模型精度达到 10 模型集成的 1.3 倍以内,训练成本仅为其十分之一,并提供最佳的免训练像素级校准。
与基线深度对比
- 相较于依赖集成或保留数据的不确定性量化方法,往返一致性无需任何额外模型、保留数据或控制方程,仅靠一次额外反向 rollout 即可提供误差信号,部署成本极低。
- 在 OOD 检测中,基于集成的方差方法在分布偏移时可能错误地降低不确定性,而往返一致性代理稳定地随分布偏移增长,表现出更强的鲁棒性。
- 校准结果表明,depth-only 预测器仅利用 rollout 深度信息,而往返差异融合了轨迹级动态信息,从而将误差预测的信息量提升约 1 nat,并可直接迁移至所有解码的物理场。
行业影响
落地场景
该方法提供了一种 无需真值 的时序生成误差估计,适用于所有依赖自回归 rollout 的生成模型产品。典型场景包括:
- 自动驾驶仿真:轨迹预测模型在长时预测中误差累积,利用往返一致性可在无真值条件下实时量化每条预测轨迹的可信度,触发安全降级或重规划。
- 视频生成与编辑:如人脸视频、特效预览,双向扩散模型可同时提供前向生成与反向一致性校验,自动标记可能失真的帧,减少人工抽检。
- 工业数字孪生:在设备状态预测或物理场演化(如流体、热力)中,无需传感器数据即可对长期推演结果进行自监督质量评估,支持预测性维护决策。
商业价值
- 降本:省去集成多模型的算力开销(单向双向模型统一训练,参数量无增加,训练成本反而低于单向专家),且校准仅需训练集统计量,无需额外标注。
- 增收:提升基于生成模型的产品可靠性,使客户更信任长时生成结果,可应用于金融高频交易模拟、医疗时间序列预测等对误差敏感的高价值场景。
- 体验提升:在内容创作工具中,实时反馈生成质量(如“当前生成帧置信度低”),帮助用户快速迭代,减少坏果率。
与现有产品/工作流的接口
现有自回归模型(如 Video Diffusion、Trajectory Transformer)只需将训练改为双向条件(加方向标志),推理时利用同一模型的前向/反向 rollout 即可计算一致性指标。校准时可拟合少量训练 rollouts 得到线性回归器,推理时直接输出预测误差。集成上:
- 视频生成管线:在扩散采样后附加一致性检查节点,将 C_i 映射为置信度分数,用于过滤或后处理。
- 物理仿真引擎:替代传统灵敏度分析或蒙特卡洛方差估计,提供 per-step 误差棒。
具体落地 Use Case
- 电商虚拟试穿视频生成:为用户生成多角度试穿短视频时,长时序可能导致局部模糊或扭曲。双向扩散模型在生成完成后自动计算往返误差,将低质量帧高亮,允许用户一键重生成。节省人工审核成本,提升转化率。
- 医疗影像时间序列预测(如肿瘤生长模拟):医生需要模拟未来几周肿瘤形态,但长模拟可能偏离生理真实。利用本方法,模型在输出模拟结果的同时提供逐帧误差估计,帮助医生判断模拟可靠性,仅在低误差区域制定治疗方案。
局限
- **往返一致性对逆过程偏差敏感**。C_i 作为误差代理的前提是模型正确学习了互逆的前向后向映射;若模型存在系统性偏差(例如某些区域的逆过程不精确),C_i 可能高估或低估真实误差,导致校准失效。论文在长 rollout 深度下观察到轨迹内 Spearman 系数仅为 0.69±0.16,表明代理在不同时间步上的可靠性有限,这会限制其在需要细粒度时序误差估计的场景中的应用。
- **额外推理开销与部署限制**。虽然双向训练在参数共享下可能降低训练总 FLOPs,但测试时需额外执行一次完整的反向 rollout 来计算 C_i,这使推理延迟翻倍。对于高维、实时的动态系统预测任务,这种计算代价可能难以承受,尤其是在边缘设备或流式推理场景中。
- **系统可逆性假设限制领域扩展**。本方法要求底层动态系统本身具有可逆性或至少模型学到的前向后向过程一致,难以直接应用于本质不可逆的过程(如扩散-反应耗散系统、带噪声测量的非马尔可夫过程)。同时,验证仅覆盖了可压缩 MHD、湍流混合层及人脸视频三类系统,对于高度混沌、多尺度或刚性系统,往返一致性信号可能发散,泛化能力有待检验。