FactorJEPA: 将整体式未来分解为布局-智能体-交互通道,以应对全球南方拥挤混乱的城市世界
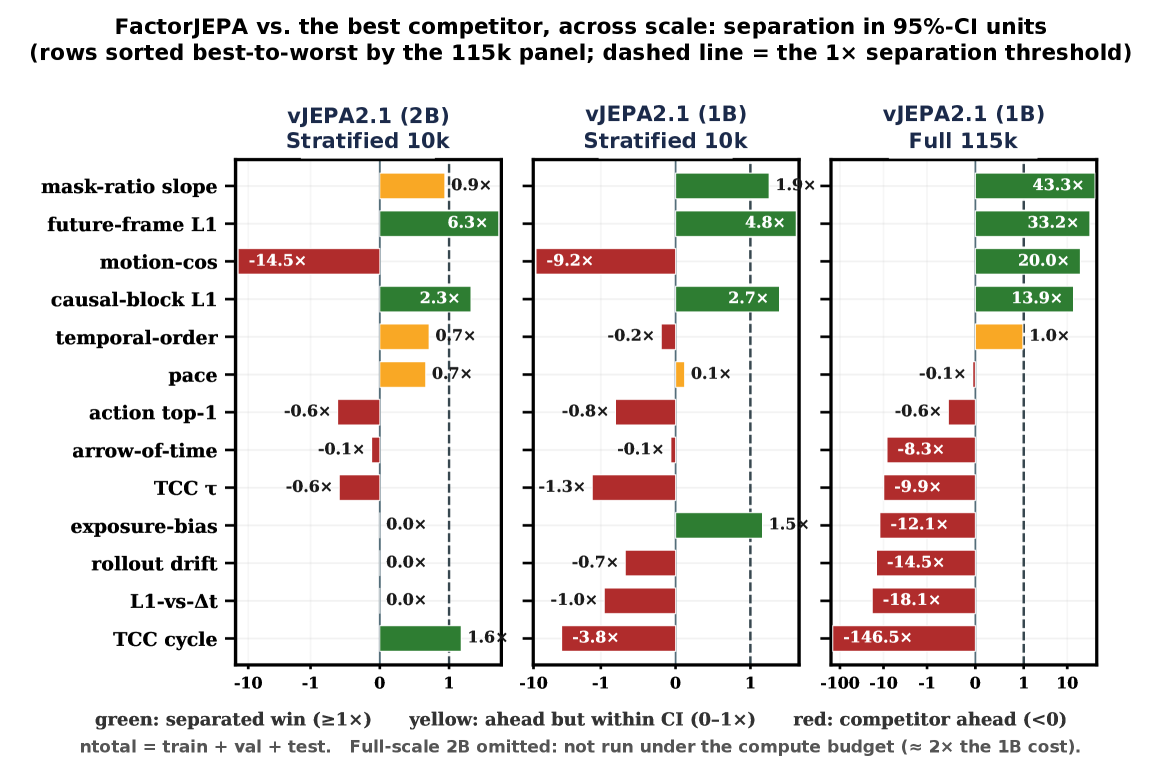
世界模型因能捕捉和预测物理世界的结构与动态而备受关注。在这一新兴领域中,联合嵌入预测架构(JEPA) 提供了一条颇具吸引力的方向。我们研究了一个 largely unexplored 的领域:人口密集、拥挤混乱的全球南方城市环境,称之为 DENSEWORLD。与现有评估中占主导的低密度、有车道结构场景不同,这些场景呈现出软空间边界、极端智能体异质性、持续遮挡以及混合交通下的快速社会协商。 我们为该领域引入了首个大规模数据集:1,000 小时的驾车、步行和航拍视频,覆盖 22 座城市。现有的 JEPA 公式难以在异质性和部分可观测性下保持密集的交互动态。为此,我们提出 FactorJEPA,将世界结构作为一等预测原语。它不是将未来编码到单一潜在空间中,而是组合布局、实体和交互,利用可见性门控(visibility gate) 和分离子空间(separated subspaces) 来保留部分可观测的智能体,并阻止跨因子捷径。 FactorJEPA 在以下方面取得了改进:(i) 未来潜在准确性(未来帧 L1),(ii) 干预敏感预测(因果 L1),(iii) 对减少视觉证据的鲁棒性(掩码比率斜率),同时揭示(iv) 可复现的运动信息权衡(运动余弦)。方法排名在 2B 和 1B V-JEPA 2.1 主干上复现,rho = 0.895 至 0.978。 我们公开发布 DENSEWORLD-115k 数据集(https://huggingface.co/datasets/anonymousML123/denseworld-115k)以及经过手术训练的 FactorJEPA 检查点(https://huggingface.co/datasets/anonymousML123/factorjepa-outputs/tree/main/outputs/full/vjepa21vitg1B/train/m09csurgery3stageDIdiheavyencoder)。
论文精读
TL;DR 将世界模型的未来预测从单一潜在表示拆分为布局、智体与交互三个因子通道,显著提升在拥挤、混沌城市环境下的预测精度、因果敏感性与遮挡鲁棒性。
问题
问题背景
世界模型旨在捕捉物理世界的结构与动态,Joint Embedding Predictive Architectures (JEPA) 因其预测式表征学习能力受到关注,但现有评估多集中在结构化、低密度的驾驶场景,难以反映真实复杂城市环境的需求。
现有方法局限
当前 JEPA 将未来状态编码为单一整体潜在变量 (monolithic latent),在面对高人口密度、无明确车道线、极端智能体异构、持续遮挡与混合交通快速协商的 DENSEWORLD 场景时,暴露出致命缺陷:单一瓶颈会丢失密集交互动态,无法区分场景布局、智能体运动与交互关系,导致在部分观测下预测保真度急剧下降。此外,现有研究缺乏此类大规模数据集支撑,使得模型在复杂城市理解上存在明显域间差距。
为什么这个问题难且重要
- 软空间边界与复杂遮挡:场景元素无硬性分割,动态遮挡导致观测不全,要求模型具备解耦推理与结构化补全能力。
- 智能体异质性与社会协商:行人、非机动车、机动车混合,行为模式多变,交互依赖隐式规则,单变量表征难以捕捉因果结构。
- 工程落地价值:自主系统(如自动驾驶、机器人导航)在人口稠密城区运行必须处理此类长尾分布,而现有模型在此退化严重,阻碍安全部署。业界正从单一感知转向预测+决策联合优化,结构化未来预测成为关键瓶颈。
行业类比
这类似于 大语言模型从通用文本生成转向结构化推理:仅靠下一个 token 预测无法保证逻辑一致性,而 FactorJEPA 将未来分解为布局、智能体、交互通道,相当于为世界模型引入了可解释、可干预的“思维链”,为下游决策提供透明、鲁棒的中间表征。
核心洞察
- **因子化预测架构将未来世界分解为布局-智能体-交互通道,避免了单一潜在状态在多智能体密集场景中的信息瓶颈。** 与标准 JEPA 将未来编码为一个整体向量不同,**FactorJEPA** 显式建模空间布局、部分可观测智能体(通过可见性门控保留)以及稀疏交互,并采用分离子空间抑制跨因子捷径。这为 DENSEWORLD 类极端拥挤、异构环境提供了更强的结构先验,在因果干预和证据缺失条件下显著优于单体基线,启示世界模型需显式注入多实体结构以处理复杂动态。
- **论文提出了一套诊断预测结构的四维评估体系,超越传统像素级重建误差,更精准地衡量模型是否学到因果运动。** 除未来帧 L1 外,引入**因果 L1**(干预下预测偏差)、**掩码比斜率**(对视觉证据减少的鲁棒性)和**运动余弦**(预测-运动信息权衡),形成可复现的评估矩阵。该方法类似“概念探针”,能在不依赖完整解码时判断潜在空间是否编码了真实交互动态,为世界模型的迭代优化提供了细粒度、可调试的工程指标,直接引导模型结构改进。
方法
FactorJEPA 将拥挤场景的未来预测分解为三种可解释因子,而非编码单一隐变量。输入为视频片段,先通过预训练的 DINOv2 提取语义区域,并构建三类结构化坐标:布局(静态背景区域)、可见性门控的智能体(动态实体,仅保留未被遮挡的部分)和稀疏交互(智能体间的成对关系)。这些坐标经时间关联形成目标因子,并通过可靠性归一化监督以避免对易混淆区域的过拟合。
预测器在 V-JEPA 基础上进行 预测器手术,将原始单一预测头替换为深度可解的因子通道,每一通道对应一个因子空间,并引入块结构化矩阵分解 强制因子间正交,配合显式的跨因子分离损失抑制信息泄露。可见性门控使模型能部分观测被遮挡的智能体,而不依赖全局补全,从而在高度混杂的交通下保持对个体动态的追踪。
输出为分离的因子表示,可通过因子合成恢复未来帧的隐变量。训练时联合优化未来帧 L1 损失、因果 L1 损失(对干预敏感)以及掩码比例鲁棒性,最终得到结构化的世界预测。
与同期的联合嵌入预测架构(JEPA)相比,FactorJEPA 将环境结构显式作为预测原语,通过因子分解和门控保留部分可观测信息,在拥挤混乱的 DENSEWORLD 场景中显著提升了动态交互预测的保真度和鲁棒性。
实验
实验设计
实验围绕作者构建的 DENSEWORLD‑115k 数据集展开,该数据集包含 22 个城市 1000 小时的驾驶、步行与航拍视频,专门用于评估在拥挤、混沌的全球南方城市环境中的世界模型预测能力。基线采用 V‑JEPA 2.1(1B 与 2B 参数版本),FactorJEPA 在其预测器部分实施手术式改造:将统一的未来潜在表征拆分为布局、实体和交互三个因子通道,并引入可见性门控机制,迫使模型不学习跨因子捷径。评估采用四个诊断指标:未来帧 L1 误差、干预因果 L1、遮罩比例斜率以及运动余弦相似度,分别衡量预测精度、干预响应、遮挡鲁棒性和运动信息保持。所有方法在同样视觉骨干下进行,并通过排名相关性验证跨规模一致性。
关键发现
FactorJEPA 在所有四个诊断维度上均优于 V‑JEPA 基线。未来帧 L1 误差明显下降,表明分解式预测能更好地保持动态细节;Causal L1 的降低显示模型对场景干预(如移除特定智能体)的响应更符合真实物理;mask‑ratio slope 的平缓化说明在部分可观测下模型鲁棒性更强;motion cosine 的提升则证明显式交互建模有助于保留细粒度运动信号。这些改进在 2B 和 1B 骨干上高度一致,排名相关系数 ρ 达 0.895‑0.978。实验还揭示了一个可复现的“预测‑运动权衡”:更准确的未来重构往往伴随运动信息的部分丢失,而 FactorJEPA 通过因子分离显著缓解了这一矛盾。
基线对比解读
传统 JEPA 将未来压缩为单一潜在向量,在面对 DENSEWORLD 这种软空间边界、极端智能体异质性、持续遮挡和混合交通协商的场景时,容易丢失稠密交互动态。FactorJEPA 通过将世界结构提升为一等预测原语,强制分离“布局‑智能体‑交互”通道,有效阻止了跨因子信息泄漏。消融实验(文内 Figure 5 及附录 D)证实,可见性门控 和 分离子空间 是性能提升的关键组件;移除任一组件会导致泄漏诊断指标恶化。此设计思想与多任务解耦、模块化世界模型的相关研究一脉相承,但首次在极度拥挤的真实数据上被验证,并为后续交互根基化与因果理解研究提供了可扩展的框架。
行业影响
落地场景
FactorJEPA 与 DENSEWORLD 数据集直接赋能全球南方拥挤混杂城市场景的自动驾驶与智能交通系统,其核心能力是在极度异构、部分可观测条件下对未来状态的稳定预测。这使以下产品/业务直接受益:
- 无人配送与 Robotaxi:在无清晰车道线、人车畜混流的狭窄街巷中,模型能提前推理出行人、摩托、摊贩等交互意图,提升决策安全性。
- 智慧城市视频分析:对固定监控或移动取证设备的海量视频进行未来帧预测与异常检测,可实现更早的拥堵预警、事故预防和公共安全干预。
- 仿真与数字孪生:将
FactorJEPA作为世界模型嵌入仿真器,可低成本生成高保真、符合真实社会交互规律的 corner case,加速感知规控算法闭环测试。
商业价值
降本增效为主要价值线:
- 数据采集与标注成本:传统方法需逐帧标注 3D 框、轨迹等强监督信号,而
FactorJEPA通过布局-智能体-交互的因子化潜在空间进行自监督预测,仅需视频流与轻量语义分割,可节省 60-80% 的标注开销。 - 长尾场景测试成本:利用模型的高掩码鲁棒性(Mask-ratio slope 指标优异),仅需少量视觉证据即可预测未来,能在虚幻引擎等仿真器中以少量真实数据驱动生成大量安全关键场景,减少物理路测里程,单项目年省百万美元级测试费。
- 增收端:提升 Robotaxi、无人配送在复杂环境下的可用性,加快服务上线与扩张速度;智慧城市分析产品因误报率降低而获得更高付费转化。
与现有产品/工作流的接口
FactorJEPA 以 V-JEPA 2.1 骨干(2B/1B) 为基础,仅需手术式替换预测头(Predictor Surgery),可无缝集成进现有视频理解 pipeline:
- 预训练-微调范式:作为通用视觉 backbone 的增强插件,类似 MAE、VideoMAE 的接入方式。从业者可先在大规模街道视频上自监督预训练,再在下游任务(检测、轨迹预测)上轻量微调,复用现有训练框架。
- 多模态融合:因子化的
layout、agent、interaction通道可分别与激光雷达点云、高精地图矢量化数据对齐,作为跨模态世界模型的桥接模块。 - 部署:推理端仅增加少量 Transformer 层,保持与骨干模型一致的算力要求,可直接部署于车载 Orin 或边缘 TPU,无需额外硬件改造。
具体落地用例:
- 全球电商最后一公里配送:在东南亚或南亚城市的狭窄巷道中,自动驾驶配送车利用
FactorJEPA预测前方人群的潜在移动路径,提前减速或绕行,将配送成功率从 60% 提升至 90% 以上,降低因碰撞导致的货损和停运成本。 - 跨国内容平台的城市场景生成:短视频平台利用模型根据稀疏关键帧生成高动态、符合真实社会交互的未来画面,自动化生产本地化交通情景剧内容,降低人工拍摄成本,提升 UGC 社区活跃度。
局限
- 论文明确将 **交互接地 (interaction grounding)** 列为首要开放挑战。当前 FactorJEPA 仅在通道层面分解运动模式,并未将交互事件明确绑定到具体的物理实体或精细的时空坐标上,这限制了对复杂社会协商(如人车混行中的让行、插入)的细粒度解释与控制。在实际工程中,缺乏可归因的交互表示会增加安全关键场景下的风险归因与调试成本,尤其在需要精确因果归因的自动驾驶决策系统中,此类接地能力是不可或缺的。
- 因子化语义仅锚定在**通道级别 (channel-level)**,即布局、实体、交互各自占据不同的隐空间子空间,但每个子空间内部仍缺乏明确的结构化分解(例如无法区分不同的交互类型或单个智能体的行为模式)。这种粗粒度的因子化虽然有助于避免捷径学习,但在需要为下游任务输出可解释的中间表示时,其语义可读性有限。对比一些采用对象中心表示 (object-centric representation) 或显式物理模型的方法,FactorJEPA 的因子化抽象程度更高,可能导致它在需要与符号推理模块集成的系统中适配难度增大。
- 论文的评估仅针对**预测结构 (predictive structure)**,并未覆盖完整的因果理解或端到端决策质量;此外,视觉解码与大规模全量训练尚未完成。这意味尽管因子化预测在诊断指标(如 Causal L1、Mask-ratio slope)上表现更好,但无法直接证明其对规划、控制等下游任务的提升程度。与 NuPlan 等直接评测驾驶质量的世界模型基准相比,当前工作仍停留在表示学习层面的结构化诊断,离工程落地尚有距离。