Distill Where You Fail: Recovering Learning Signals of Negative RL-Groups from Adaptive Teacher Guidance
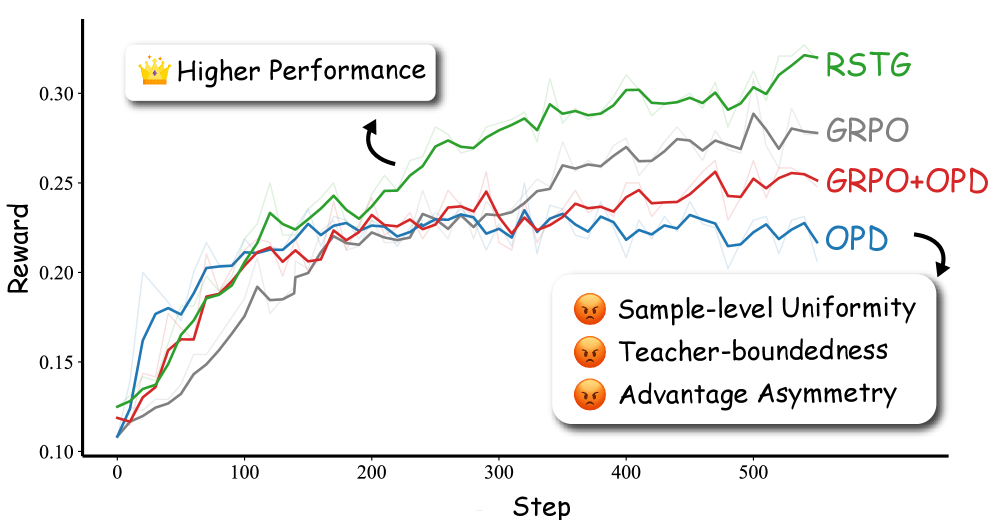
RLVR 已成为大语言模型后训练的标准范式,其中 GRPO 虽被广泛采用,却存在奖励信号稀疏的问题:当组内所有响应获得相同奖励时梯度完全丢失。OPD 通过教师模型提供密集的 token 级监督,自然弥补了这一缺陷。然而,朴素结合 GRPO 与 OPD 会导致性能下降,原因有三:并非所有样本都适合蒸馏;过快地拟合教师会削弱 RL 的探索能力;OPD 的优势不对称,抑制了大部分 token。为解决这些问题,我们提出 RSTG,选择性且精准地在关键位置应用蒸馏。在样本层面,OPD 仅用于零方差负样本组,并根据教师置信度加权;在 token 层面,仅针对高学生熵或高师生分歧的 token 进行蒸馏。此外,我们利用教师生成的正确轨迹进行 SFT 增强训练,在 RL 无梯度处注入正梯度信号。实验表明,RSTG 在数学和代码任务上分别比朴素 GRPO+OPD 提升 +4.02% 和 +3.05%。
论文精读
TL;DR RSTG 针对 GRPO 在零方差奖励组中梯度消失的问题,通过自适应教师引导,在样本和令牌级别精准蒸馏失败样本,恢复学习信号,显著提升数学与代码推理性能。
问题
问题背景
当前基于可验证奖励的强化学习(RLVR)已成为 LLM 后训练的标准范式,其中 GRPO 因其无需价值函数的优势被广泛采用。然而,GRPO 在奖励信号稀疏或组内响应奖励一致时梯度消失,导致学习停滞。
现有方法的局限
On-policy 蒸馏(OPD) 可通过教师模型提供 token 级的稠密引导,看似能弥补 GRPO 的缺陷。但直接将 OPD 与 GRPO 结合(naive GRPO+OPD)反而会使性能下降,根源有三:
- 样本层面:并非所有 prompt 均受益于蒸馏,不恰当施加 OPD 会引入噪声;
- 训练动态:过快拟合教师会削弱 RL 自身的探索能力,导致策略过早收敛至次优解;
- 优势不对称性:OPD 倾向于抑制大部分 token 的梯度更新,仅有少部分 token 获得有效学习信号。
为什么此问题重要
在数学推理、代码生成等复杂任务中,正负样本区分的稀疏性使得 RL 极难收敛。如何精确地在“失败处”(即负样本且奖励零方差的 prompt 上)恢复学习信号,并同时保持策略的探索性与多样性,是提升 LLM 推理能力的关键瓶颈。业界急切寻求一种自适应机制,让蒸馏在最需要的时刻与位置介入,而非全盘覆盖。
行业关联
类似 自动驾驶 中稀疏成功奖励下的学徒学习,需要借助专家示范提供稠密反馈,但过量模仿会阻碍车辆在长尾场景中的自主探索;本次工作本质上是在 RL 与模仿学习之间寻找动态平衡。
核心洞察
- RSTG 的核心设计是“在失败的地方蒸馏”:仅当 GRPO 中一个提示的所有响应获得相同奖励(负零方差)时,才引入教师模型的 token 级监督。这精准解决了 RLVR 中梯度消失的痛点,而非对全量数据进行无差别蒸馏。过去 OPD 与 RL 的简单叠加往往因过早拟合教师而损害探索,RSTG 通过样本级筛选(限制在负零方差提示)和教师置信度加权,将蒸馏信号定位在最需要梯度的样本上,避免了有效样本上的干扰,这是它大幅超越 naive GRPO+OPD 的关键。
- RSTG 在 token 级蒸馏中引入了双重门控:学生熵高或师生分布分歧大的 token 才被蒸馏。这打破了以往 OPD 对所有 token 均等施加监督的做法,有效缓解了优势不对称问题——教师对低不确定性 token 的约束反而抑制了 RL 的探索。通过有选择地传递知识,模型既保留了自主探索空间,又能在高不确定区域获得指导,平衡了 RL 的探索与 OPD 的收敛,这种细粒度控制为 RLVR 与蒸馏的结合提供了新的工程范式。
方法
方法输入与总体流程
RSTG 以一组提示(prompts)作为输入,由学生策略(待优化的 LLM)为每个提示生成多个响应,经由可验证奖励(如数学答案或代码测试)得到标量奖励。GRPO 基于组内相对优势计算策略梯度,但当组内所有响应奖励相同或全为零时,梯度消失——这类负零方差组(negative zero-variance groups)是 RSTG 需要重点恢复的学习信号来源。
关键模块
样本级选择与教师置信度加权(4.1 节) 仅对负零方差组开启 on-policy distillation(OPD)。蒸馏监督来自一个固定的教师模型,用于提供 token 级分布。为抑制低质量样本的噪声,每个样本的 OPD 损失按其教师模型下的置信度(如序列概率)进行加权,使教师更有把握的响应获得更高影响。
Token 级选择以避免过早收敛(4.2 节) 全部 token 参与蒸馏会让学生过快拟合教师,丧失 RL 的探索能力。因此,在负零方差组的响应内部,仅选择两类 token 施加蒸馏:
- 高熵 token:学生自身分布熵较大,表示不确定;
- 高发散 token:学生与教师的 token 分布 KL 散度超过阈值。 其余 token 不参与 OPD 计算,从而保留学生自身探索空间,缓解“不对称优势”问题(大多数 token 被蒸馏抑制)。
补充正监督(SFT on correct trajectories)(4.3 节) RL 对正向奖励的响应往往梯度为零(因基线较高),缺少正面强化。RSTG 额外使用教师模型主动生成正确轨迹(得到正奖励的响应),并用这些轨迹进行监督微调(SFT),注入正梯度。这让模型不仅从失败中学习,也能从教师模拟的成功中获取信号。
损失组合与输出
最终训练损失为:L = L_GRPO + β_OPD * L_OPD_selected + β_SFT * L_SFT,其中 L_OPD_selected 是按上述样本—token 两级选择后的蒸馏损失。模型更新后,策略在数学和代码任务上的探索能力与最终性能得到平衡。
与直接 GRPO+OPD 的差异:普通组合会不加区分地对所有 token 蒸馏,导致过早收敛并破坏 RL 探索;RSTG 通过“哪里失败就蒸馏哪里”的自适应选择,仅在必要时刻引入教师信号,并辅以正监督,将负、正信号分离处理,大幅提升了学习稳定性与最终效果。
实验
实验设计
实验在数学推理和代码生成两个任务上对比了 RSTG 与多个基线:GRPO、GRPO+OPD(朴素结合在线蒸馏)等。评估采用准确率指标,分别汇报数学和代码的提升幅度。
关键发现
RSTG 在数学任务上比 naive GRPO+OPD 提升 +4.02%,代码任务提升 +3.05%。分析揭示了朴素结合蒸馏失败的三个原因:(1) 并非所有样本都受益于蒸馏;(2) 过快拟合教师会削弱 RL 的探索能力;(3) OPD 的优势不对称,会压制大部分 token。RSTG 通过样本级选择(仅对负样本零方差提示进行蒸馏,并按教师置信度加权)和token 级选择(仅蒸馏学生熵高或师生分歧大的 token),精准注入学习信号。此外,额外使用教师正确轨迹做 SFT 补充正梯度,缓解了零方差组梯度消失问题。
与基线对比深度解读
naive GRPO+OPD 将蒸馏不加区分地应用于所有样本和 token,导致策略过早收敛至教师分布,牺牲了 RL 特有的探索优势,甚至因不对称优势而抑制有效学习。RSTG 则“缺哪补哪”,仅在 RL 信号失效(同一组内奖励全同)且学生模型迷茫(高熵或与教师分歧大)的位置介入,既恢复了梯度,又保留了 RL 策略的自主探索空间。这种自适应、最小化干预的设计,使得蒸馏真正服务于 RL 优化,而非替代 RL,从而实现了性能的实质性突破。
行业影响
落地场景
RSTG 主要受益于任何使用强化学习(RL)微调大语言模型(LLM)的产品或业务,尤其是奖励稀疏、容易产生梯度消失的任务。典型场景包括:
- 代码生成助手:在代码补全或代码生成服务中,运行测试用例获得二元奖励(通过/失败),常出现一组响应全错导致无有效梯度的情况。RSTG 可有选择地利用教师模型提供 token 级指导,提升错误样本的学习效率。
- 数学推理应用:教育或科学计算产品中,最终答案对错判定同样面临奖励稀疏,RSTG 能改善长链推理的中间步骤学习。
- 指令遵循与安全对齐:RLVR 中奖励函数往往只判断最终输出是否符合要求,RSTG 可在负样本中注入教师信令,强化部分正确但整体不合格的回应,提高模型对齐效率。
商业价值
- 降本增效:GRPO 中负零方差组浪费了大量计算,RSTG 将这些无效样本重新激活,显著加速收敛(论文中数学任务提升 4.02%,代码提升 3.05%),直接降低训练算力成本。
- 提升模型质量与用户体验:通过精准蒸馏,模型在复杂推理任务上性能更优,可增强对话助手、自动编程等服务竞争力,减少高频错误场景。
- 风险可控:RSTG 的样本和 token 级筛选策略避免了盲目蒸馏导致的过早收敛,维护了 RL 的探索能力,使模型既稳定又保持泛化潜力,降低线上事故风险。
与现有工作流的集成
RSTG 可无缝嵌入现有的 RLVR/GRPO 训练管道,无需大幅改动架构:
- 保留原 GRPO 的 rollout 流程,仅需额外部署一个教师模型(可与策略模型同源或更强的 LLM)。
- 训练时新增两个数据过滤器:
- 样本级:筛选奖励方差为零的负样本,并用教师置信度加权。
- token 级:针对高熵或师生分歧大的 token 施加蒸馏损失。
- 可配合 SFT 使用教师生成的正确轨迹,进一步稳定训练。
对现有 RLHF/RLVR 框架(如 TRL、OpenRLHF)只需增加少量适配模块,不影响已有超参数和日志系统。成本主要来自教师推理,但论文思路通过选择性蒸馏大大缩减了实际参与蒸馏的 token 量。
具体落地 Use Case
- 企业级代码助手:某代码平台的后训练环节,采用 GRPO 与可执行测试用例作为奖励。许多不通过的代码生成虽整体错误,但部分片断逻辑正确。使用 RSTG,教师模型对这些错误响应按置信度加权的 token 级蒸馏,促使学生吸收局部正确模式,提升最终代码通过率,减少用户重复提问。
- 教育数学解题应用:一款面向全球学生的数学辅导 App,用 LLM 生成分步解答,并通过最终答案比对给予稀疏奖励。RSTG 可识别学生模型在推导中途出现的正确中间步骤(由教师判断),仅对这些步骤进行蒸馏,在保持探索的同时快速提高解题正确率,降低服务器端重复调用的计算开销。
局限
- 论文仅在数学推理(GSM8K、MATH)和代码生成(MBPP、HumanEval)等可验证奖励场景下验证了RSTG,对其他任务(如开放式对话、长文本摘要)的泛化性未做探讨。这些任务中奖励信号的稀疏性和方差特性可能与当前设定不同,自适应教师指导是否依然有效尚不明确。此外,实验均基于单个基础模型(如Llama-3-8B)和固定教师(如DeepSeek-R1),未能评估不同师生组合下的性能鲁棒性,以及教师能力瓶颈对蒸馏最终上限的约束。
- RSTG引入了多个需要调优的超参数,如教师置信度权重、token选择的熵阈值和散度阈值、OPD与SFT的损失系数β等。虽然消融实验显示了各组件的重要性,但缺少超参数敏感性分析,实际应用中可能需大量实验才能找到合适配置。此外,方法在训练过程中需实时计算教师分布和token级统计量,增加了显存和计算开销,论文未对额外成本进行量化和优化讨论,可能影响其在资源受限环境下的实用性。
- 尽管RSTG缓解了naive GRPO+OPD的性能退化,但核心改进仍是针对负零方差样本的梯度恢复,本质上是对已有RLVR框架的修补。对于奖励稀疏的根本问题——例如完全错误的组如何获得有意义的学习信号——方法依赖于教师模型的质量,未能提出突破性的替代方案。与近期同时结合RL和蒸馏的工作(如ReST、SPIN)相比,RSTG的改进粒度更细,但整体范式并未跳出on-policy distillation的范畴。