3DZip: 面向3D问答的空间感知特征多样性引导的令牌压缩
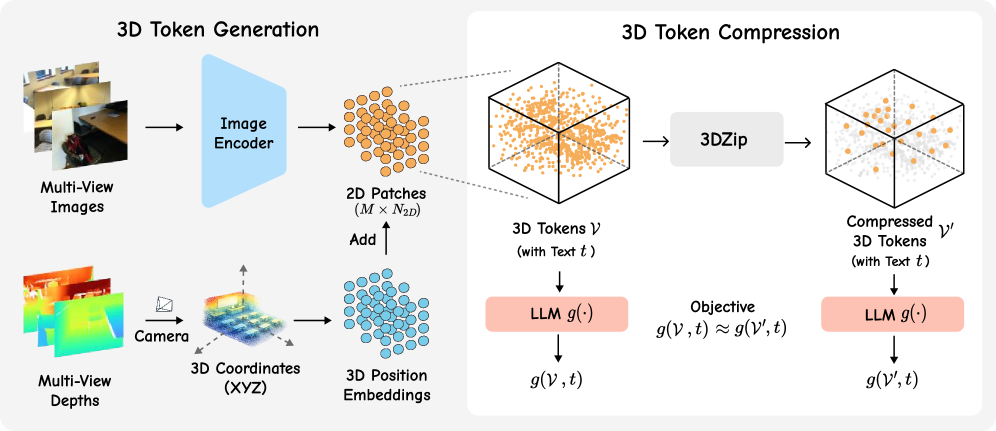
近期 3D 视觉语言模型(3D VLMs)通过将 2D 视觉特征投影到世界坐标来构建几何感知令牌,从而支持 3D 问答等任务的空间推理。然而,这种设计每场景生成数千个令牌,导致巨大的计算和内存开销。 虽然令牌压缩已在 2D VLMs 中得到广泛研究,但现有方法依赖语义相关性或基于注意力的选择,忽略了 3D 令牌的结构化空间特性。此外,仅靠空间邻近性无法解决 3D 表示中的冗余,因为即使在空间聚合后,对象级令牌不平衡仍然存在。 为此,我们提出 3DZip,一个三阶段令牌压缩框架: 1. 先应用粗体素化去除点级冗余; 2. 然后通过行列式点过程基于特征空间多样性选择锚点令牌; 3. 最后在空间约束下合并剩余令牌,以保持几何连贯性。 在三个 3D 问答基准上的实验表明,3DZip 始终优于现有压缩方法,仅用 128 个令牌保留 94.7% 的原始性能,推理速度提升 1.92 倍。
论文精读
TL;DR 3DZip 通过粗体素化、特征多样性选择和空间约束合并,将 3D VLM 场景 token 压缩至 128 个,保留 94.7% 性能且推理快 1.92 倍,解决了 3D 表示的点级和对象级冗余。
问题
问题背景
3D 视觉 - 语言模型 (3D VLM) 通过将多视图 2D 特征反投影到世界坐标,构建 几何感知 token,在 3D 问答、具身导航等空间推理任务中展现出强大能力。但每个场景生成的 token 数量通常高达数千,造成推理延迟和显存瓶颈,阻碍实时部署。
现有方法局限
主流 token 压缩技术(如 FastV、ToMe)源于 2D VLM,依赖注意力分数或语义相似性筛选关键 token,完全忽略 3D token 的结构化空间分布。直接套用会破坏几何一致性,导致空间推理退化。另一类基于空间体素化的聚合方法虽能消除点级冗余,但未能解决 对象级 token 分配不均衡——大物体表面往往保留过多 token,而小物体因聚合过度丢失细节,尤其在遮挡或长尾类别场景中表现明显。
为什么这个问题难且重要
3D token 冗余具有双重层次:
- 点级冗余:同一平面或光滑表面上的点 token 特征相近,可由少量代表点概括。
- 对象级冗余:不同物体对推理的贡献不同,统一空间聚合会导致关键物体欠采样、背景过采样。
兼顾这两者需要在 压缩率与几何/语义保真度 之间做精细权衡。随着 AR / 机器人等空间计算设备的普及,高效处理 3D 场景 tokens 成为决定模型能否在产品中落地的关键。业界对轻量化 3D VLM 的需求日益迫切。
行业类比
类似自动驾驶感知中,对激光雷达点云执行 特征压缩 以降低后端感知模型的计算负载——既要保留车辆、行人等关键物种的细粒度特征,又要丢弃无关环境点,从而在安全性和实时性之间取得平衡。
核心洞察
- 特征多样性驱动的 token 选择在 3D 空间内具有独特优势。传统压缩依赖注意力排序或语义相似度,而 3D 场景中物体间空间关系与外观多样性是关键。3DZip 通过 DPP 建模 token 间的特征多样性,确保选取的锚点 token 覆盖不同物体和区域,避免了冗余。这与仅依赖空间距离的合并方法形成鲜明对比,后者可能因物体内部 token 过多而丢失物体级信息。
- 三阶段流程将空间聚合与特征选择解耦,粗体素化先有效去除点云级别的冗余,然后 DPP 选择多样化的锚点,最后空间约束的合并维持几何结构。这种解耦使得各阶段可独立优化,且整个 pipeline 能有效平衡压缩率和信息保留。相比一步合并的方法,3DZip 的逐阶段处理更精细地控制了 token 的信息损失。
- 在极低 token 预算下仍保持高性能(128 token 达到原模型 94.7% 的精度),表明对于 3D VLM,少量精心选择的 token 就足以支撑空间推理。这提示工程部署时可通过智能 token 选择大幅降低计算需求,而不显著牺牲任务性能,为实时 3D 理解系统提供了可行方案。
方法
整体框架
3DZip 针对投影式 3D VLM 中每个场景生成上千个 token 的计算与存储瓶颈,提出一种三阶段压缩流水线:输入为通过 2D 特征投影到世界坐标得到的几何感知 token;经过粗体素化、特征多样性锚点选取、空间约束合并,最终输出一个紧凑的 token 子集(如 128 个)。
阶段一:粗粒度体素化(Coarse Voxelization)
原始 token 携带大量点级冗余——相邻点的特征几乎相同。该阶段将三维空间划分为固定大小的体素网格,对每个体素内的 token 特征进行平均池化(或 MLP 聚合),用单个体素 token 替代整组 token。这一步大幅削减点级冗余,将 token 数量压至数百量级,同时保留大致的几何结构。
阶段二:特征多样性锚点选取(Feature-Diversity Guided Anchor Selection)
剩余 token 仍然存在对象级不平衡——小物体 token 稀疏、大物体 token 密集,仅靠空间聚合无法解决。3DZip 引入行列式点过程(DPP),在特征空间中度量 token 间的相似性,通过最大化所选子集的多样性,自动挑选覆盖不同语义区域的锚点 token。相比基于注意力或语义相关性的选择,DPP 无需训练参数,且天然倾向于选出语义差异大的 token,避免同类重复。
阶段三:空间约束的 token 合并(Spatially-Constrained Token Merging)
未被选为锚点的 token 不能直接丢弃,否则丢失几何细节。该阶段根据空间距离,将每个剩余 token 合并到最邻近的锚点 token(如使用特征加权或注意力池化),且约束合并范围以防止跨物体融合。这一设计在保持几何一致性的同时,将信息浓缩至最终 token 集。
与同类方法的差异
不同于 2D VLM 中普遍采用的语义相似性剪枝或注意力分数排序,3DZip 显式建模 3D 空间结构与特征多样性,并通过三阶段渐进式压缩同时处理点级与对象级冗余,在极低 token 预算下仍能保持空间推理能力。
实验
实验设计
3DZip 在三个具身 3D 问答基准上评估:SQA3D、OpenEQA 和 ScanQA。实验将投影式 3D VLM(如 LLaVA-3D)作为骨干,应用三阶段压缩:粗体素化、基于 DPP 的多样性锚点选择、空间约束 token 合并。评估指标包括任务准确率和推理效率,设置不同 token 预算(如 64, 128, 256)与原始模型及现有压缩方法(如 FastV、ToMe)对比。
关键发现
- 在仅保留 128 tokens 时,3DZip 维持原始模型 94.7% 的性能,推理速度提升 1.92 倍。
- 相比基于语义或注意力的 2D 压缩方法,空间感知和特征多样性约束显著优于单纯空间聚合或随机选择。
- 消融实验证实:粗体素化有效去除点级冗余,空间合并保留几何一致性,避免对象级 token 不平衡。
- 定性分析显示压缩后 tokens 仍能覆盖场景结构的关键区域,支撑空间推理。
与基线对比的深层解读
现有 token 压缩在 2D VLM 中多依赖注意力分数或语义相似度,迁移到 3D 时忽略了几何先验。3DZip 的创新在于将点云结构化冗余分阶段处理:粗体素化先解决局部密集点的重复特征,然后用行列式点过程(DPP)挑选最具多样性的 tokens 作为锚点,保证覆盖不同对象和区域,最后在空间约束下合并剩余 tokens 而非简单丢弃,避免因过度压缩导致空间细节丢失。这比直接降采样或随机挑选能更好地保留对 3D 问答至关重要的空间关系,解释了为何 3DZip 在相同压缩率下远超基线。该框架对内存受限的端侧 3D 应用有实际指导意义,且各阶段可解耦便于调整以适配不同场景规模。
行业影响
落地场景
3DZip 直接服务于依赖实时三维场景理解的产品,典型场景包括:
- 具身智能与机器人导航:家用服务机器人或仓库物流机器人需根据 3D 环境回答自然语言指令(如“卧室的充电器在哪里?”),压缩 token 可大幅降低板载推理延迟。
- AR/VR 空间交互:头显设备在扫描房间后,需快速理解空间布局以响应用户提问(“桌子上的红色杯子还在吗?”),低延迟压缩能提升交互流畅性。
- 自动驾驶与车内助手:座舱内驾驶员可能用自然语言询问车身周围对象的空间关系,3D VLM 在高帧率下处理大量点云 token,3DZip 可保证实时性。
- 数字孪生与建筑信息模型:在大型建筑运维中,维护人员通过语音查询隐蔽管线位置,系统需即时压缩 3D 扫描 token 送入 LLM 推理。
商业价值
3DZip 的核心商业回报体现在 推理成本下降与硬件解锁:
- 推理成本直降:在保持 94.7% 原始性能的前提下仅用 128 token,推理速度 1.92× 提升。对于按 token 计费或 GPU 租赁的云端部署,这意味着相同服务质量下成本近乎减半。
- 硬件门槛降低:边缘设备(机器人、AR 眼镜)本就算力有限,3DZip 可将大型 3D VLM 压缩到实时可用的程度,使原本只能在云端运行的模型下沉到设备端,扩大潜在市场。
- 用户体验提升:低延迟响应是空间对话式 AI 落地的关键体验瓶颈,1.92× 加速直接将用户等待时间缩短近一半,显著提升产品可用性。
与现有产品/工作流的接口
3DZip 作为 token 压缩模块,可无缝插入现有 3D VLM pipeline:
- 即插即用:它作用于 3D VLM 的视觉编码器输出之后、LLM 输入之前,无需修改模型本体。与 LLaVA-3D、Video-3D-LLM 等主流框架兼容,可直接替换或补充其原有的 token 选择策略。
- 与 2D token 压缩互补:3DZip 专注空间结构,可与 FastV、TokenPacker 等 2D 语义压缩方法级联,进一步优化可视化 token 总量。
- 集成路径清晰:通过提供简单的 API 或库,开发者只需将原始点云 token 和 3D 坐标传入 3DZip,即可获得压缩后的 token 序列,再送入 LLM,无需改变推理服务架构。
具体落地 use case
1. 电商 AR 家具试摆助手 用户在手机或 AR 眼镜上预览虚拟家具时,可提问“这款沙发能放进我客厅沙发区和电视柜之间吗?”系统实时扫描房间生成 3D token,若直接送入 LLM 会导致高延迟。集成 3DZip 后,将数千 token 压缩至 128,在保持空间推理精度的同时实现近乎瞬时的回答,显著提升 AR 购物体验和转化率。
2. 自动驾驶远程接管辅助 远程安全员监控多辆自动驾驶车辆,通过语音询问某一车辆周围环境(如“左前方骑行者离本车有多远?”)。云端 3D VLM 同时处理多路点云流,需要极高吞吐。利用 3DZip 对每帧点云 token 进行压缩,可在不牺牲关键空间信息的情况下大幅提高并发处理路数,降低单路远程接管成本,使大规模车队远程支持成为可能。
局限
- **管道超参数依赖性强**:3DZip 的三阶段设计涉及体素大小、锚点数量、空间合并阈值等多个超参数。这些参数对场景规模、点云密度等属性敏感,在不同数据集或实际部署中需要重新调优,可能会降低即插即用的便利性,并增加工程适配成本。
- **DPP 计算扩展性存疑**:第二阶段利用行列式点过程(DPP)进行特征多样性驱动的锚点选择。虽然论文给出了运行时分析,但当输入 token 数量极大或场景非常复杂时,DPP 的矩阵运算开销可能显著增加,成为整个压缩管道的瓶颈,限制其在资源敏感场景下的应用。
- **仅针对投影式 3D VLM**:方法基于将 2D 视觉特征投影到世界坐标系的 3D VLM(如 LLaVA-3D 等),其 token 具有明确的几何属性。对于直接编码点云或体素的其他 3D 模型,该方法可能需要重新设计 token 构建方式,因此通用性受限,难以作为黑盒压缩插件迁移到所有 3D VLM 上。