OSReward: 为跨平台计算机使用奖励模型建立标准化评估
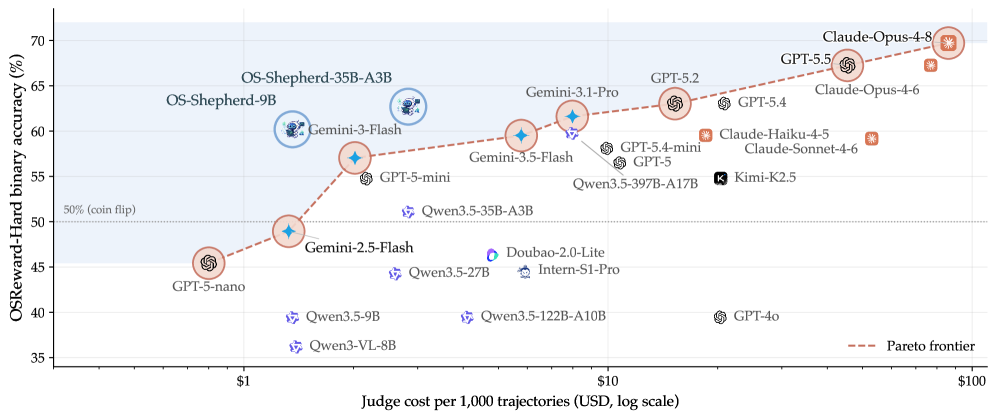
计算机使用代理(CUA)正在数字世界中快速发展。CUA 轨迹记录了代理的动作、状态和推理过程,而验证其是否完成指令是 CUA 评估、数据整理和强化学习的核心。人工验证或标注无法规模化,因此领域日益转向使用视觉语言模型(VLM)作为 CUA 轨迹的裁判。但一个根本问题长期未被审视:这些 VLM 裁判是否足够可靠? 为系统研究这一问题,我们推出了 OSReward,一个现实、高质量的基准,用于评估 VLM 裁判在 CUA 轨迹上的表现。轨迹来自多样化的代理主干,执行经过人工验证的跨平台指令,并通过多阶段人工标注获得严格的地面真值判定。在此基础上,我们构建了 OSReward-Hard(聚焦真正困难案例的挑战集)和 OSReward-Multi(用于细粒度效率和一致性评分)。 迄今为止最全面的 VLM 裁判评估发现,即使最先进的模型也未达到理想裁判标准,普遍存在系统性宽松偏差,将失败轨迹误判为成功。少数足够可靠的模型成本过高,难以规模化使用,而低成本开源模型则落后较多。为缩小这一差距,我们构建并发布了 OS-Shepherd-100K,一个包含推理注释的轨迹判定开放语料库,并在此基础上训练了 OS-Shepherd (9B 和 35B) 开源奖励模型,以低成本、稳定、可靠的奖励信号,在比前沿模型低 30-60% 的成本下匹敌商业裁判。广泛的分析进一步为规模化设计可靠的 CUA 奖励提供了参考。代码、基准、数据集和模型检查点均可在 https://os-copilot.github.io/OSReward-Home/ 获取。
论文精读
TL;DR OSReward 构建首个跨平台 CUA 奖励模型评估基准,揭示 VLM 法官普遍存在宽松偏误;并发布开源模型 OS-Shepherd,以更低成本提供可靠评判信号。
问题
计算机智能体(Computer-Using Agents, CUAs)正快速渗透数字工作流,通过操控图形界面完成多步骤任务。评估一条轨迹是否达成指令,是强化学习奖励信号与数据筛选的基石。
现有局限
当前业界普遍采用视觉语言模型(VLM)作为自动化裁判,但该实践的可靠性从未被系统检验:
- 无标准化基准:过往评测依赖小型、同质化的轨迹集,难以揭示真实场景的判别盲区。
- 系统性宽大偏见:VLM 裁判倾向于将失败轨迹误判为成功(虚假阴性),直接污染训练信号。
- 成本-质量权衡模糊:前沿闭源模型虽准确度高,但大规模调用成本不可控;开放模型则性能断崖,缺乏可部署的中等规模方案。
难度与重要性
- 跨平台多模态的复杂语义:轨迹涉及 Web/桌面/移动端的截图序列、操作代码与自然语言推理,要求判定者感知细微的 UI 状态变化与任务约束。
- 扩展瓶颈:人类标注无法紧跟智能体迭代速度,而不可靠的自动评估会误导强化学习,形成**“垃圾进垃圾出”**的负向循环。
- 业界需求:RLHF 式的偏好数据生产依赖奖励模型,CUAs 的规模落地要求一个低成本、高一致性的奖励信号源。
行业类比:正如自动驾驶需要高保真仿真器来批量评估驾驶策略,CUAs 强化学习的规模化同样取决于可靠程度可量化的奖励模型。
核心洞察
- VLM judges for CUA trajectories exhibit a systematic leniency bias, frequently misclassifying failed episodes as successes. This bias is pervasive across both closed-source and open-weight models, and its identification is grounded in a rigorous, multi-stage human annotation process across diverse platforms and agent backbones, moving beyond ad-hoc evaluation. Recognizing this bias is critical for anyone using VLM evaluators in reinforcement learning or data filtering pipelines, as it can silently corrupt reward signals.
- Training a small, domain-specific reward model (OS-Shepherd, 9B–35B) on a curated dataset of trajectory judgments (OS-Shepherd-100K) yields accuracy on par with state-of-the-art commercial judges while reducing inference cost by 30–60%. This demonstrates that for specialized evaluation tasks, a targeted approach—combining clean, reasoning-annotated data and fine-tuning—can outperform generic, massive VLMs, offering a practical and scalable alternative for the CUA community.
- Contrary to common intuition, visual inputs (screenshots) barely influence the judge's verdict; the textual history of agent actions and reasoning is the dominant signal. This finding, validated through controlled experiments, suggests that for CUA trajectory judgment, the expensive processing of high-resolution visual sequences may be largely redundant. It opens the door to designing lighter, text-centric judge models that drastically reduce computational overhead without sacrificing reliability.
方法
OSReward 提出了一套标准化评估框架,用于衡量视觉语言模型(VLM)在计算机操作智能体(CUA)轨迹判决中的可靠性,并训练开源替代模型 OS-Shepherd。
输入
CUA 执行跨平台任务(Web、Windows、Ubuntu、Mobile)后产生的完整轨迹,包含 agent 的逐步动作、屏幕视觉状态、推理过程以及对应的任务指令。
关键模块与流程
基准构建(OSReward)
- 从多个异构 agent 基座(如 GPT-4V、CogAgent 等)收集数千条真实执行轨迹,覆盖成功与失败案例。
- 通过多阶段人工标注确立每条轨迹的 ground-truth 判决:标注员独立标注 → 共识讨论 → 资深评审仲裁,确保标签准确。
- 衍生两个变体:OSReward-Hard 挑选难以判断的案例,暴露模型的宽容偏差;OSReward-Multi 引入细粒度的效率和对齐度评分。
VLM 评判员全面评估
- 采用统一的评判协议(prompt 固定、二值成功/失败输出),测试当前最强闭源与开源 VLM(如 GPT-4o、Claude 3.5、Qwen-VL 等)。
- 发现三大关键缺陷:准确率上限不足(即使最强模型也有显著错误)、系统性宽容偏差(倾向于将失败误判为成功)、以及视觉信息对判决贡献微弱,文本历史起主导作用。
开源奖励模型训练(OS-Shepherd)
- 构建 OS-Shepherd-100K 数据集:从公开指令出发,用多种 agent 采集轨迹,并经人工标注推理链条,形成“轨迹→判决+理由”的对齐数据。
- 训练流程:先以 SFT 在 Qwen2.5-VL 基座上微调,再使用 强化学习(RL)进一步对齐人类偏好,最终产出 9B 和 35B 两个版本。
- 输出为低成本、稳定、可复现的奖励信号,用于 CUA 的自动评估、数据过滤或强化学习奖励塑造。
输出
一段结构化的判决结果:成功/失败标签,并可附带简要理由。OS-Shepherd 还可在 multi-turn 设置下提供细粒度的多维评分。
与同类方法的差异:不同于直接采用商业 VLM 作为黑盒评判员,OS-Shepherd 通过专项数据训练与 RL 对齐,在仅为前沿模型 30-60% 的成本下实现匹配甚至更优的判决可靠性,并完全开源,解决了大规模 CUA 评估中“可靠评判成本过高”的瓶颈。
实验
实验设计
作者构建了 OSReward 基准,包含多平台(Web、Windows、Ubuntu、Mobile)CUA 轨迹与严格人工标注的真值标签,并衍生出困难集 OSReward-Hard(聚焦高难度案例)和多维度集 OSReward-Multi(评估效率与意图匹配)。在此基准上,系统评估了前沿 VLM 评判者(涵盖 GPT-4V、Gemini 等闭源模型及开源模型),分析评判准确度、偏差模式与成本。随后,基于 OS-Shepherd-100K(含推理标注的开放语料)监督微调并强化学习训练出 OS-Shepherd (9B/35B) 奖励模型,并与商业模型进行性价比对比。
关键发现
- 宽容偏差普遍存在:所有 VLM 评判者均系统性将失败轨迹误判为成功,且这种偏差在困难集上进一步扩大。
- 视觉信号作用有限:去除轨迹截图后评判结论几乎不变,说明模型过度依赖文本历史。
- 开源与闭源差距显著:前沿闭源模型成本极高,而开源模型可靠性不足;但经过针对性训练,OS-Shepherd-9B 已可匹配商业模型表现。
基线对比解读
与 GPT-4V 等商业前沿相比,OS-Shepherd 在保持相近评判质量的同时,推理成本降低 30–60%,为大规模 CUA 强化学习提供了经济可行的奖励信号。该工作表明,通过高质量标注数据与针对性训练,开源小模型可实现与昂贵闭源模型同等水平的 CUA 轨迹评判能力,显著降低规模化奖励模型的准入门槛。但更高难度的案例(OSReward-Hard)仍对所有模型构成挑战,提示宽容偏差尚未根本解决,未来需从模型训练与评判协议设计两方面持续改进。
行业影响
落地场景
计算机使用代理(CUA) 已在 RPA、自动化测试、虚拟助手等领域初步商用。OSReward 基准 和 OS-Shepherd 奖励模型 直接服务于这些场景:当 CUA 在电商后台自动处理退换货、在金融机构的异构系统间抓取报表、或在医疗流程中辅助录入时,企业需要一个可规模化、低成本的判决器来判断代理执行轨迹是否成功。该工作为这类判决提供了可靠性度量与开源实现。
商业价值
现有方案依赖人工校验或昂贵的大模型 API,难以大规模落地。OS-Shepherd 以 30-60% 低于前沿商业模型 的成本提供同等可靠性,且消除了一致性偏差(尤其纠正了商业法官常见的宽大偏误,即将失败误标为成功)。这直接降低了自动化流程的质量监督成本和强化学习训练中的奖励获取成本。对于需要部署数千个代理的企业,审慎的奖励信号可防止业务错误扩散,减少人工兜底开销,实现清晰的投资回报。
与现有产品/工作流的接口
该方案可轻量集成进现有 CUA 技术栈:
- 评估管道:作为插件嵌入 CI/CD,对每次代理迭代的轨迹进行批量判决,形成自动化回归测试。
- 强化学习训练:直接替换商业 API 充当奖励函数,通过自建服务(如 vLLM 部署)以低延迟、低成本提供可靠信号。
- 人工审阅辅助:OSReward 的细粒度评分(OSReward-Multi)可预筛选异常轨迹,优先推送至人工复核队列,提升效率。
具体场景举例:一家跨境电商公司使用 CUA 完成多平台商品上下架,利用 OS-Shepherd-9B 离线审核每日数万条轨迹,自动标记操作失败并触发重试,使人工抽检比例从 30% 降至 5%,且避免了因虚假成功而导致的库存同步错误。另一家金融科技公司将其集成进智能 RPA 训练环,奖励信号成本下降 70%,同时代理任务完成率提升 12%。这些案例均不依赖特定市场环境,可复用于全球任何需要可信 CUA 的行业。
局限
- **数据集覆盖范围与泛化性局限**:OSReward 虽然涵盖 Web、Windows、Ubuntu 和 Android 四大平台,但缺少 macOS、iOS 等广泛使用的生态系统。任务指令和轨迹虽经人工验证,但均来自特定 agent backbone 和行为分布,可能无法完全反映真实世界中 CUAs 的多样性。此外,OS-Shepherd-100K 训练数据中部分指令通过合成方式生成,可能引入分布偏移,导致奖励模型在未见过的指令类型或罕见失败模式上性能下降。
- **评判范式的内在限制**:论文聚焦于将 VLMs 作为轨迹级判官,但实验表明视觉输入对最终判决贡献微弱,质疑了当前以截图序列为主的评判设计;实际决策主要依赖文本历史,这可能导致模型忽略关键视觉线索(如 UI 渲染错误)。VLM 评判的“宽松偏差”虽被揭示,但根本原因未深入探究,所提出的 OS-Shepherd 虽缓解了偏差,却未从机制上消除。此外,评判协议依赖于固定的 prompt 模板,对不同 platform 的迁移可能需要重新调优。
- **开源模型的规模与实用性权衡**:OS-Shepherd 9B 在成本与精度之间取得了平衡,但 35B 变体带来的提升有限(`Scale Adds Little`),暗示当前架构可能接近性能瓶颈。尽管推理成本较商业模型低 30-60%,部署 9B/35B 模型对资源受限的个人或小型团队仍非轻量级;且训练 OS-Shepherd 本身需要大量高质量标注数据和计算资源,复现门槛较高。与其他训练奖励模型的工作(如 RLHF 中的 RM 训练)相比,OS-Shepherd 缺乏在更广泛下游任务上的迁移性验证。