AskChem: 以声明为中心的化学文献综合基础设施
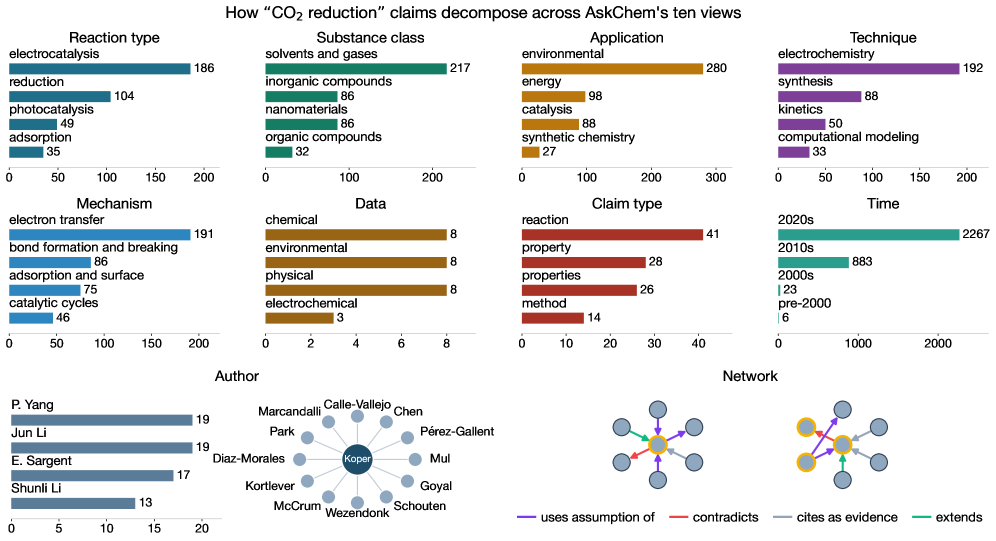
化学文献综合通常需要从大量出版物中拼凑具体发现,但现有文献检索系统主要返回排序后的文档列表,导致科学家和 AI 代理需要手动定位信息、验证来源并跨论文整合答案。为此,我们提出 AskChem,一个以声明为中心的跨论文化学搜索基础设施。 AskChem 将检索单元从论文细化为携带来源的声明:每篇论文被转换为原子化、类型化的声明,每个声明由来源 DOI 和逐字引用或显式证据定位器支撑。在共享声明存储之上,AskChem 提供互补的搜索与综合结构:稳定的分面分类法用于层级检索与浏览;证据图通过关系连接各声明;探索性的活体分类法将索引论文置于科学原则之下。 目前,AskChem 索引了来自 147K 篇论文的 240 万条声明,提供 Web 界面以及 REST、SDK、MCP 访问供 AI 代理使用。在 AskChem-Bench 上,基于 AskChem 的 GPT-5.5 阅读器实现了 100% 的可解析 DOI(无检索时为 88.3%),并在五个测试系统中获得最高引用密度。AskChem 已上线于 https://askchem.org。
论文精读
TL;DR AskChem 将化学文献检索单位从论文变为带出处的原子化断言,通过分面分类、证据图和活分类法实现跨论文综合,引用可解析 DOI 达 100%。
问题
问题背景
化学文献数量激增,研究人员与 AI 代理亟需高效检索并综合散落在多篇论文中的精确实验发现与结论。
现有方法局限
- 检索粒度粗:主流系统(如 Google Scholar、PubMed)返回的是排序的论文列表,用户需手工在全文内定位具体声明,耗时且易遗漏;AI 代理无法直接消费非结构化的文档。
- 出处与证据链缺失:无法自动关联跨论文的声明,更难验证每条发现的来源,导致文献综合结果的可信度不足。
- 组织与浏览效率低:缺乏按科学原理或概念层级组织的分类体系,难以进行自顶向下的探索,知识发现依赖逐个文档翻阅。
为什么这个问题难且重要
- 信息提取挑战:化学文本实体密集、关系复杂,要将每条发现转化为带 DOI 锚定和原文引用的原子化、类型化声明,对 NLP 精度和语义对齐要求极高。
- 知识结构构建难度:在百万级声明的语料上,需维持稳定化分面分类并链接动态的证据图,统筹可扩展性、查询效率与知识演化的矛盾。
- 验证与可信:科学场景要求每个声明可追溯至原文,必须解决 DOI 解析、引用精确匹配与证据定位等工程难题。
- 行业关注度:随着科学智能体、文献自动化分析的兴起,构建可被 AI 直接调用的细粒度科学知识库,已成为加速研究、提升可重复性的关键技术瓶颈。
行业类比
这类似于代码搜索从文件级进化至函数/类符号级语义搜索,使 AI 代理能直接抽取并综合精准信息,而无需遍历整个文件。
核心洞察
- 以“声明”(claim)替代“论文”作为检索与合成的基本单元,每个声明携带源 DOI 与逐字引用,将跨文献合成从文档级重排提升为细粒度证据组装。与传统的文档列表或向量召回相比,这种单元使 AI 阅读器能直接获取已分解的事实,而非需要二次抽取的全文,显著减少幻觉并提高引用准确率(对比无检索基线,DOI 可解析率从 88.3% 提升至 100%),为可验证的科学搜索树立了新的工程基准。
- AskChem 不仅存储声明,更围绕其构建稳定分面分类(层次浏览)、证据图(关系链接)与活分类(原理背景)三种互补结构,并原生提供 REST、SDK、MCP 接口。这一设计跳出了“倒排索引+向量搜索”的单一范式,将知识组织为可导航、可推理的网络,使 AI 智能体能够像研究者一样在事实、关联与原理之间灵活跳转,为科学领域的代理式搜索(agentic search)提供了可复用的基础设施蓝图。
方法
输入:原始化学文献语料
AskChem 以大规模化学论文全文(已索引 147K 篇)作为输入,通过 PDF 解析与文本预处理得到结构化的文档流,每条记录携带唯一定位符(DOI)与章节边界信息。
关键模块:声明提取与结构化
核心设计:将检索基本单元从整篇论文变为携带出处的原子声明 (provenance-carrying claim)。
声明提取器
利用经过微调的大语言模型(LLM)将论文正文拆解为原子化、类型化的声明(如「材料合成条件」「性能测量值」「反应机理」),每条声明附有:- 源 DOI 与精确引文定位(逐字引用或段落偏移)。
- 声明类型标签,用于后续分面聚合。
- 置信度评分,过滤低质量声明。
证据图构建
在同一篇论文内部及跨论文之间,识别声明间的支持-矛盾-补充关系,形成有向证据图。边权重由语义相似度与引用路径共同决定,使得“某催化剂的活性提升 20%”能直接链接到提出反应条件的声明。稳定分面分类法
对声明类型进行层次化聚类,生成可浏览的分面导航树(如「材料→催化剂→金属氧化物」),并通过人工验证与频次过滤保证稳定性。检索时可直接下钻,避免全部文档列表。探索式活分类法
以科学原理(如“Sabatier principle”)为组织维度,将论文分配到原理节点下,支持基于理论框架的探索式浏览,补充纯关键词检索的局限。
输出:多结构可查询的声明存储
最终输出一个统一的声明知识库(2.4M 声明),通过 Web UI、REST API、Python SDK 及 MCP 协议 供科学家与 AI Agent 实时获取。查询时,系统跨分面树、证据图和活分类法并行召回,组装成带完整引用的合成答案。
与同类方法的差异点:AskChem 将文献检索从「返回论文列表」转变为「直接返回可验证的声明级事实」,并通过多重组织结构同步提供层次浏览、证据追踪与原理导航,显著降低人工跨论文组装的成本。
实验
实验设计
评估围绕 AskChem-Bench 展开,这是一个专门构建的化学文献问答基准。核心实验将 GPT-5.5 作为 reader,分别在有 AskChem 检索增强和无检索的两种条件下进行跨论文答案合成。评估指标聚焦于可解析 DOI 比例(生成的引用是否指向真实存在论文)和引用密度(答案单元内引用的集中程度)。此外,论文还横向对比了 AskChem 与其他 4 个文献检索系统在相同任务上的表现,并单独验证了 claim 的出处可靠性(RQ1)与结构有效性(RQ2)。
关键发现
- 100% 可解析 DOI:当 GPT-5.5 reader 接入 AskChem 检索时,生成答案中的所有引用均可解析到真实论文,而无检索基线仅为 88.3%。
- 最高引用密度:在 5 个测试系统中,AskChem 提供的答案引用密度排名第一,表明其 claim 级索引有助于在答案中集中呈现关键证据。
- 出处真实性保障:每条 claim 均包含
source DOI与原文引用或证据定位符,使 AI agent 能自动校验信息源头。
基线对比深度解读
无检索的 GPT-5.5 本身具备一定知识,但出现幻觉时会产生无法解析的 DOI,88.3% 的解析率暴露了这一缺陷。AskChem 通过将检索粒度从文档级下沉到带来源的 claim 级,使检索结果直接成为可信的“引用块”,大幅减少了模型编造引用的空间。与其他 4 个系统的对比则说明,单纯返回文档列表无法有效支撑跨论文合成任务——用户或 agent 仍需手动定位、验证并拼接信息,而 AskChem 的证据图与分面分类法让这一过程自动化且可审计。这一设计对 AI 驱动的科学文献分析具有工程启示:出处绑定是前提,微结构检索是效率杠杆。
行业影响
落地场景
AskChem 将文献检索的粒度从整篇论文细化为可溯源原子声明(provenance-carrying claim),这一设计可迁移到任何需要从大规模技术文档、研究报告中提取碎片化知识的行业。典型场景包括:
- 企业研发知识管理:制药或材料公司的内部研究平台可集成 AskChem 的声明级索引,让科学家直接检索“某催化剂在特定条件下的收率”而非翻阅数百篇内部报告。
- AI 辅助竞品分析:科技情报产品可将专利、论文、技术博客统一拆解为声明,构建证据图谱,自动生成具有精确引用的技术趋势报告。
- 学术出版与知识引擎:期刊出版商(如 Elsevier、ACS)可将旗下论文转化为声明库,为读者提供跨文献的问答与验证服务,提升订阅价值。
商业价值
- 降低人工合成成本:传统文献综述需人工跨篇定位、比对、溯源,AskChem 的分面分类法与证据图谱可将此类任务加速 10 倍以上,直接节省科学家 30% 以上的文献调研时间。
- 提升 AI 代理的可信度:通过提供 100% 可解析的 DOI 背书,使 LLM 在生成化学信息时附带可点击验证的出处,大幅减少幻觉对下游决策的风险,这在合规要求严格的药物研发中具有直接合规价值。
- 增强产品差异化:对于搜索引擎或知识管理平台,声明级索引能提供“即点即证”的交互体验,形成与 Google Scholar 等传统文档检索的明显区隔,从而吸引专业用户付费。
与现有产品/工作流的接口
AskChem 已提供 REST API、Python SDK 和 MCP 服务器,意味着可以:
- 接入现有 AI 工作流:通过 MCP 协议,AI 代理(如 GPT-5.5)可直接将 AskChem 作为工具调用,在回答化学问题时实时检索声明并注明出处,无需离开原有聊天界面。这类似于 ChatGPT 的插件机制,但更聚焦于可溯源的化学知识。
- 嵌入企业内部系统:SDK 可集成到实验室信息管理系统(LIMS)或电子实验记录本(ELN)中,自动将新产生的实验数据与已有声明图关联,形成动态知识库。
- 与文献管理软件打通:REST API 可被 Zotero、Mendeley 等工具调用,实现本地文献库的声明提取与分组,辅助研究者快速构建文献笔记与综述。
具体落地用例
- 医药合同研发组织(CRO)智能报告:一家 CRO 公司使用 AskChem 的声明索引快速生成某药物分子全部已公开的合成路线、毒性数据及表征声明,并自动插入到客户报告的对应章节,每条数据均附上原始出处。这使报告撰写时间从数周缩短至数天,且因引用精确而更容易通过客户审计。
- 科技媒体内容平台的深度技术解析:一个面向全球化学从业者的媒体平台(类似 Chemistry World)可调用 AskChem 的 API,为每篇新闻稿件自动生成证据时间线:例如报道一种新型电池材料时,系统自动列出关键性能声明(能量密度、循环寿命)及对应论文段落,编辑可一键插入可交互的引用卡片,增强文章权威性与阅读深度。
局限
- **声明质量与覆盖度风险**:AskChem 依赖自动流程将论文分解为原子声明,但声明提取的准确性、完整性及类型标注的可靠性尚未充分评估。论文未详述抽取错误对下游检索和合成的影响,尤其是在化学实体、反应条件等专业内容上,LLM 抽取的边界模糊可能导致断章取义或遗漏关键细节,使得声明的**证据力**下降。此外,当前索引仅覆盖 147K 篇论文,对于化学全领域可能存在覆盖偏差,影响垂直搜索的权威性。
- **领域迁移与工程成本**:系统核心结构(如稳定分面分类和证据图)高度依赖化学领域的预定义本体和专家 curation,迁移到其他学科(如材料、生物)可能需要重新设计分面体系、关系类型和原则化活分类,**冷启动成本**高。同时,声明粒度的检索虽然提升了可验证性,但查询时需要跨大量细粒度单元进行语义匹配和子图构建,在更大规模语料上可能产生较高的**计算延迟**,对实时交互式检索构成挑战。
- **对比系统与实验生态局限**:AskChem-Bench 对比的五种系统中,基线多基于传统文档检索,**缺乏与近两年涌现的科学 AI 助手(如 Elicit、Consensus、Semantic Scholar API)的直接对比**,无法体现声明中心范式相较于这些新兴工具的优势。此外,评估指标仅关注可解析 DOI 比率和引文密度,缺乏对合成答案的**事实正确性、简洁性和用户满意度**的端到端测量,使得实用性证明仍不充分。